如何读懂 AI 产业链
一、一句话回答
把 AI 当成一条从一度电、一颗芯片一直延伸到模型 API、手机和机器人的完整产业链,分七层自下而上读;读的时候同时盯住「资金」和「数据」两条往回走的流;对每个节点用统一的三件套提问——技术成熟到哪一步(TRL)、钱被谁赚走、未来 6/18/36 个月会怎样并标置信度。掌握这套方法,你就不会被单个明星公司和精确报价牵着走,而能横向比较任何一个环节。
为什么要专门写一篇「怎么读」。这个专栏有八十多篇文章,覆盖的东西从电网、光刻机一直到人形机器人,如果一篇篇孤立地看,很容易迷失在细节里:今天记住了某张卡的算力,明天又冒出一个新的互联协议,最后只剩一堆零散事实。产业链分析的价值不在记住多少参数,而在建立一个稳定的坐标框架——任何新闻、任何公司放进来,你都知道它在哪一层、受谁制约、在跟谁分钱。这篇文章就是把这个框架一次讲透,后面所有文章都是它的具体填充。
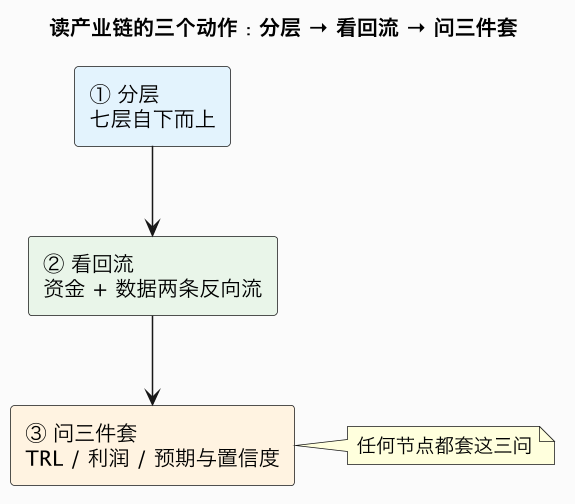
二、第一步:把链条分成七层
产业链不是一堆公司的平铺,而是有明确上下游顺序的价值叠加:下一层的产出是上一层的投入,价值沿着链条一路累加。读任何一条消息,先判断它属于哪一层。
| 层 | 名称 | 这一层在解决什么 | 典型对象 |
|---|---|---|---|
| L1 | 能源与电力 | 有没有电、能不能散热 | 电网接入、核电、液冷、UPS、东数西算 |
| L2 | 封装与芯片 | 算力能不能造出来 | CoWoS、HBM、GPU、自研 ASIC、推理芯片 |
| L3 | 集群互联 | 单卡怎么连成万卡集群 | NVLink、InfiniBand、以太网、光模块 |
| L4 | 软件与模型 | 硬件怎么变成智能 | CUDA、推理引擎、开源/闭源大模型 |
| L5 | 云与数据 | 模型怎么变成可调用服务 | 公有云、算力云、数据标注、训练数据 |
| L6 | 应用 | 智能怎么解决具体问题 | AI 编程、AI 搜索、Agent、垂直 SaaS |
| L7 | 终端与具身 | AI 落到什么物理形态 | 手机、PC、自动驾驶、人形机器人 |
本专栏实际还单独拆出了「半导体上游」(设备、材料、代工、EDA)作为 L2 的更底层供给,因为它决定了芯片造不造得出来;为了阅读时不被层数绕晕,正文用主题组织,心里记住「芯片之下还有一层制造」即可。
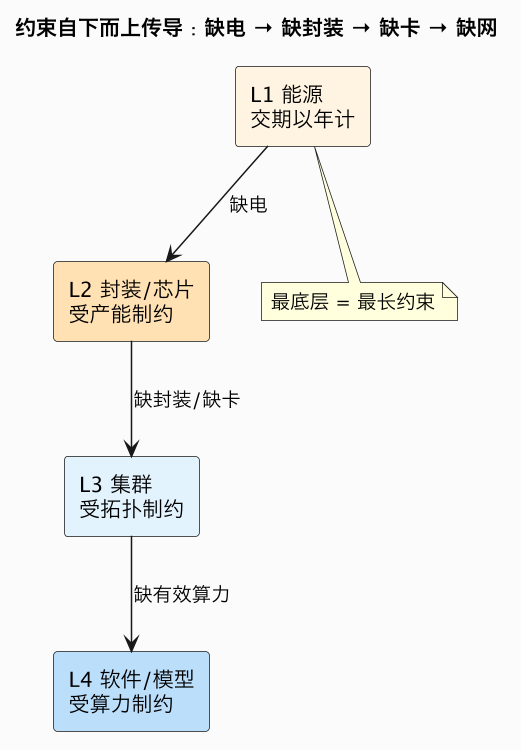
这七层的顺序为什么不能乱。因为约束总是从最底层向上传导:最底层的能源电力,建一座变电站、拉一条专线要按年计,不是砸钱就能加速,所以它是整条链最长的约束;往上,先进封装(CoWoS、HBM)的产能决定了能交付多少张卡;卡造出来还要靠高速互联连成集群,网络拓扑直接决定有效算力(MFU,Model FLOPS Utilization,模型算力利用率);软件与模型才把硬件真正激活;云与数据把模型变成服务;最终在应用和终端产生收入。任何一层卡壳,都会顺着链条往下放大——理解了这个传导方向,你就能判断一个「缺货」新闻到底是短期扰动还是结构性瓶颈。
三、第二步:盯住两条反向流
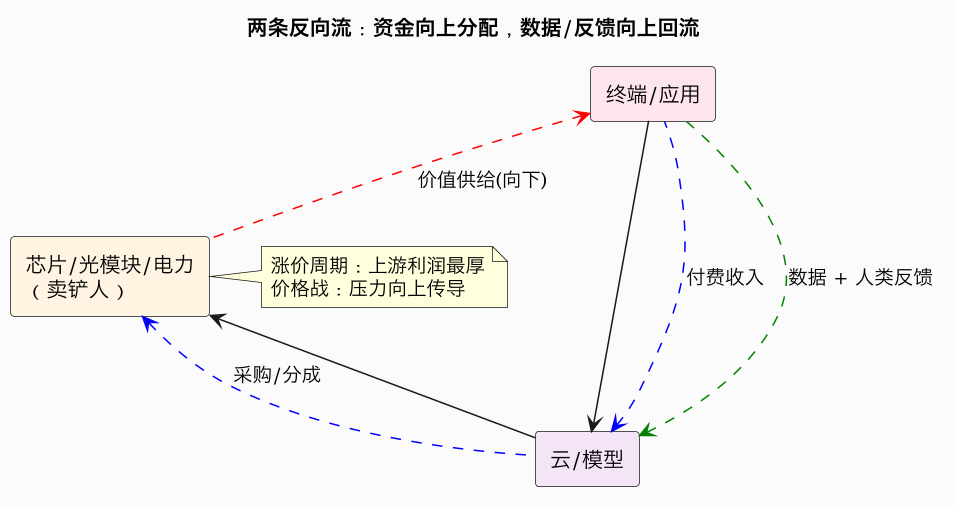
只看正向的价值叠加还不够,产业链里有两条往回走的流,它们决定了谁真正有话语权、能不能持续进步。
第一条是资金回流。 钱不是从芯片厂开始的,而是从最上层的应用和终端流入:用户和企业为 AI 产品付费,收入经应用、云、模型层层向上分配,最终才到芯片、光模块、电力这些「卖铲人」手里。读懂这条流,你就能解释两个反复出现的现象——为什么在涨价和缺货周期里,卖芯片、卖光模块的上游公司利润最厚(它们掌握稀缺供给,议价权最强);为什么一旦进入价格战,压力会沿链条向上传导,挤压中间环节的毛利。瓶颈沿正向传导,利润沿反向流动,这是整套框架里最值得记住的一句话。
第二条是数据与人类反馈回流。 终端的真实使用会产生数据,而用户对回答好坏的反馈(RLHF,Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)会回流到模型侧,成为下一轮迭代的燃料。这解释了为什么「数据墙」「越用越聪明」「端云协同」被反复讨论——拥有更多真实使用场景的公司,能拿到更多反馈,模型迭代更快,进而吸引更多用户,形成自我强化的飞轮。看一家模型公司的长期竞争力,不能只看当前榜单,更要看它有没有稳定的数据与反馈来源。
四、第三步:对每个节点问三件套
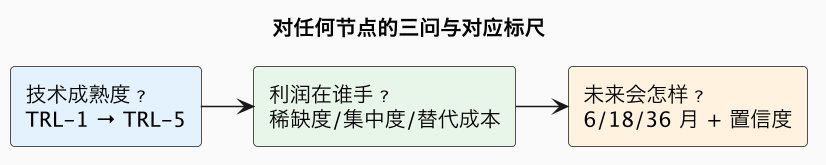
分层和回流给了你地图,具体到任何一个节点(一家公司、一种技术、一个环节),用统一的三个问题去拆,就能横向比较。
| 问题 | 在问什么 | 用什么标尺 |
|---|---|---|
| ① 技术成熟到哪一步 | 是实验室原型,还是已规模商用 | TRL-1 到 TRL-5 五级 |
| ② 钱被谁赚走 | 这一环的利润池和议价权在谁手里 | 稀缺度、集中度、替代成本 |
| ③ 未来会怎样 | 6/18/36 个月分别可能发生什么 | 预期 + 高/中/低置信度 |
关于 TRL(Technology Readiness Level,技术成熟度),本专栏统一用五级:TRL-1 是只有论文和原型的实验室阶段;TRL-2 是能演示、在内测但没有规模客户;TRL-3 是已有付费客户、但产能和生态还没铺开的早期商用;TRL-4 是大规模交付、主流客户采用的规模商用;TRL-5 是产品标准化、靠价格和份额竞争的成熟红海。标尺的完整解读见 TRL 成熟度标尺。
关于预期与置信度,一律分三档时间窗:6 个月是已经在产品路线图或产能排期里、能见度高的确定性事件;18 个月是下一代产品和产能的投放周期,判断较可靠;36 个月是格局级变化,只能给方向、必须标低置信度。置信度高意味着有公开披露和多方交叉验证,中意味着合理推断或单一来源,低意味着依赖不确定变量的前瞻判断。这套纪律的作用是防止把猜测说成事实——越是远期、越是精确的数字,越要警惕。
五、几条防止读偏的纪律
掌握了框架,还要避开几个新手最容易踩的坑。
- 别只看最风光的中间层。 GPU 和大模型最吸引眼球,但真正决定节奏的往往是底层的慢变量——电力、封装、设备。只盯着明星产品,会在「为什么又缺货」上反复意外。
- 别把制程几纳米当成唯一标尺。 一颗 AI 芯片的竞争力由算力、显存容量、显存带宽、片间互联和软件生态共同决定,制程影响功耗和频率,却无法单独决定胜负。
- 数字记区间和量级,不记精确报价。 卡价、电价、份额随时间和采购规模大幅波动,精确数字很快过期;记住量级和趋势才不会被过时信息误导。
- 训练和推理是两本账。 训练追求极致互联和长期稳定,生态门槛最高;推理更看重单位 token 成本和延迟。两本账的评价标准不同,格局也因此分化。
- 先分清「事实 / 推断 / 立场」。 厂商披露、分析师预测、媒体转述的可信度完全不同,尤其要警惕只引用单一来源却给精确结论的内容。
常见误区
- 把产业链当公司排行榜:只记得谁市值高,却看不懂上下游约束,结果对格局变化毫无预判。
- 认为越靠上游越赚钱:上游利润厚是在缺货涨价周期;一旦需求转弱、进入价格战,重资产的上游同样承受最大的周期下行压力。
- 套用 TRL 却忽略中国市场的特殊性:某些技术在全球口径下已 TRL-5,但在中国可能因管制而出现独立的国产替代周期,需要分两套体系看。
- 用静态地图套快速变化:七层结构稳定,但层与层的边界在变(如云厂商向下做自研芯片、英伟达向上做整柜和云),地图要定期更新。
总结
读懂 AI 产业链靠三步:把链条分成自下而上的七层、盯住资金与数据两条反向流、对每个节点用「TRL 成熟度 / 利润归属 / 6·18·36 个月预期加置信度」三问;核心是建立可复用的坐标框架而非记忆参数——瓶颈沿正向传导、利润沿反向流动,看清这两条,八十篇文章就有了共同的骨架。