AI 编译器之战:XLA、TVM、MLIR、Triton 与去 CUDA 化的软件轴
最后更新:2026-09-20|数据截止 2026 年中:各框架与编译器为快速演进的开源项目,具体能力与后端支持以官方仓库为准;本文讲技术分工与产业格局,不比较未经实测的性能数字。
本文是产业观察,回答一个被「显卡之争」掩盖、却决定国产芯片能不能真正用起来的问题:同一个模型,凭什么能跑在五花八门的 GPU、ASIC、NPU 上;在 CUDA 之外,谁在悄悄修筑另一条软件生态的轴。 硬件卡位见 CUDA 护城河 和 英伟达整柜战略,本文专注它们下面那层「把模型翻译成芯片指令」的软件——AI 编译器。它是 推理引擎之争 的底层工具,也是国产替代最难、最值钱的一环。
先说结论
- AI 编译器干的是「翻译 + 优化」:上层框架描述计算,下层芯片各有指令集,中间必须有一层把模型降级、融合、调度、映射到具体硬件。 没有这层,每出一种新芯片就要重写所有模型。
- 几大技术不是简单竞争,而是分层叠放。 XLA 是大厂图编译器;TVM 走「自动调优+多后端」开源路线;MLIR 是「搭编译器的编译器基础设施」;Triton 选了更高抽象层,用类 Python 写算子、编译器生成高性能 kernel,成了事实标准。
- Triton 是这几年最关键的变量。 它把写高性能 kernel 的门槛从「精通 CUDA 的少数工匠」降到「普通算法工程师」,又天然支持多后端——恰好是英伟达之外芯片最想要的:一条绕开 CUDA、又能让算子生态自动迁移的路。
- 对国产芯片,流片只是入场券,编译器和算子库才是生死线。 客户为「主流模型开箱即用、性能调到位」付费,不为理论算力付费;谁能让 PyTorch 模型低成本迁移、性能损失小,谁才进得了采购清单。
一句话:如果说 CUDA 是英伟达锁住用户的墙,AI 编译器就是大家合力在墙下挖的隧道——谁能让「写一次、到处高效运行」真正成立,谁就能松动硬件锁定,而 Triton 和 MLIR 是这条隧道目前最热闹的两个掘进面。
一、为什么 AI 需要专门的编译器
传统编译是把 C++ 翻译成 CPU 机器码,AI 更麻烦:上层是 PyTorch 里一张张算子组成的动态计算图,下层是成千上万个并行核心和复杂存储层次。直接一一对应过去,效率惨不忍睹,编译器要在中间做一堆「人写不过来、机器擅长」的优化。
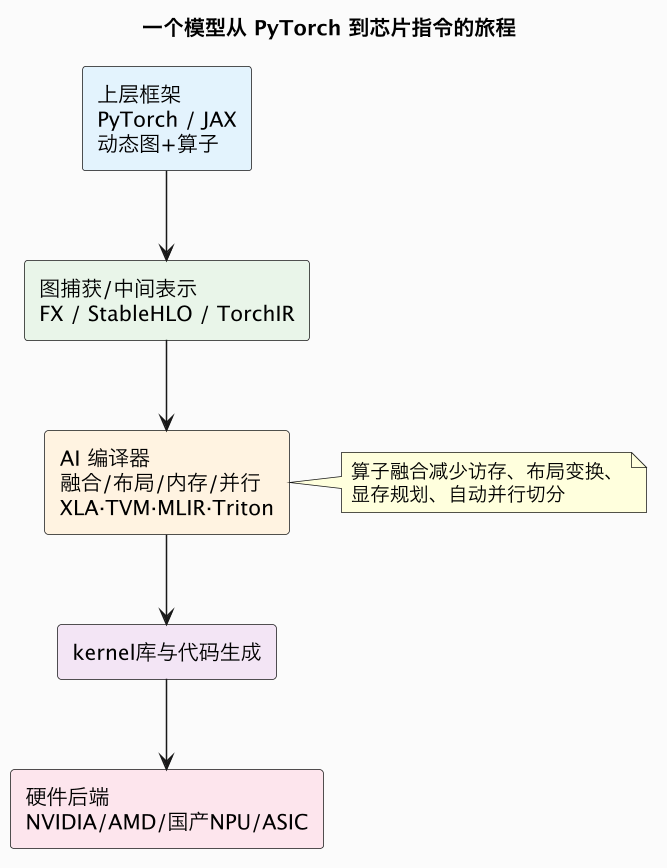
几类典型优化,正是国产芯片性能差距的常发地带:
- 算子融合:模型里大量「乘—加—激活」相邻运算,若每步都单独读写显存,时间全耗在搬运上。融合成一个 kernel、中间结果留在高速缓存,能大减访存——而访存常才是瓶颈(KV Cache 经济性 讲带宽如何决定推理成本)。
- 数据布局与内存规划:NHWC/NCHW 排布、张量在多层存储怎么摆,对性能影响巨大。
- 自动并行切分:把大算子映射到成百上千核心,怎么切、怎么同步,需与 整柜 Scale-Up 域协同。
- 面向硬件调优:不同芯片张量核、向量单元、片上缓存各异,同一套高级代码要生成贴合各家微架构的指令,这是多后端最难也最值钱处。
AI 编译器就是把「模型的数学表达」与「芯片的物理现实」对接的那层软件;只要这层足够强,上下两边就能解耦,这正是去 CUDA 化的工程支点。
二、XLA、TVM、MLIR、Triton 什么关系
它们常被并列成竞品,其实处在不同层次,更多是叠放借力。不精确但好记:XLA 像为大厂主力模型修的高速公路,TVM 像「什么车都能改、什么路都能上」的改装方案,MLIR 像生产修路机械的母工厂,Triton 则像让普通人也能开高性能赛车的自动挡。
| 技术 | 层次 | 核心定位 | 发起方 | 产业意义 |
|---|---|---|---|---|
| XLA | 图编译器 | 对 JAX/部分 PyTorch 整图优化与代码生成 | 大厂模型加速底座 | |
| TVM | 端到端编译器栈 | 多后端 + 自动搜索调优 | 学术/开源 | 一份模型上大量异构硬件 |
| MLIR | 编译器基础设施 | 可扩展多层 IR 与方言框架 | Google/开源 | 「搭编译器的编译器」 |
| Triton | 算子级语言/编译器 | 类 Python 写 block 级 kernel | OpenAI 发起、现开源 | 降算子门槛,天然多后端 |
- XLA:在 JAX 生态近乎默认引擎,也经 torch.compile 服务 PyTorch,强项是拿到整段图做跨算子全局优化,适合规整的大规模训练/推理,证明了 JIT 编译计算图在工业界可行。
- TVM:雄心是让一份模型编译到 CPU、GPU、各类 NPU,并用自动搜索(AutoTVM/Ansor)搜出近专家手调的调度。在边缘端和国产/小众芯片影响深远,是缺少自研编译器团队的硬件厂快速获得软件支持的捷径;但在最前沿大模型、最新硬件上,全自动常仍追不上专家手写与厂商深度定制。
- MLIR:不是成品编译器,而是造编译器的母机,提供可扩展多层 IR 与「方言」机制、逐级降级。它显著降低了为新芯片做高质量编译器的门槛,不少国产加速器编译器栈就建在 MLIR 上复用成熟优化设施,而非从零造轮子。
- Triton(最关键变量):写高性能 CUDA kernel 长期是少数工匠的专利(手工管线程块、共享内存、流水线)。Triton 让程序员只描述「每 block 算什么」,底层映射交给编译器。结果是写算子门槛骤降、生态算子快速增多,且后端不绑死英伟达、社区在为各家芯片加后端,于是出现一条极富想象的路径——海量 Triton 算子可相对低成本移植到英伟达之外硬件,而不必逐个重写 CUDA。
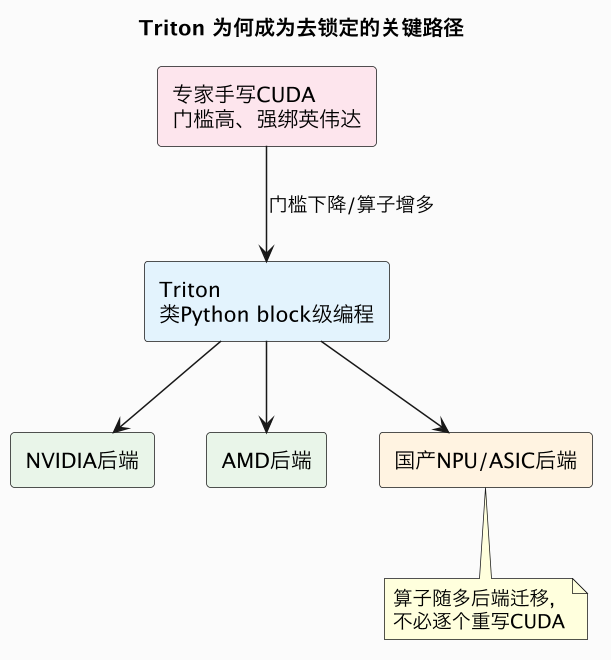
也要泼冷水:Triton 不是万能钥匙。最尖端的定制注意力、MoE 通信融合 kernel 仍常需专家手写或厂商库,非英伟达后端的覆盖率与成熟度仍在爬坡。它松动的是迁移成本,不是一夜抹平工程差距。
三、为什么编译器是国产芯片的生死线
围绕国产芯片的讨论常聚焦制程、显存、互联,但一线落地最真实的痛往往是:卡买回来,模型跑得起来吗、跑得快吗、要不要养一支昂贵算子团队。
CUDA 护城河篇 讲过锁定根源不只是语言,更是十几年沉淀的库、工具链、调优经验和「搜得到答案」的生态。国产芯片破局,流片只是入场券,真正决定客户敢不敢上量的是软件三件套:
- 编译器:主流框架模型能否低成本迁移、自动生成高效 kernel;
- 算子库与框架适配:常用算子覆盖率、性能对标、与 vLLM 等主流引擎(推理引擎篇)接得顺不顺;
- 工具链:profiler、调试、性能分析是否齐全,出问题能否定位。
编译器是总枢纽,直接决定「迁移一个模型要多少人月、性能打几折」。客户算账很现实:一张卡理论算力是竞品 80%,靠成熟编译器和开箱模型能立刻发挥 75%;另一张纸面 120%,却要客户自己移植三个月、最终只发挥 50%——采购选谁一目了然。可交付的有效算力 = 纸面 算力 × 软件可发挥比例,编译器决定的正是后面那个乘子。
国产芯片的软件突围,现实中大致有三条路,往往组合使用:
- 兼容主流开源栈(借力 Triton/MLIR/torch 生态):优先让 PyTorch + Triton 算子在自家后端跑通,借生态的水涨船高,迁移成本最低。
- 自研/深度定制编译器与算子库:在开源底座上针对自家架构做极致调优,补齐关键大模型算子,把性能乘子做上去。
- 兼容 CUDA 的迁移层(翻译 HIP/CUDA 或二进制兼容):降低存量代码迁移门槛(CUDA 篇讲过这类方案的能与不能),但往往只能解决「跑起来」,跑多快仍要靠编译器。
这里有个残酷的时间差:硬件可以靠一次流片追参数,软件生态靠的是一个个模型、一个个算子、一次次客户现场打磨,没有捷径、无法并发。这也是为什么评估国产芯片不能只看发布会上的 TOPS,更要看它支持的模型清单、主流框架版本跟进速度,以及第三方实测的有效算力。
四、这门生意谁在赚钱、谁在卡位
AI 编译器本身大多开源、不直接卖钱,它的价值体现在「让谁的硬件/平台更好卖」,属于典型的战略级基础设施。卡位者有四类:
| 玩家 | 打法 | 目标 |
|---|---|---|
| 英伟达 | 自研 CUDA 编译器栈 + nvcc/cutlass,同时「收编」Triton 一等支持 | 让自家硬件性能体验最优,巩固锁定 |
| 框架/云厂 | 投 XLA/torch.compile、自研推理编译器 | 降低跨硬件成本,增强对供应商议价权 |
| AMD/ASIC 创业公司 | 重金做 ROCm/LLVM/MLIR/Triton 后端 | 软件补齐后才能把性价比变成订单 |
| 国产芯片厂 | 基于 MLIR/TVM 自研 + 兼容 Triton/CUDA | 让主流模型开箱即用,跨越落地鸿沟 |
一个微妙的博弈是:英伟达也在大力支持 Triton。表面看它在扶持一个多后端、可能反噬自己的标准,但 Triton 当下最大的受益平台仍是英伟达——把开发者从更底层、更可移植的 C++ CUDA 拉高到 Triton,短期反而把更多新开发者留在了自己性能最好的生态里。开放标准能不能削弱龙头,取决于其他后端的性能和成熟度何时追平,而不取决于标准本身。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 编译器承担更多性能优化 | 手写 kernel 比例下降 | 已发生、延续 | 高 |
| Triton 成算子编写事实标准 | 降低多后端迁移成本 | 已发生 | 高 |
| MLIR 成为新硬件编译器通用底座 | 缩短新芯片软件就绪周期 | 已显现 | 中高 |
| 非英伟达后端 Triton 性能追平 | 实质削弱 CUDA 锁定 | 3~6 年 | 中 |
| 极致性能仍靠专家/厂商库 | 全自动调优短期难全替代 | 5 年内 | 高 |
| 国产芯片软件成熟度拐点 | 决定出货从「试点」到「上量」 | 2~5 年 | 中高 |
- 未来 1~2 年(高置信度):Triton 继续扩张算子生态,国产与 AMD 芯片把「PyTorch+Triton 开箱可跑」作为标配卖点,但最前沿模型的极致性能仍由英伟达软件栈领先。
- 未来 3~5 年(中高置信度):MLIR/Triton 后端成熟度上升,多硬件编译路径明显降低迁移成本,软件不再是国产芯片完全过不去的墙,但「性能乘子」差距收窄到什么程度决定真实份额。
- 未来 5 年以上(中置信度):若开源编译器栈在主流模型上接近厂商私有栈,硬件竞争会更偏性价比和供给(受 出口管制 影响),英伟达软件溢价或被部分压缩;最尖端优化仍会长期保留专家手写空间。
六、对不同角色,这意味着什么
- 对用算力/做模型的团队:选型时把「软件就绪度」(Triton/主流框架支持、模型清单、迁移人月、实测有效算力)放在纸面 TOPS 之前;优先用 Triton 这类高抽象层写自定义算子,天然保留跨硬件可移植性。
- 对国产芯片厂:编译器和算子库不是流片后才补的「配套」,而是要和架构同步投入、决定生死的主战场;与其追求参数对标,不如先让几个标杆模型开箱跑得又快又稳。
- 对云与平台方:投开源编译器和多后端调度,是压低单一硬件议价权的长线筹码,和自研 ASIC(云厂自研芯片)是同一战略的两面。
- 对投资者:评估芯片公司要给软件栈和生态(编译器、算子、框架适配、客户现场能力)单独估值——硬件参数决定能不能进场,编译器决定能不能放量。
结语:最安静的战场,决定最硬核的替代
AI 芯片之争看上去是制程和算力的硬碰硬,但真正决定一张卡能不能被大规模用起来的,是编译器这层安静、繁琐、无法靠发布会跨越的软件。它把模型的数学和芯片的物理缝在一起,也把「换硬件」的代价悄悄抬高或抹平。XLA、TVM、MLIR、Triton 不是四个互相打架的名词,而是开源世界用来松动 CUDA 之墙的一整套掘进装备——其中 Triton 用一种「长在敌营、却四通八达」的姿态,成了最值得盯的那台盾构机。未来几年,与其追问某张国产卡的跑分,不如追问:主流模型在它上面用 Triton 跑得有多快、迁移要几个人月。那个不性感的数字,才是去 CUDA 化真实的进度条。
数据口径与延伸
- 数据口径:AI 编译器在框架与硬件间的翻译/优化定位、算子融合等优化机制、XLA/TVM/MLIR/Triton 的分层分工、Triton 降门槛与多后端趋势、编译器对国产芯片落地的决定性作用,来自各开源项目文档、框架与芯片厂商技术材料及行业研究的常见口径。各项目迭代极快,具体后端覆盖与性能以官方仓库和实测为准,本文不引用未经实测的性能数字。数据截止 2026 年中。
- 相关产业观察:CUDA 护城河有多深(锁定根源)、英伟达整柜战略(系统侧城墙)、推理引擎之争(编译器上层)、KV Cache 经济性(访存瓶颈)、中国 AI 芯片出口管制、国产 AI 芯片实战盘点。
- 同批待写延伸:模型量化 INT8/FP8/FP4(E7)、训练系统 Megatron/3D 并行(E9)、算子库与 kernel 人才(E6)。
一句话总结:AI 编译器是把「模型的数学表达」翻译成「芯片物理指令」并做算子融合、布局与并行优化的关键中间层,XLA(图编译)、TVM(多后端自动调优)、MLIR(搭编译器的母机)、Triton(类 Python 写高性能 kernel)分层叠放而非单纯竞争;其中 Triton 因降低算子门槛且天然多后端,成为绕开 CUDA、让算子生态迁移到 AMD 与国产芯片的关键路径——流片只是国产芯片的入场券,编译器与算子库决定的「性能乘子」才是它从试点走向上量的生死线,这是一场没有掌声却决定去 CUDA 化进度的软件战。