AI 加速卡:芯片到算力之间那层「板卡与模组」的生意
最后更新:2026-09-28|数据截止 2026 年中:具体卡型功耗、形态规格以各厂商正式发布为准,本文用代际与量级表述;国产芯片板卡化进展为公开信息,量产节奏有不确定性。
本文是产业观察。AI 芯片系列的讨论大多停在「晶圆—封装—整机」三段,中间其实隔着一层很少被单独讲的环节:板卡与模组。一颗裸芯片既不能自己供电、也不能自己散热、更不能自己插进服务器——它必须先被做成一张「卡」或一个「模组」,才变成能上架的算力。这一层决定了芯片能不能跑出标称算力,也藏着国产芯片落地最容易被低估的门槛。它与 英伟达整柜战略(卡之上怎么连成柜子)、GPU 服务器 ODM(卡之下怎么装成整机)正好夹出中间这一段。
先说结论
- AI 加速卡是「芯片变算力」的必要中间层,不是简单转接。 裸 die 出来的芯片,要配上几十相供电、HBM 贴装、高速信号布线、散热器与均热板,才能稳定跑在标称频率上。板卡层的设计质量,直接决定同一颗芯片在别人手里跑 100%,在你手里只跑 70%。
- 产业上有三种主流形态:PCIe 双宽卡、OAM 模组、SXM 模块。 它们对应三种功耗档位(数百瓦 / 700W 级 / 1000W 级)和三种互联哲学(走主板 PCIe / 走 UBB 底板 / 走英伟达私有底板),不是谁取代谁,而是按算力密度分层共存。
- 「公版卡 vs 定制卡」是这一层的核心商业逻辑。 公版卡(reference design)由芯片厂给出参考设计,板卡厂照做赚制造费;定制卡由云厂或大客户深度介入,改供电、改散热、改管理接口,溢价和粘性都在这里。英伟达把参考设计越做越完整,本质上是在把板卡层的利润和定义权往自己手里收。
- 板卡层是国产 AI 芯片的隐形门槛。 国产芯片要进客户机房,光 die 过关不够,还得有能过信号完整性、供电、散热验证的板卡方案和愿意配套的板卡厂——这一层的成熟度,往往比芯片本身更拖后腿。
一句话:买 AI 芯片的人以为自己买的是 die,实际到货的是一张「die + 供电 + 散热 + 互联」打包好的板卡;这层薄薄的 PCB,才是标称算力能不能兑现的真正分水岭。
一、为什么芯片不能直接用:板卡层到底干什么
先看一颗 AI 芯片从 fab 出来到上机架之间差了什么。裸芯片(哪怕是 CoWoS 封装好、HBM 已经贴上去的成品,见 CoWoS 产能分配 和 HBM 定制化)只是一个几厘米见方、底下几百上千个焊球的器件。它要上机,至少需要四样东西,而这四样全在板卡层:
- 供电。 旗舰 AI 芯片瞬态电流以千安计、电压不足 1V,板卡上要摆十几到几十相 VRM(电压调节模块,把 12V/48V 母线降到芯片要的核心电压)。供电相数不够、电容布局不好,芯片一冲高负载就掉压降频——标称算力直接打折。
- 信号完整性。 芯片到 HBM 已在封装内解决,但芯片对外的 PCIe/NVLink 高速串行链路要穿过 PCB 走几到十几厘米到连接器。走线长度匹配、板材损耗、过孔设计任何一处失手,链路就得降速跑。
- 散热界面。 芯片功耗从几百瓦冲到 1000W 级,热量要先经 TIM(热界面材料,见 TIM 与封装散热)传到均热板或冷板,再交给风冷或液冷(见 液冷产业图谱)。散热器是板卡的一部分,风道设计也是。
- 管理与机械。 板上有管理控制器(监控温度、电压、功耗、上报故障)、有金手指或连接器、有加强筋防止几公斤重的散热器把 PCB 压弯。
这四件事没有一件是「芯片设计」的事,也没有一件是「整机组装」的事,它们独立成一层,有自己的专业厂商和 Know-how。这就是为什么「芯片厂 + 板卡厂 + ODM」是三段不同的生意。
二、三种形态:PCIe 卡、OAM、SXM 各是什么
板卡层不是铁板一块,产业分化出了三种主流形态,对应三种功耗与密度档位。
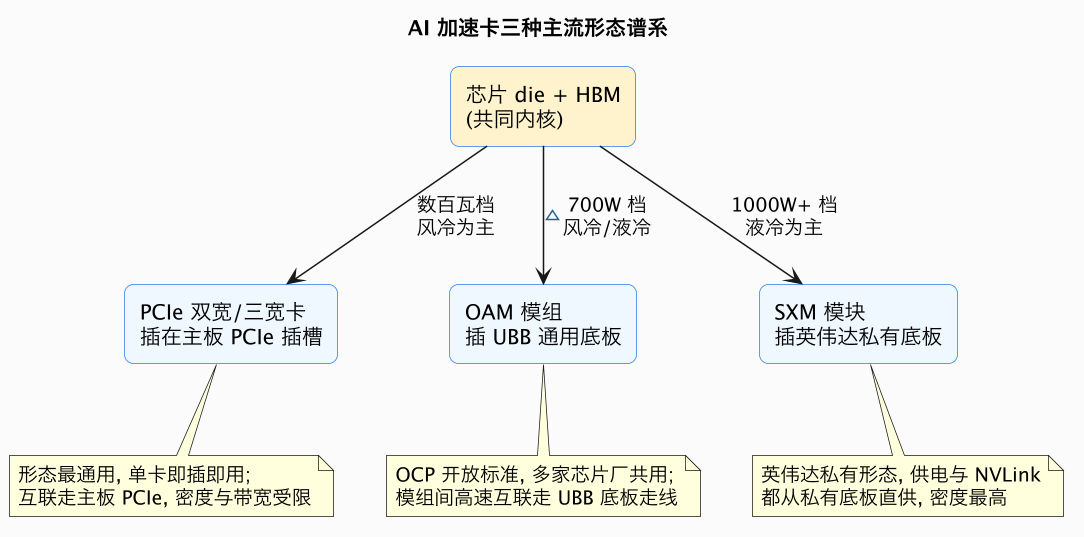
这张谱系图的读法是:同一颗芯片内核,可以被套进三种不同的「外壳」,差别全在功耗上限、互联路径和密度。
PCIe 卡是最老的形态:一块标准 PCIe 插卡,双宽或三宽,金手指插进任何服务器的 PCIe 插槽就能用,供电走插槽加外接电源头。它的优点是通用——什么机器都能插;代价是天花板低:PCIe 插槽供电加外接头总共支撑数百瓦,卡间互联只能走主板 PCIe 交换,带宽和延迟都比专用互联差一个量级。推理卡、入门级训练卡多走这条路。
**OAM(OCP Accelerator Module,开放计算项目加速器模组)**是开放阵营的答案:一个巴掌大的模块,底部高密度连接器插到一块叫 UBB(Universal Baseboard,通用底板)的载板上,一块 UBB 通常载 8 个模组,模组间的高速互联走线直接做在 UBB 里,不经主板。供电从 UBB 直供,上限做到 700W 级。AMD MI300 系列、以及一批自研 ASIC 走的是这个形态——它的产业意义在于「标准开放」,谁家的芯片都能做成 OAM 插进同一块 UBB。
SXM 是英伟达的私有形态:模块直接焊/插在英伟达自己的 HGX 底板上,供电从底板直供冲到 1000W 以上,NVLink 链路全部走底板走线、距离最短、损耗最小,这是旗舰训练 GPU 满血互联的前提(域怎么再往上连成整柜,见 NVLink 整柜战略)。代价是完全私有:底板、散热、整机全按英伟达参考设计来。
三种形态的硬指标摆在一起:
| 维度 | PCIe 双宽卡 | OAM 模组 | SXM 模块 |
|---|---|---|---|
| 单卡功耗上限 | 数百瓦(插槽+外接供电) | ~700W 级(UBB 直供) | 1000W 级以上(私有底板直供) |
| 卡间互联路径 | 主板 PCIe 交换 | UBB 底板内走线(IF 链路) | HGX 底板内走线(NVLink) |
| 典型载体 | 通用服务器主板 | 一块 UBB 载 8 模组 | HGX 底板载 4/8 模块 |
| 散热 | 风冷为主 | 风冷/液冷均可 | 高功耗档基本液冷 |
| 标准归属 | PCIe SIG 开放标准 | OCP 开放标准 | 英伟达私有 |
| 算力密度 | 低 | 高 | 最高 |
| 代表产品 | L40S、各家推理卡 | AMD MI300X、自研 ASIC | H100/H200/B200 SXM 版 |
一句话:功耗每上一个台阶,就换一种形态——因为供电、散热、互联三件事会同时撞墙,靠老形态的结构余量补不回来。
三、供应链怎么分:谁做芯片、谁做卡、谁做底板
把形态讲清后,产业分工的图景就出来了。
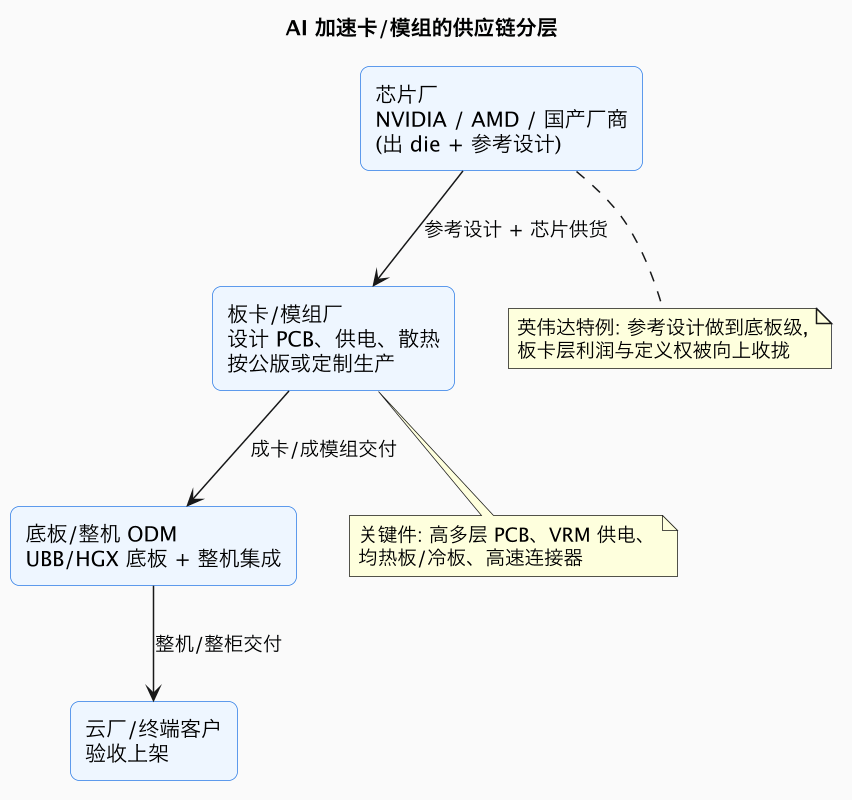
这张图里有三个常被忽略的产业事实。
第一,板卡厂手里握着的是「工程兑现权」。 芯片厂给的是参考设计(原理图、布局指导、BOM 清单),但从图纸到一张过全部验证的量产卡,中间是高速 PCB 布线、几十相供电的电源完整性仿真、散热结构打样、信号完整性测试——这一串活的专业壁垒不低。同一份参考设计,头部板卡厂和二线厂做出来的卡,满负载下的频率稳定性和故障率能差出肉眼可见的一截。
第二,底板是 OAM/SXM 形态里另一块高价值阵地。 UBB 和 HGX 底板是几十层的高速高多层板,模组间互联的高速走线全在里面,加工难度和单价都远高于普通服务器主板。整机 ODM(见 GPU 服务器 ODM 格局)挣的很大一部分钱,其实在这条底板上。
第三,英伟达在把这条链向上收。 HGX 底板由英伟达深度定义,板卡和整机厂越来越像「按图施工」;到 NVL72 整柜一代,参考设计直接做到机柜级。留给板卡层的自由裁量空间在缩小——这是「公版化」趋势的极致,也是下一节商业逻辑的根源。
四、公版卡 vs 定制卡:这一层的钱怎么分
板卡层的商业模式,本质上是一道选择题:照公版做,还是为客户定制。
| 维度 | 公版卡(Reference Design) | 定制卡(Custom) |
|---|---|---|
| 定义方 | 芯片厂给完整参考设计 | 云厂/大客户深度介入规格 |
| 板卡厂角色 | 按图制造,赚加工与良率钱 | 联合设计,赚工程与溢价 |
| 改动空间 | 散热、外观、微调供电 | 供电拓扑、连接器、管理接口、结构都可改 |
| 典型客户 | 渠道、中小客户、通用市场 | hyperscaler、超大集群采购 |
| 毛利结构 | 薄,靠走量 | 厚,但绑定单一大客户 |
| 风险 | 同质化价格战 | 客户砍单则产能闲置 |
公版逻辑好理解:芯片厂希望生态快速铺开,把设计做到「照着做就能点亮」,板卡厂拼的是制造良率和成本。定制逻辑则越来越重要:超大规模云厂买卡是以十万计,他们会要求改供电相位以配合自家机柜的 48V 母线、改管理接口接入自研的带外管理系统、改散热形态适配自己的液冷机柜——每一个改动都是工程费,也都是绑定。对板卡厂来说,抱上一两个 hyperscaler 的定制单,毛利和产能利用率都稳,但命脉也就交给了客户。
英伟达的特殊位置在于:它两头都吃。旗舰 SXM/HGX 形态高度公版化,定义权牢牢在自己手里;同时对超大客户也开放一定程度的定制(整机、供电、管理软件层面的协同),用「半定制」换绑定。开放阵营(OAM/UBB)则天然更适合深度定制——标准开放,云厂自研 ASIC 配上自定的 UBB 和散热,整条板卡链可以完全绕开英伟达。这也是为什么国产芯片厂商在国内推 OAM 兼容形态最积极:借开放标准搭上现成的板卡与底板生态,落地阻力最小。
五、为什么说板卡层是国产芯片的隐形门槛
讨论国产 AI 芯片(全景见 中国 AI 芯片玩家现状,枢纽视角见 AI 芯片枢纽)时,注意力几乎都在 die 的性能和产能上。但从「有芯片」到「客户机房里的稳定算力」,板卡层横着三道坎:
- 验证坎。 一张千卡集群要用的加速卡,得过电源完整性、信号完整性、热循环、长时间满载老化一整套验证。这套验证能力集中在少数头部板卡厂手里,排队和工程投入都不小。
- 配套坎。 高多层高速 PCB、千瓦级 VRM 方案、均热板与冷板,国产供应链都有玩家,但「为某颗新芯片快速调出一套成熟板卡方案」的响应速度,和英伟达生态里那批跟了十几年的老搭档比,差距明显。
- 生态坎。 客户机房按 PCIe 还是 OAM 建?运维系统认不认这张卡的管理接口?这些「卡以外」的兼容性,往往比芯片算力更影响采购决策。
所以看国产芯片落地进度,一个比发布会更实的信号是:有没有头部板卡厂为其量产成卡、有没有主流服务器厂出了对应机型。这两个信号齐了,才说明芯片真的过了「变成可用算力」这一关。
六、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 单芯片功耗继续上探 | PCIe 形态份额被 OAM/SXM 类模组挤压 | 已发生、延续 | 高 |
| 液冷成为旗舰板卡默认散热 | 冷板/均热板价值量并入板卡 BOM | 1~3 年 | 高 |
| OAM 开放形态在 AMD/自研/国产阵营扩大 | UBB 与开放板卡生态放量 | 2~4 年 | 中高 |
| 英伟达参考设计继续向整柜收拢 | 板卡层自由裁量空间缩小 | 已发生、延续 | 高 |
| 国产芯片板卡生态成熟 | 落地门槛逐步降低 | 3~6 年 | 中 |
- 6 个月(高置信度):旗舰形态继续向 1000W 级模组 + 液冷集中,PCIe 卡退守推理与中低端;国产新芯片的「成卡进度」成为比参数更受关注的信号。
- 18 个月(中高置信度):OAM/UBB 在非英伟达阵营形成更完整的开放板卡生态,定制卡在大客户采购中的占比继续上升,底板与液冷冷板供应商显著受益。
- 36 个月(中置信度):若开放互联标准在模组间落地,板卡层可能出现「跨厂商混插」的雏形;反之英伟达把板卡—底板—整柜的定义权收得更紧,板卡厂进一步代工化。
总结
AI 加速卡与模组是芯片到可用算力之间的必要中间层:PCIe 双宽卡、OAM 模组、SXM 模块三种形态按功耗与互联密度分层共存,板卡层的供电相数、信号完整性、散热设计决定芯片能否兑现标称算力;商业上「公版卡赚制造、定制卡赚绑定」,英伟达通过把参考设计做到底板与整柜级持续上收定义权,而 OAM 开放形态给了 AMD、自研 ASIC 与国产芯片绕开私有体系的通道——对国产芯片而言,板卡与验证生态的成熟度,是比 die 本身更现实的落地门槛。