自建 vs 调用基础模型
一句话回答
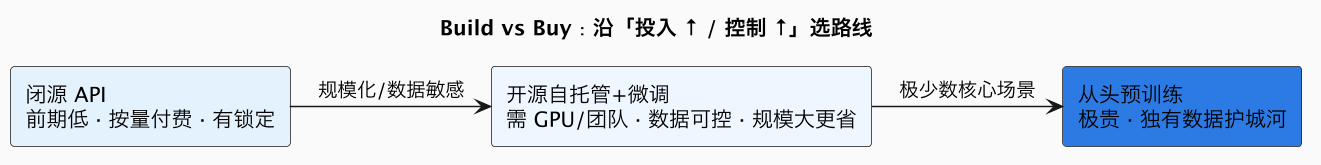
没有谁绝对更优,要按规模、数据敏感度和差异化程度算账:调用 API 启动最快、无固定投入但长期按量付费且有锁定;用开源模型自托管+微调需要 GPU 和 MLOps 团队,但数据可控、规模够大后单位成本更低;从头训练极其昂贵,只有拥有独特私有数据和明确护城河才值得。多数企业应从 API 验证价值,规模化或数据敏感后再迁向自托管。
三条路线本质上是在一根「投入与控制」的轴上选位置:越往自建走,前期越重、数据控制越强。
一、三条路线对比
| 路线 | 前期投入 | 长期边际成本 | 数据控制 | 适合 |
|---|---|---|---|---|
| 闭源 API | 低 | 按量、随调用增长 | 需信任供应商 | 起步/中小规模 |
| 开源自托管+微调 | 中(GPU+团队) | 规模大后更低 | 高 | 大规模/敏感数据 |
| 从头预训练 | 极高 | — | 完全 | 有独有数据的巨头 |
要真正用好这张表,需要看清三条路线的成本结构,而不是只比较「API 单价」。闭源 API 的本质是把固定成本(GPU、机房、研发、运维)全部转移给供应商,企业只承担随用量变化的可变成本,因此启动几乎零门槛、现金流压力最小;代价是长期看每一笔调用都要付费,且供应商一旦提价、限流或调整策略,企业相对被动,深度使用其专有工具还会形成锁定。开源自托管则相反:要先承担 GPU 采购或租赁、机房、以及一支 MLOps/推理团队的固定投入,但当调用规模大到足以摊薄这些固定成本后,单位推理成本会明显低于持续调用 API;同时数据全程留在自己域内,对合规和定制都更有利。从头预训练是数量级更高的投入——一次前沿模型预训练的算力、数据和人才成本极高,且失败风险大,因此它本质上不是一项「省钱」选择,而是为了构建别人无法复制的能力护城河,只对拥有独特数据或战略级目标的少数巨头成立。
一个容易被忽略的点是:这三条路线的成本曲线会随规模发生交叉。API 的成本曲线近似一条随用量线性增长的直线,自托管则是「先高后平」——固定投入大、但边际成本低。在用量较小时 API 始终更便宜;越过某个盈亏平衡点后,自托管的累计成本开始低于 API。这个平衡点具体在哪,取决于 GPU 价格、模型固定程度、利用率和团队效率,因此不能照搬别人的结论,必须用自己真实的负载曲线测算。
二、决策四问
- 调用规模:用量能否摊平自建的固定投入(GPU 折旧 + 工程团队)?
- 数据敏感度/合规:数据能否出域?是否要求私有化部署?
- 差异化需求:通用模型能否满足,还是需要私有知识/特定风格的微调?
- 团队能力:是否具备推理运维、评测、数据飞轮的能力?
这四问里,数据敏感度往往是一票否决项:如果行业监管要求数据物理不出域,那么无论 API 多便宜、自测算账多划算,都只能走私有化或自托管,没有讨论余地。调用规模决定经济性,差异化需求决定「通用模型够不够用」,而团队能力则是最常被低估的一项——很多企业只算了 GPU 的钱,却忽略了自己有没有人能把推理引擎、量化、调度、评测和故障处理长期做好。缺少这种能力时,自建省下来的钱很容易被低利用率和频繁故障吃光,实际 TCO 反而更高。因此决策不能只看「买卡花多少」,而要把人才和运维能力一并计入。
三、常见路径
API 试点(快速验证 ROI)→ 对确有价值且量稳的负载,引入开源模型做自托管/混合架构 → 极少数核心场景才考虑持续训练。重点是避免“一开始就重投入自建”或“规模很大后仍为 API 支付溢价”。
这条渐进路径背后的逻辑是「用最小成本买到确定性,再逐步加码」。先用 API 快速试错,是因为产品价值尚未验证时,把钱花在自建 GPU 和团队上风险极高——很可能模型做出来却发现业务不成立。一旦某条负载被证明有价值、用量也趋于稳定,就有了测算盈亏平衡的真实数据,此时再把它迁到自托管或混合架构,决策风险大幅降低。而从头持续训练,应始终被视为战略级的例外而非默认选项。
常见误区
- 为技术酷而自建:没有规模和团队支撑,TCO 反而更高。
- 只看 API 单价不看长期累计:超大调用量下自托管可能更省。
- 忽视隐性成本:自托管要算运维、监控、利用率和人才。
- 认为微调能凭空创造能力:微调改风格/知识注入,替代不了基础能力。
- 忽略锁定与迁移:关键系统应保留切换模型的抽象层。
- 把「微调」和「自建基座」混为一谈:微调通常成本不高、主要改风格或注入私有知识,真正昂贵和高风险的是从头训练,二者投入差几个数量级。
- 静态地做一次决策就不再复盘:模型价格、能力和开源生态变化极快,今天 API 更划算、半年后可能相反,应保留按周期重估的机制。
- 只算显性成本、忽略机会成本:把顶尖工程师长期耗在维护推理基础设施上,可能耽误更核心的产品研发,这部分也应计入 TCO。
四点五、混合架构为何越来越主流
随着企业成熟,纯 API 或纯自建的「二选一」正让位于更灵活的混合架构:核心、稳定、敏感的负载自托管以压低成本和保障数据安全,试验、突发、长尾的负载用 API 以保持弹性和快速迭代。它要求在应用和模型之间建一层统一抽象,使同一业务逻辑可以在不同模型和部署方式间切换。这样既避免被单一供应商锁定,又不必为所有负载承担自建的重投入,是大多数规模化企业的务实终点。
五点五、不同类型企业实际怎么选
把四问落到不同组织,选择差异非常明显:
- 初创公司 / 中小企业:几乎都应从 API 起步。这个阶段速度和现金流比单位成本更重要,自建 GPU 和团队的风险收益严重不划算;用 API 在几周内验证需求,比为省几块钱去搭基础设施重要得多。
- 传统行业做数字化转型:往往数据敏感、模型用量可预测但不极端,适合「私有化部署开源模型 + 少量 API 做外围」,核心诉求是合规、可控和稳定,而不是追求最强模型。
- 以 AI 为核心的成长型公司:当核心产品调用量快速攀升,会逐步把高流量模型自托管以压低毛利损失,同时保留 API 承接试验和峰值,走向混合架构,并搭建专职推理平台团队。
- 大型平台 / 巨头:有能力也有战略动机自研甚至持续训练自有基座,把模型作为差异化与生态控制权的来源,自建的逻辑更多是竞争而非单纯省钱。
这说明 Build vs Buy 没有脱离企业阶段的标准答案:同一个选择在公司某一阶段是理性的,换个阶段可能就是错配。因此更稳妥的姿态是把它看作一个随业务演进而动态调整的决策,而不是一劳永逸的定局。
六点五、实践中反复出现的失败教训
复盘大量企业的经验,有几类错误代价最高,值得提前规避:
- 在需求未验证时就重金自建:买了卡、组了团队,结果业务场景不成立,GPU 闲置、团队空转,是最常见、损失也最直接的一类。
- 规模已经很大却仍长期纯依赖 API:用量远超盈亏平衡点却没有迁移,单位成本长期偏高,毛利被持续侵蚀,等意识到时已经付出大量溢价。
- 自建却忽视利用率治理:只搭了集群、没有配额、回收和监控,空转率高企,名义自建、实际比 API 更贵。
- 低估人才门槛:以为部署开源模型只是下载运行,实际推理优化、量化、调度、评测和故障处理都需要稀缺的工程能力。
- 没有保留切换的抽象层:业务被某一供应商的私有接口和工具深度绑定,日后想迁移代价极高,丧失议价能力。
- 把模型能力当成唯一考量:选型时忽视了延迟、稳定性、合规和成本,等上线后才发现「分高」的模型在真实业务里并不好用或用不起。
避免这些错误的共同点,是把决策建立在自己真实的数据(用量曲线、敏感度、团队能力)之上,分阶段投入、持续复盘,并始终为自己保留切换和重估的主动权。对绝大多数企业而言,这比一开始就争论「到底该自建还是该买」更有意义。
总结
Build vs Buy 本质是“规模、数据敏感度、差异化、团队能力”四要素的 TCO 权衡:API 适合起步与中小规模,开源自托管适合大规模或敏感数据,从头训练只属于有独有数据护城河的少数玩家;稳妥路径是 API 验证价值、规模化后再评估自建,并用抽象层保留切换自由。还应记住,这不是一次性决策,而要随公司阶段、模型价格和开源生态的变化定期重估;真正决定成败的,往往不是选了哪条路线,而是有没有建立在真实数据上、分阶段投入、并始终保留主动权和切换的弹性。能把这套动态权衡做好的企业,才能在快速变化的 AI 供给面前既用得起、又不被锁定,把有限的资源持续投到回报最高的地方。对于已经在快速扩张的企业,一个实用建议是建立每季度复盘 Build vs Buy 的固定机制:用最新的用量、价格和团队数据重新测算盈亏平衡,并据此微调自建与采购的比例。这样既不会因为一次决策的路径依赖而长期吃亏,也能在模型能力和开源生态突变时迅速调整方向。归根到底,真正成熟的态度是把这道选择题当作持续的成本与战略管理,而不是非此即彼的立场之争——保持灵活、数据说话、始终握有主动权的企业,往往才能在 AI 长周期里走得更稳。还有一层现实需要正视:随着开源模型能力快速逼近闭源前沿、API 价格持续下行,Build 与 Buy 之间的盈亏平衡点本身也在不断移动,过去测算得出的结论很可能在几个季度后失效。因此企业与其执着于找到一个"最优解",不如建立一套能快速感知变化、低成本切换的能力——统一的模型抽象、可迁移的数据管线、以及对单位成本的持续度量。当这些基础设施就位,无论未来供给格局如何变化,企业都能以最小代价顺势调整,而不是被既有选择锁死。这种以灵活性对冲不确定性的思路,或许才是 AI 时代基础设施决策中最值得投入的部分,它带来的长期回报,往往远超过在某一次选型中抠出的那点价差,也让企业在持续动荡的技术浪潮中始终保持从容与主动,不被任何一次供给波动打乱节奏。