光模块产业:800G/1.6T 为什么是 AI 最确定的「卖铲」生意
最后更新:2026-09-19|数据截止 2026 年中:速率代际、厂商格局与需求逻辑来自厂商财报、供应链与行业研究的常见公开口径,具体份额与出货量为量级估计、变化很快,本文用结构与趋势表述。
本文是产业观察,回答:在整条 AI 硬件链里,为什么高速光模块被普遍认为是需求最确定、且中国厂商最强的一环。 万卡集群的网络拓扑 讲清了一个集群要配多少交换机和光模块,本文顺着那张网络,专门讲光模块本身:它在干什么、速率怎么迭代、技术路线怎么选、谁在赚钱。它是网络篇的下游——知道了拓扑需要海量高速端口,再看这些端口上插的器件为什么成了最好的生意。
先说结论
- AI 把光模块从「随网络升级的周期件」变成了「算力的刚性耗材」。 大模型训练产生巨大的东西向流量(服务器之间反复同步梯度),无阻塞胖树又要数倍于 GPU 数量的高速链路,每条链路两端各一个光模块;GPU 卖得越多、集群越大,光模块需求越确定。
- 速率沿 400G→800G→1.6T 快速上移,单价和价值量同步抬升。 Scale-Up 域扩大、单 GPU 通信需求增长,推动端口速率代际切换,高代际模块单价更高、技术更难,量价齐升。
- 技术路线在 EML、硅光、CPO 之间演进。 EML(电吸收调制激光器)成熟可靠、是高速主力;硅光(silicon photonics)用 CMOS 工艺集成光器件、利于规模化降功耗;CPO(共封装光学)把光引擎搬到交换机芯片旁,是更前瞻的形态,但可维护性和生态还在博弈。
- 这是中国厂商全球领先的少数高端环节。 中际旭创、新易盛等在高速光模块的封装、规模化制造和大客户绑定上居全球第一梯队,并深度进入北美云与 AI 龙头供应链;真正卡脖子的高端光芯片/激光器(多由美日厂掌握)仍是需要补的上游。
一句话:只要还在用越来越多 GPU 搭越来越大的集群,就必须在每条高速链路上插越来越快的光模块——它不赌模型成败、不押单一架构,是算力扩张里最纯粹的「卖铲」;中国厂商靠制造与集成做到了全球领先,但最上游的高端光芯片仍是这顶皇冠上待补的那颗珠。
一、为什么说它是最确定的卖铲生意
光模块(optical transceiver,光收发模块)的功能是做电与光的相互转换:交换机/网卡处理的是电信号,要在机柜间、机房区长距高速传输,就得把电信号调制成光信号发进光纤,对端再把光信号还原成电信号。光模块就是插在交换机/网卡端口上完成这件事的可插拔小盒子。
它的需求确定性,来自一个简单的乘法关系,在 万卡集群网络拓扑 已铺垫:
- 每一条高速链路两端各一个模块;
- 无阻塞胖树 + 轨道优化使高速端口数量是 GPU 数量的数倍;
- AI 集群规模从千卡扩到万卡、数万卡;
- 端口速率从 400G 升到 800G、1.6T,单模块价值量随速率提升。
四者相乘,光模块需求随 AI 资本开支呈高确定性增长。更妙的是它的「中立性」:不管最终是英伟达 GPU、AMD、云自研 ASIC 还是国产芯片胜出,只要集群要组网,就要用光模块。 它不押注某一种芯片架构,也不依赖某一个模型成败,是典型的「淘金热里卖铲子」。这与同一网络链条上的交换机芯片(被博通、英伟达高度集中)不同,光模块环节的制造附加值更大、供应商也更分散,给了中国厂商结构性机会。
| 需求驱动 | 对光模块的影响 |
|---|---|
| GPU 集群规模扩大 | 模块总量随端口数增长 |
| 轨道优化/无阻塞胖树 | 端口数数倍于 GPU |
| Scale-Up 域扩大、单卡带宽升 | 速率向 800G/1.6T 切换 |
| 训练占比 + 推理分布式化 | 东西向流量长期高位 |
二、速率代际与三条技术路线
光模块的「G」指单模块(或单端口)数据速率。AI 集群端口速率沿 400G→800G→1.6T 演进,下一代 3.2T 已在研发。速率翻倍不是简单「做快一点」,而要在更窄空间里解决更高的信号速率、散热和功耗,因此光模块越做越像一项精密光电系统。实现高速光信号,主流有三条技术路线:
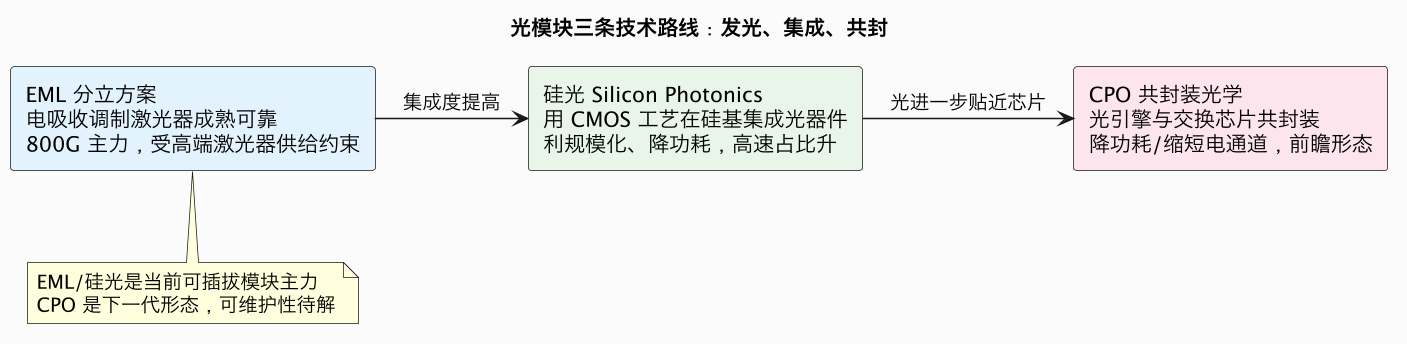
① EML 等传统激光器方案。 EML(Electro-absorption Modulated Laser,电吸收调制激光器)把发光与调制集成,性能成熟、距离规格齐全,是当前 800G 等高速模块的主流光源之一。它的瓶颈在于高端激光器芯片的制造难度和供给集中(高端光芯片长期由美日厂商主导),需求暴涨时激光器成为模块厂的关键采购约束。
② 硅光(silicon photonics)。 用成熟的硅基 CMOS 工艺,把调制器、波导、探测器等光器件大规模集成在硅芯片上(激光器通常仍需外部或异质集成)。优势是集成度高、适合大批量制造、功耗和成本随规模下降,在 800G/1.6T 高集成模块中占比上升;它把「光器件」变成更像「芯片制造」的生意,利好有硅光设计与封装能力的厂商。
③ CPO(Co-Packaged Optics,共封装光学)。 不再把光模块插在交换机面板上,而是把光引擎直接和交换 ASIC 封装在同一基板/封装附近,大幅缩短电信号通道、降低功耗、提升密度,是面向 51.2T 及更高速率交换机的前瞻形态。但它牺牲了可插拔模块「坏一个热插拔换一个」的便利——光引擎与芯片共封后维修、良率、供应链分工都更复杂,交换机厂、模块厂、芯片厂的利益也需重新协调,因此量产节奏存在博弈(同批 D4 专文展开)。
| 路线 | 成熟度 | 优势 | 主要约束 |
|---|---|---|---|
| EML 分立 | 高、当前主力 | 可靠、规格全 | 高端激光器供给集中 |
| 硅光 | 成熟中、占比升 | 集成度/规模化/功耗 | 激光光源、设计与封装 |
| CPO | 前瞻、试点 | 低功耗、高密度 | 可维护性、良率、生态 |
判断:中短期是「EML + 硅光」的高速可插拔模块放量;CPO 是确定性方向但放量时点取决于可维护性和供应链分工,不会一夜替换可插拔。 无论哪条路线赢,对模块总需求的方向都不构成利空——变的是技术形态和价值在芯片厂/模块厂之间的分配。
三、竞争格局:中国领先的制造环节
光模块是 AI 硬件链上中国厂商最具全球竞争力的环节之一。
- 中际旭创、新易盛:在高速光模块(400G/800G 乃至 1.6T)的研发、封装、规模制造和交付上居全球第一梯队,深度进入北美云厂商与 AI 网络设备龙头供应链,是 AI 光需求最直接的受益者。
- Coherent(含原 II-VI/Finisar 资产)等海外厂:在光模块整体方案、尤其上游高端光芯片/激光器/器件上实力深厚,垂直整合度高。
- 其他中外厂商:还有多家光模块、光器件和硅光厂商分食不同速率与区域市场,行业集中度随高速代际提升(高代际技术、资金、客户认证门槛更高)。
为什么中国能在这一环领先?光模块是技术密集 + 精密制造 + 良率/成本控制的结合,而不只靠某一项被垄断的设备:中国厂商在高速光电封装、自动化制造、工程化交付和响应大客户节奏上积累了十余年能力,叠加国内工程师与供应链红利,形成了全球难以替代的规模制造优势。AI 需求爆发时,「谁能量产、良率高、交得快」本身就是壁垒。
但要清醒看到价值的「微笑曲线」两端:
- **上游高端光芯片/激光器(EML 芯片、CW 光源、部分 DSP 电芯片)**长期由美日等少数厂商掌握,利润厚、是国产替代的真正深水区;模块厂在高景气时也会受这些关键件供给与价格制约。
- 国内在光芯片、硅光、DSP(数字信号处理芯片)上正加速追赶,部分环节已有突破,但最高端器件的自主率仍在爬坡。
关键判断:中国赢在「把光器件大规模高良率做成模块」的中游制造,真正的硬骨头是最上游的高端光/电芯片。 这与 HBM、先进逻辑那种「中游也被锁死」的环节不同——光模块给了中国厂商在 AI 链里少见的高价值、高份额位置。
3.1 一只光模块内部:光与电的微型系统
理解这门生意的价值分布,最好拆开一只高速光模块看。它的输入是交换机来的高速电信号,输出是光纤里的光,内部主要由几类器件构成:
- DSP(数字信号处理芯片):对高速电信号做均衡、时钟恢复和补偿,是模块里价值量和技术门槛最高的电芯片之一,速率越高越离不开,长期由少数厂商主导。
- 激光光源与驱动:CW(连续波)激光器或 EML 提供光载波,激光器芯片的性能直接决定传输距离和信号质量,高端光源是美日厂商强项。
- 调制器与探测器:把电信号写到光上、再从光上读回来;硅光方案把这些器件集成进硅芯片。
- 光器件与封装:透镜、隔离器、光纤阵列以及高精度光电共封装(把光子和高密度电通道装在狭小空间并散热),是模块厂最核心的制造 know-how。
速率每翻一倍,DSP 算法、光电器件带宽、信号完整性和散热难度都上一个台阶,模块里的「芯片含量」和精密封装含量随之提高。这解释了两件事:一是高代际模块单价更高、量价齐升;二是模块厂的护城河很大程度在于把这些高难器件高良率、低成本、快速量产的集成能力,而上游高价值芯片(DSP、高端激光器)则是另一套更集中的供给格局。
3.2 可插拔 vs CPO:不只是技术之争,也是利益之争
可插拔模块之所以长期主导,不仅因为技术成熟,更因为它创造了一种灵活的产业分工:交换机厂卖交换机、模块厂卖模块、坏了现场热插拔即可更换,采购、库存、维护彼此解耦。CPO 把光引擎和交换芯片共封装后,这套分工被打乱:
- 光引擎变成交换机/芯片的一部分,价值在交换 ASIC 厂、模块厂、光引擎厂之间重新分配,传统可插拔模块的增量空间可能被压缩;
- 可维护性下降:共封的光引擎不能现场单换,要么靠冗余光通道续命、要么整板返修,数据中心运维模式要重写;
- 良率耦合:交换芯片很大很贵,与光引擎共封后,光通道缺陷会拖累整个昂贵组件的良率;
- 但收益实在:在 51.2T、102.4T 时代,面板上已插不下、也供不动那么多可插拔模块,CPO 在功耗和密度上的优势会从「可选」变成「不得不选」。
因此 CPO 的真实节奏不取决于它「能不能做出来」,而取决于交换芯片厂、模块厂和云买方能否在可靠性、可维护性和价值分配上达成新均衡。一个可能的中间态是:可插拔(含 LPO、线性可插拔等降功耗方案)与 CPO 在不同速率/距离档位长期共存,模块厂通过转型为光引擎供应商继续留在价值链上。对中国头部模块厂而言,这既是风险,也是从「做模块」升级为「做共封光引擎」的机会窗口。
四、需求会不会是一次性的:训练之后还有推理
一个常见疑问是:光模块需求是不是只由训练集群拉动,等训练潮过去就回落?答案是需求结构会变化,但不会消失,原因有三:
- 训练集群仍在扩张,前沿模型对算力和集群规模的需求尚未见顶,800G/1.6T 升级持续。
- 推理也在分布式化:大模型、长上下文、混合专家(MoE)和多机推理让推理不再是单机任务,参数与中间结果同样要跨节点传输,网络并不闲。
- 存量网络升级:端口速率代际更替(400G→800G→1.6T)驱动既有数据中心持续换新模块。
同时要理解这门生意的周期性与壁垒,避免把「高景气」误读成「无风险」。光模块历史上是强周期行业:电信运营商的建网节奏和云厂商资本开支交替主导需求,价格随代际和产能快速下行,厂商盈利波动大。AI 带来的不同在于,需求侧多了一个体量巨大、持续数年、且对速率升级极度渴求的新买家(AI 集群),部分对冲了传统周期,但并没有消除它——一旦云资本开支退潮或高速产能集中释放,价格和毛利仍会承压。
壁垒方面,高端光模块并非简单组装,行业格局随代际向头部集中的原因有三:其一,速率越高,高速模拟/光电混合设计、信号完整性和热设计门槛越高,小厂难以在 800G/1.6T 跟上;其二,大客户认证周期长,进入北美云与网络设备龙头供应链要经过严苛的可靠性、良率和产能验证,一旦入围便形成粘性;其三,交付与供应链管理能力,在激光器、DSP 等关键件紧张时,能稳定拿到上游、又能高良率量产的厂商才有资格吃下订单。这三重壁垒决定了高景气的红利主要被头部、有真实大客户认证的厂商拿走,而非普惠整个板块。
真正需要跟踪的风险不是「AI 不需要网络了」,而是速率升级节奏、CPO 对可插拔模块的替代速度、以及上游关键件(高端激光器/DSP)的供给与价格。只要集群还在变大、变快,光模块的量价逻辑就成立。此外还有一个常被忽略的结构性支撑:AI 集群对「网络可用性」的要求极高,光模块作为大规模部署中实际失效率不低的活动部件,需要大量备件库存和快速替换供给,这部分售后服务与备件需求虽不性感,却为头部供应商提供了稳定、持续、随装机量累积的收入流,使这门生意不完全依赖当年新增建设,而带有一定「装机基数」属性——这也是它比单纯的一次性设备销售更具韧性的原因之一。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| AI 集群规模/资本开支 | 决定模块总量 | 持续 | 高(随资本开支周期波动) |
| 速率向 800G/1.6T 切换 | 量价齐升 | 1~3 年 | 高 |
| 硅光占比上升 | 改变技术与价值分配 | 2~5 年 | 中高 |
| CPO 量产替代可插拔 | 重塑模块形态与厂商分工 | 2027 后渐显 | 中 |
| 高端光芯片国产化 | 决定中国链能吃多深价值 | 3~7 年 | 中 |
- 未来 1~2 年(高置信度):800G 为放量主力、1.6T 进入导入,绑定头部云与网络设备客户的一线模块厂商业绩高弹性;EML 与硅光并行,上游高端激光器/DSP 供给是关键约束。
- 未来 2~4 年(中高置信度):1.6T 规模上量、硅光渗透率提升,行业向有高速研发与大客户认证的头部集中;中国厂商维持全球领先份额并向上游器件延伸。
- 未来 3~7 年(中置信度):CPO 随 51.2T+ 交换逐步铺开,价值在交换芯片厂与模块/光引擎厂间重新分配;高端光芯片/DSP 国产化决定中国链从「强制造」走向「强器件」的深度。
六、对不同角色,这意味着什么
- 对云/集群建设者:高速光模块是网络 BOM 的大头,应锁定头部供应商产能、并在 CPO 与可插拔路线间管理升级风险。
- 对光模块厂商:胜负在高速代际研发、大客户认证、规模良率与上游关键件保障;向硅光/光芯片垂直延伸是提升价值占比的关键。
- 对国产上游:高端激光器、CW 光源、DSP 是最确定的国产替代深水区,需求和验证场景都已具备。
- 对投资者:光模块是 AI 链里最纯粹的卖铲环节之一,但要区分高代际、有真实大客户订单的头部与低速率易内卷厂商,并跟踪 CPO 技术替代节奏。
结语:插在每条高速链路上的确定性
如果说 AI 硬件链上多数环节都在赌「哪种芯片赢」,光模块赌的则是一个更稳的前提——只要还用越来越多的处理器去搭越来越大的集群,每条高速链路两端就要各插一个越来越快的光模块。无阻塞胖树让端口数数倍于 GPU,800G/1.6T 让单价随速率抬升,量价齐升使它成为最确定的卖铲生意;EML 与硅光支撑当下、CPO 指向下一代。而中国厂商凭借高速封装与规模制造做到了全球领先,这是这条链上少有的高份额位置,唯一还没完全拿下的,是高端光芯片与 DSP 这颗「皇冠上的珠」。看清光模块,就看清了 AI 算力扩张里最不挑赢家、却最依赖工程功力的那条供给线。
数据口径与延伸
- 数据口径:光模块电光转换的功能、400G/800G/1.6T 代际、EML/硅光/CPO 的技术取舍、「端口数数倍于 GPU、每链路两端各一模块」的需求结构、中际旭创/新易盛/Coherent 的格局与「中国强制造、高端光芯片待补」,来自厂商财报、供应链与行业研究的常见公开口径。本文不引用具体份额与出货数字(变化快、口径不一),统一用结构与趋势表述。数据截止 2026 年中。
- 相关产业观察:万卡集群网络拓扑(需求根因)、英伟达 AI 产品矩阵(整柜网络)、HBM 与先进封装(另一处封装价值高地)、从卖盒子到卖 Token。
- 同批待写延伸:InfiniBand vs 以太网/UEC(D2)、硅光与 CPO(D4)、交换机芯片(D5)、铜缆回潮(D6)。
一句话总结:AI 集群的东西向流量与无阻塞胖树使高速端口数数倍于 GPU,每条链路两端各需一个光模块,再叠加 400G→800G→1.6T 的速率升级带来量价齐升,使光模块成为不押注芯片架构、只赌算力规模的最确定卖铲生意;技术上 EML 与硅光支撑当前高速可插拔模块、CPO 是降低功耗的下一代前瞻形态,格局上中际旭创、新易盛等中国厂商凭高速光电封装与规模良率进入全球第一梯队、深度绑定北美云和网络龙头,但高端激光器/CW 光源/DSP 等最上游光电芯片仍由美日主导、是国产替代的深水区——中国已赢在「把光器件高良率做成模块」的中游制造,下一程是向最值钱的上游器件延伸。