训练数据的版权战争:诉讼、授权与一场多方博弈
今天每一个令人惊艳的大模型背后,都站着海量被“读”过的文字、图片和代码;而这些内容,绝大多数是 AI 公司从互联网上抓取、由真实的创作者和机构所生产、且原本受版权保护的。于是一个绕不开的问题被推到台前:未经权利人许可,把作品拿去训练模型,到底算不算侵权? 作家、出版社、新闻机构、图片社纷纷起诉,AI 公司则援引“合理使用”抗辩。这场战争不只是法律条文之争,它决定着未来 AI 的数据从哪来、要付多少钱,也决定着互联网“免费可抓取”的旧规则是否会被重写。
先说结论
- 争议核心是两个法律问题:训练中对作品的临时复制是否侵权,以及这种使用是否构成合理使用/转换性使用(transformative use)——不同国家、不同法院口径并不一致。
- 原告覆盖一整条内容产业链:作家、图书出版商、新闻媒体、图片/插画社、代码与社区平台,它们共同主张“用我的内容赚钱,就该分我一杯羹”。
- AI 公司的抗辩是“训练是学习而非盗版、输出不必然复制原作”,并强调若动辄侵权,整个产业与技术进步将难以为继。
- 终局更可能是集体授权 + 按量/按约付费 + opt-out 机制,而非全面禁止训练:因为双方最终都需要彼此——AI 需要高质量真实数据,权利人需要新收入。
- 结果会系统性抬高数据成本、重塑数据供给:付费授权、自有/专有数据、合成数据和政府公共数据的权重都会上升。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键争议 | ① 训练复制是否属合理使用/转换性使用(TRL-3,判例分化)② 输出与原作的实质性相似举证(TRL-3)③ 数据抓取是否违反平台条款(TRL-3~4)④ opt-out 与授权机制(TRL-3) |
| 主要玩家 | 原告:作家/出版商、新闻集团等媒体、Getty 等图片社、作者集体组织;被告:OpenAI、微软、谷歌、Meta、Stability 等;裁判:各国法院与立法者 |
| 做到什么程度 | 全球多起标志性诉讼并行,部分和解、部分裁决对双方各有胜负;AI 公司已开始与头部出版机构签订付费授权协议 |
一、争议到底争什么
先把法律焦点讲清楚,否则很容易把“用了我的东西”和“一定违法”画等号——在版权法里,事情要复杂得多。
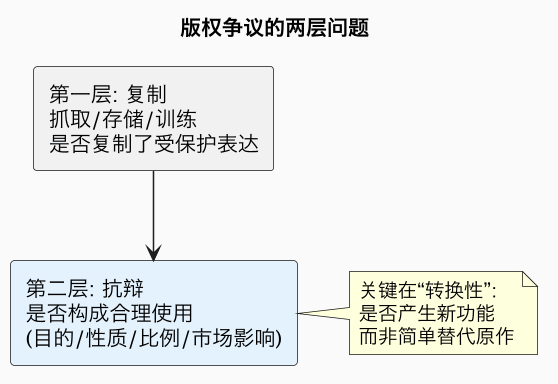
第一层是复制行为本身。模型训练需要把作品下载、存储,并在预处理与训练中反复读取,这通常构成版权意义上的“复制”。权利人据此认为,未经许可的复制就是侵权的起点。
第二层,也是真正的胜负手,是合理使用(fair use,美式)或类似的著作权例外。判断合理使用通常要综合考虑使用目的与性质、被使用作品性质、使用比例,以及对原作品潜在市场的影响。AI 公司主张,训练是让模型“学习”语言与事实规律,类似人类阅读后获得理解,产出的是一个全新的功能(生成能力),并不会原样吐出受版权保护的表达,因此属于高度“转换性”的使用,且不替代原作市场。权利人则反驳:模型恰恰可能在提示下逐字复现原文,而且 AI 产品正在侵蚀搜索、写作、配图等原本属于内容方的市场。由于这些要素高度依赖具体事实,不同法院、不同国家得出不同结论并不奇怪——这也是当前判决分化、胜负交织的根本原因。
二、谁在起诉:一整条内容产业链
原告并非单一群体,而是所有“内容被大规模拿去训练”的创作者与机构。
| 原告类型 | 代表诉求 | 关注点 |
|---|---|---|
| 作家 / 作者集体 | 书籍、作品被无偿用于训练 | 逐字复现、署名与报酬 |
| 图书 / 学术出版商 | 版权库被批量抓取 | 数据库与出版物的授权 |
| 新闻媒体 | 新闻内容喂养 AI、冲击搜索流量 | 营收被蚕食、品牌与引用 |
| 图片 / 插画社(如 Getty) | 图像训练、风格与水印模仿 | 图像版权与商业竞争 |
| 代码 / 社区平台 | 开源协议遵守、平台条款 | 许可证合规(如 GPL 类) |
作家与出版商是最早、也最具象征意义的一方,他们强调自己多年创作的成果被瞬间复制成了别人的资产。新闻媒体的愤怒更直接:生成式 AI 和 AI 搜索正在改变用户获取信息的方式,媒体既被拿去训练,又可能在流量端被绕过,等于“双重失血”,相关冲击见AI 搜索与广告。图片社则握有大量“模型生成图与受版权图像高度相似”的直观证据。代码与开源社区关注的是另一条线:开源许可证(尤其 Copyleft 类)对署名、衍生作品开源的要求是否被遵守。这些玩家看似分散,诉求却高度一致——“你用我的内容构建了价值数百亿的产品,我应当有控制权和分成。”
三、AI 公司的防守与现实妥协
面对密集诉讼,AI 公司一边在法庭上强硬抗辩,一边在商业上悄然务实。
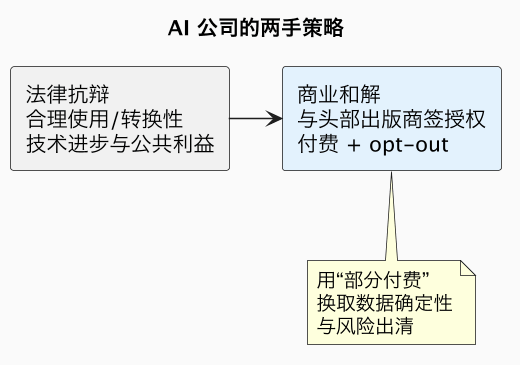
在法庭上,AI 公司坚持合理使用立场,并提出一个有分量的政策性论点:如果对训练数据施加严格的事前授权义务,后来者将因无法承担海量谈判与费用而被巨头垄断,创新与竞争反而受损,这与版权法“促进进步”的初衷相悖。
但在商业上,它们很快展现了灵活的一面:纷纷与有影响力的出版集团、新闻机构签订付费授权协议,允许对方选择退出(opt-out)抓取,并在产品中加强对引用来源的标注。这种“打一部分、买一部分”的策略很现实——与其在不确定的诉讼中长期暴露、并随时可能失去高质量数据源,不如用可控的费用锁定优质内容、把法律风险出清。对头部内容方而言,这也是比“打到底把 AI 逼走”更划算的结果:与其追求难以执行的全面禁止,不如把新对手变成付费客户。双方的理性选择,正在把战争从“是否允许”推向“按什么价格、什么规则允许”。
四、终局:授权化、付费化与数据供给重构
把视角拉远,这场战争最可能的结局,是一套新的数据获取秩序,而不是任何一方被彻底击垮。
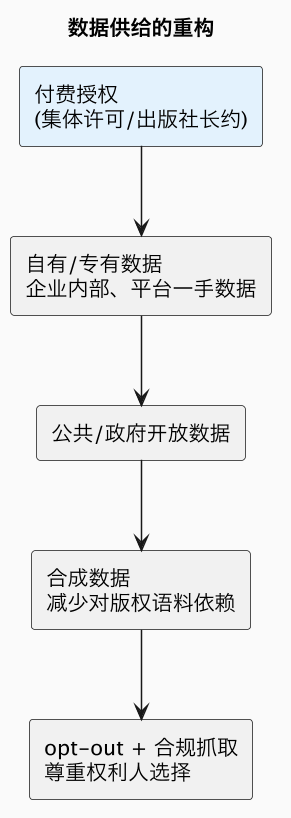
最可能成形的是集体授权机制:类似音乐行业的著作权集体管理,由作者组织、出版商或平台统一代表权利人谈妥许可与分成,AI 公司按用量或订阅付费,从而避免与海量权利人逐一谈判的高昂交易成本。配套的是清晰的 opt-out 规则、来源标注与透明义务,部分国家和地区也在通过立法(而非仅靠诉讼)确立 AI 训练的文本与数据挖掘例外,同时保留权利人获偿或退出的权利。
这套新秩序会带来一个确定的经济后果:数据不再是近乎免费的公共品,而成为要计入成本的生产要素。 高质量真实语料的获取价格上升,会促使 AI 公司更多转向自有/专有数据、与内容方深度绑定、利用政府开放数据,并大力发展合成数据以降低对版权语料的依赖,详见合成数据产业。头部巨头因能承担授权费用、掌握分发渠道而更有优势,初创公司则可能受成本挤压——讽刺的是,本为保护创作者而提起的诉讼,客观上也可能加固大公司的数据壁垒。未来三年,“数据怎么合法地拿到、要花多少钱”,会和“模型有多少参数”一样,成为决定 AI 竞争力的核心变量。
常见误区
- 误区:用了受版权内容训练就一定侵权。 是否侵权取决于合理使用等抗辩,而这在不同法域、法院之间存在真实分歧,尚无全球统一结论。
- 误区:AI 公司会拒绝一切付费。 它们一边抗辩、一边已与大量头部内容方签订付费授权,务实买“确定性”。
- 误区:权利人希望彻底禁止 AI 训练。 对多数内容方而言,把 AI 变成付费客户、建立分成机制,比难以执行的全面禁止更划算。
- 误区:这场诉讼只关乎法律。 它最终会抬高数据成本、重塑数据供给,并可能强化巨头相对初创的优势。
总结
训练数据版权战争争的不是“AI 能不能读内容”,而是“读了该不该付、按什么规则付”:在合理使用抗辩与一整条内容产业链的索赔之间,终局大概率不是封禁技术,而是集体授权、按量付费加 opt-out 的新秩序——数据从此成为明码标价的生产要素,并深刻改变 AI 的成本结构与竞争格局。
相关与延伸
- 数据为何稀缺:训练数据墙
- 替代方案:合成数据产业
- 人工数据环节:数据标注与 RLHF
- 流量端冲击:AI 搜索与广告