FPGA 专家 28:加速架构——先想清楚屋顶和墙,再写 RTL
本文是
fpga/专家层第 31 篇。HLS 实现优化(pipeline/unroll/dataflow)见 专家 19,具体网络卸载见 专家 32,AI 推理见 专家 34。
一、快的来源:定制化,而非主频
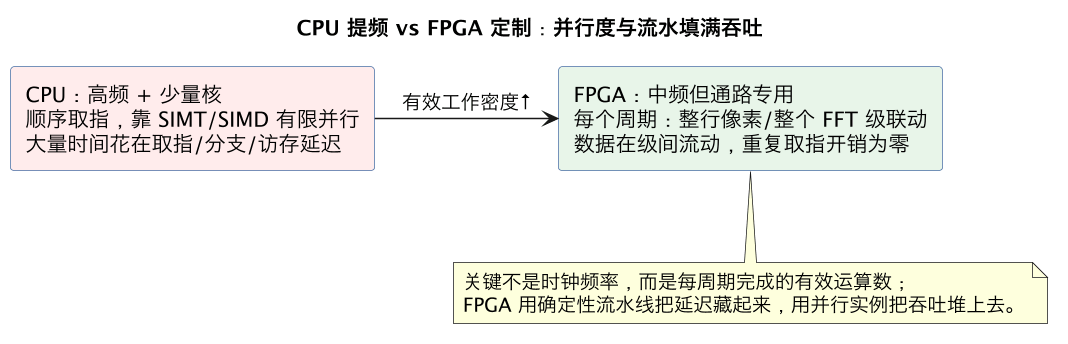
| 维度 | CPU | FPGA |
|---|---|---|
| 主频 | 高 | 低(百 MHz) |
| 并行 | 有限核/SIMD | 为算法定制任意流水线与通路 |
| 数据宽度 | 固定(8/16/32/64) | 任意位宽、任意精度 |
| 延迟 | 受 cache/调度抖动 | 确定、周期可算 |
| 灵活性 | 任意程序 | 基本只做这一个电路 |
三种并行:流水线(每拍一个结果)、空间展开(复制 N 个单元)、多引擎数据并行;Amdahl 提醒:先找串行/不可卸载比例。
二、roofline:开工前先定位瓶颈
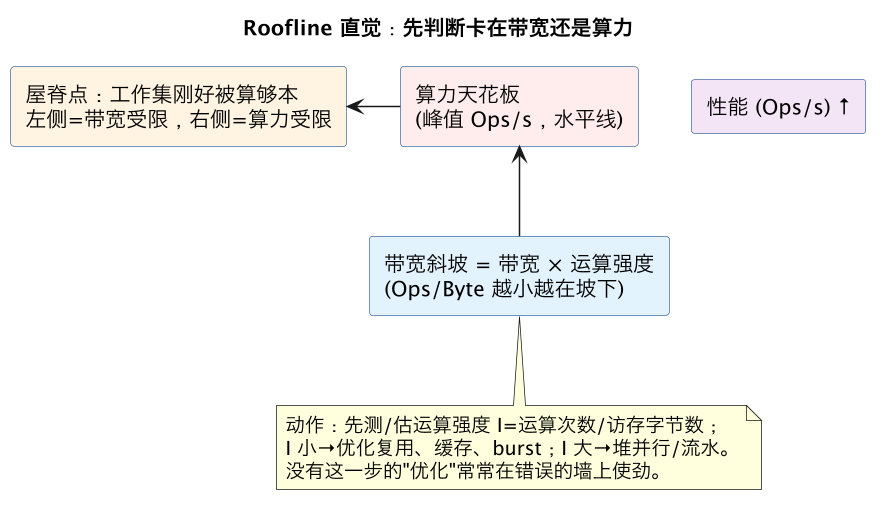
GOPS │                    ___________ 算力屋顶(DSP×频率)
     │                 _/
     │              _/
     │  访存斜墙   _/  (性能 = AI × 带宽)
     │        __--
     │____---
     └──────────────────────────── 算术强度 AI (ops/byte)
memory-bound │ compute-bound- 低 AI(解码、压缩、逐像素)→ 优化搬运与复用;
- 高 AI(矩阵、大 FFT)→ 优化算子并行度。
三、存储层级:把字节"算够本"再丢
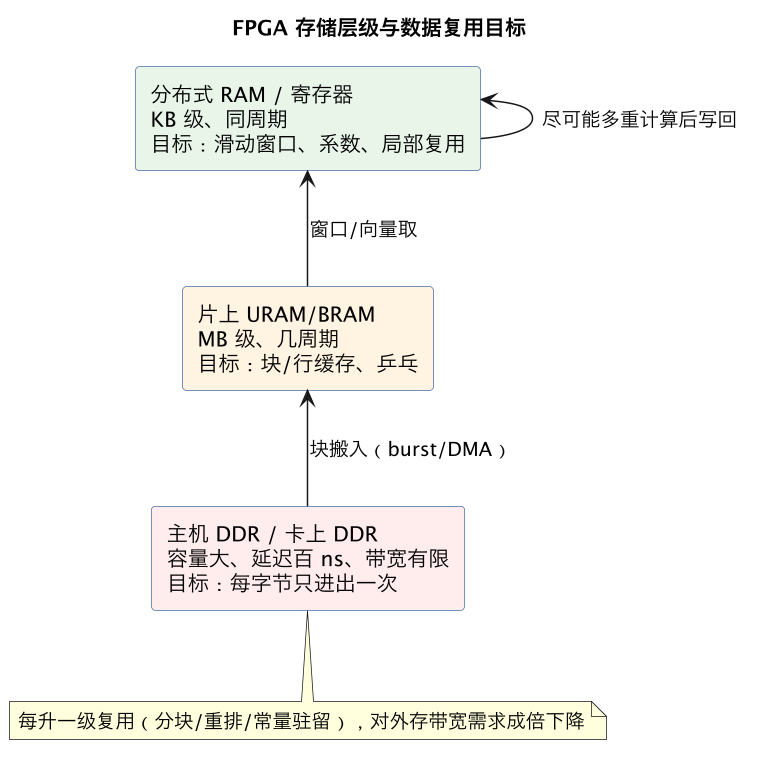
DDR(大、慢、GB/s) ──DMA──► URAM/BRAM(MB级、ns) ──► 分布式RAM/寄存器(算)
                          ▲
       tiling / line-buffer / 权重驻留 / 乒乓 / 算子融合
                  目标:每字节片外流量 → 尽量多运算
四、三种数据通路形态
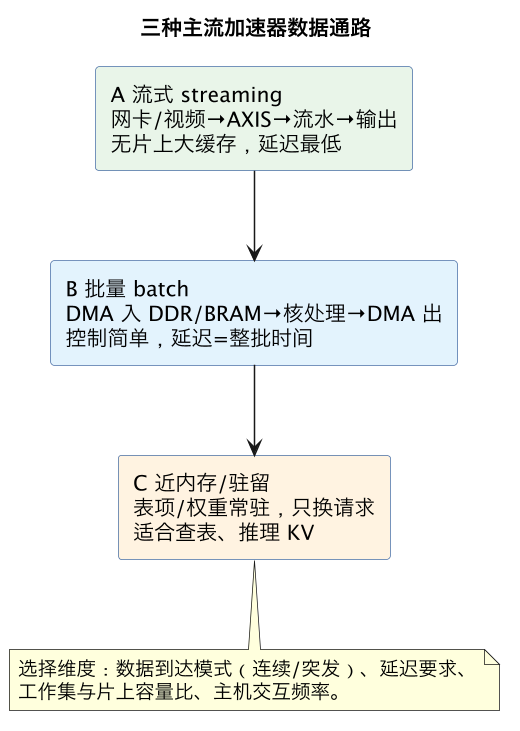
- 流式 stream:valid/ready 逐拍穿过多级,几乎不缓存,适合线速网络/视频。
- 批式 batch:DMA 大块入片上 → 算 → 写回,适合矩阵/分析。
- 线上旁路 bump-in-the-wire:FPGA 串在数据路径上原地看/改数据,省掉主机往返,卸载收益最大。
五、卸载边界决策
- profile 找热点、套 Amdahl 看天花板;
- 算 AI 与搬运成本(含 PCIe 往返);
- 规则/固定/流式/确定延迟 → FPGA;控制/不规则/易变/稀疏 → CPU;
- RTL 里埋性能计数器(引擎忙碌率、反压周期、DDR 效率),上板后用真实数据验证屋顶模型假设。
六、计算 roofline 深化:带宽、算力与工作集的定量推演
roofline 模型之所以值得单独深挖,是因为它把“这个 kernel 到底能不能在 FPGA 上加速、瓶颈在哪、该优化什么”变成了一张可以定量推演的图,而不是凭感觉争论。横轴是运算强度(arithmetic intensity),即每字节数据搬运支撑多少次运算(单位 ops/byte);纵轴是可达性能(ops/s)。图上有两条边界:一条水平线是硬件的峰值算力(由并行度、频率、DSP 数量决定),一条斜线是“带宽 × 运算强度”(由数据搬运能力决定)。一个 kernel 的实际性能不可能超过两者中较低的那个,于是斜线与水平线的交点(ridge point)把空间分成两区:运算强度低于交点的 kernel 受带宽限制,加再多计算单元也没用,性能贴着斜线走;高于交点的受算力限制,加并行/提频才有效。
用 FPGA 时要分别标定这两条线,且都要用有效而非标称值。算力侧:一个含 N 个处理单元、每单元每周期做 C 次运算、跑在 f 频率的管道,峰值是 N×C×f,但要扣掉流水线气泡(启动/排空、数据依赖、分支)、资源打折和实际能达到的频率。带宽侧要逐层算:DDR 理论峰值 = 时钟×2(DDR)×总线字节数×效率系数,实测持续带宽通常只有理论的 70%~90%,且访问模式(连续突发 vs 随机、是否跨 bank、刷新冲突)影响巨大;片上 BRAM/URAM 带宽高得多但容量小;PCIe 还有一个独立的 host↔device 带宽边界。很多“FPGA 没加速”的失败,本质是只画了算力线、忽略了 host PCIe 这条更低的边界——kernel 在片上算得飞快,数据却要经 PCIe 来回搬运,端到端 roofline 的最短板在机箱外。
用模型指导优化的顺序因此非常清晰。第一步是提升运算强度(把字节“算够本”),这是收益最大、且 FPGA 最擅长的方向:数据从 DDR 读进片上后,在一个或多个级联的计算阶段里被反复复用,做尽可能多的运算再写回;融合多个算子(kernel fusion)消除中间结果落盘;用片上缓存/行缓冲(line buffer、window buffer)让邻域计算的数据在 PE 间滑动复用而非每点重读;调整循环顺序和分块(tiling)让工作集落进 BRAM。运算强度每提高一档,kernel 在 roofline 上右移,可能直接从带宽区跨到算力区。第二步才是在确定瓶颈后扩展对应资源:带宽受限就加突发宽度、多 bank 并行、压缩数据、减少搬运;算力受限就复制 PE、加深流水线、提频。把顺序倒过来(先堆 PE)是最常见的浪费。
工作集与存储层级的匹配是 roofline 落到具体实现的关键。要把每一层数据(输入流、权重、中间张量、状态)的大小和复用模式列出来,对照 BRAM(每块几十 Kb、可拼成任意宽度、并行度高)、URAM(更大、适合大块缓存)、DDR(GB 级但延迟和带宽受限)的容量与带宽,决定谁驻留哪里、谁流过、谁分块。一个实用检查是:内层循环反复访问的数据结构必须放进片上,否则它会把运算强度拖回 DDR 边界;而只顺序访问一次的大数据则适合流式穿过、根本不必缓存。roofline 与存储分层两张图合起来,基本能在写一行 RTL 之前就判断一个加速方案的天花板和主要工作,这正是架构设计阶段最该做的“纸面拒错”。
最后要强调 roofline 的边界条件:它是稳态吞吐模型,不直接回答延迟(低延迟目标见 专家 35);它假设可流水线化、可并行,对强数据依赖、控制发散、动态数据结构的 kernel 适用性差(这些往往不是 FPGA 甜区);它对“稀疏/条件执行”会高估有效算力(PE 因数据无关而空转)。因此建模时要按有效运算/有效字节计数,并为不规则性预留利用率折扣。即便如此,roofline 仍是开工前性价比最高的一次分析:它强迫团队量化“数据从哪来、被复用几次、瓶颈在片上还是机箱外”,把架构争论从立场之争变成算术之争。
七、流水线并行的实现细节:喂满、反压与气泡管理
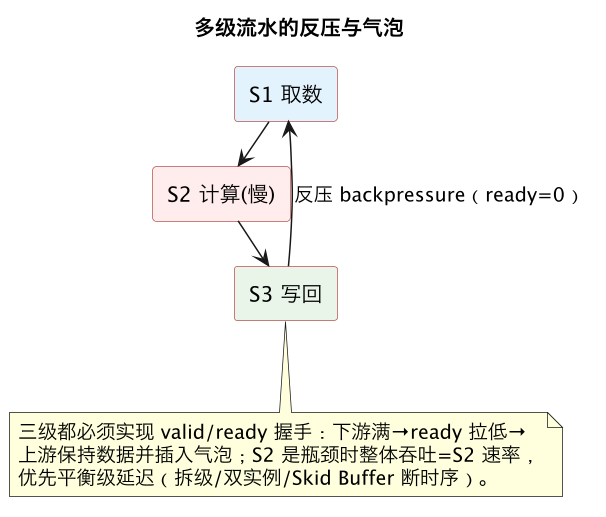
把算法映射成 FPGA 电路,最核心的两种性能结构是流水线(把一次运算切成多级、不同级同时处理不同数据,提吞吐)和并行复制(多个相同处理单元同时处理不同数据,提吞吐)。理解它们的实现纪律,是让纸面的峰值算力变成实测吞吐的关键——绝大多数加速器达不到理论峰值,不是算子不对,而是管道没被喂满、气泡太多或反压没处理好。
流水线的吞吐取决于最慢一级和气泡比例。一条 k 级流水线处理一个数据流,稳态时每周期出一个结果(单吞吐率),延迟是 k 周期但吞吐与级数无关;真正决定吞吐的是最慢那一级的延迟(时钟周期必须 ≥ 最慢级,所以要尽量把各级切均衡,必要时把重级再切两半)和气泡(bubble)比例。气泡来自:流水线启动/排空(一批数据太短,填充和排空的固定开销占比高,所以要追求长流、大批量);数据依赖(后一个输入要等前一个结果,寄存器反馈环路插不进流水);分支与条件(某些级在特定数据上无事可做);资源停顿(访存没准备好、下游满)。优化的直觉是:让数据流尽量长、尽量规则、尽量无反馈依赖,把有依赖的操作重排或预取,把短批聚成长流。
反压(backpressure)与有效/就绪(valid/ready)握手是流水线工程里最容易出 bug 的地方。真实系统里上下游速率不恒定:上游可能突发、下游可能因为 DDR 忙或缓冲满而暂时不能接收。每一级都必须能在“输出有效但下游不接收”时保持数据和有效信号不变(stall),同时反压它的上游。标准做法是每级带使能的流水线寄存器:当本级有效且下游未就绪时,本级保持;否则锁存新数据。常见错误包括:只做 valid 不做 ready(假设下游永远能收,一旦停顿就丢数)、反压信号组合逻辑形成环路导致时序崩、stall 时 valid 标志处理错导致数据重复或丢失。AXI4-Stream 的 valid/ready/last 语义是这类握手的工业标准,设计和验证都应对齐它,而不是自造一套微妙不同的握手。
并行复制的核心难题从计算转向供给与归并。复制 N 个 PE 能把算力乘以 N,但要求:输入带宽够喂 N 份数据(否则 PE 饿肚子,roofline 立刻落到带宽边界);任务能无依赖地切分(数据并行最理想,如独立信道、独立图像块、独立报文);N 路输出能被正确归并(顺序、仲裁、归约)。供给侧常用宽总线 + 拆包(一个宽事务拆给多个 PE)、多 bank 并行访问、片上分发网络;归并侧要用仲裁树或归约树,并处理“顺序敏感”场景——如果输出必须保持输入顺序(很多网络/存储通路要求),乱序完成的 PE 结果要带序号重排(reorder buffer),这部分逻辑和缓冲不可忽略。并行度 N 不是越大越好:当带宽、片上存储或 DSP 成为瓶颈,或频率因拥塞下降时,N 超过最优点后实测吞吐不升反降,还浪费资源、恶化时序。正确做法是参数化 PE 数量,扫 1/2/4/8… 实测吞吐、资源、频率,取拐点。
调度与控制结构决定数据如何在这个时空阵列里流动。简单的静态调度(控制器按固定时序发命令、数据规则流动)效率最高、逻辑最省,适合规则流式;带条件和稀疏时需要动态调度(PE 有活干才发、空结果跳过),灵活但有仲裁和负载均衡开销,且控制本身可能成为瓶颈。片上网络/互连(crossbar、NoC、多级 AXI 互联)在大规模 PE 阵列中决定数据怎么路由,它的资源和时序代价常被低估。实践中宁可先用简单、规整、可参数化的结构把一类 kernel 做到 roofline 附近,也不要过早追求能处理任意模式的复杂互连——后者往往跑不满、收不齐、时序还差。
验证这类结构时,stall 注入和随机反压是必备手段:在仿真中随机拉低 ready、随机停顿任意一级,跑大量数据与黄金模型比对,确保任何停顿组合下不丢数、不重数、(要求保序时)不乱序。只在“永不反压”的理想测试台上验证通过的流水线,上板几乎必在真实带宽波动下出错。把反压验证做成标准测试台组件,能挡掉数据通路里比例最高的一类 bug。
八、控制面、主机交互与任务调度:让加速器成为可调用的服务
一个真正可用的加速器,不只有数据通路,还需要一套让主机能够提交任务、传递数据、获知完成、处理错误、并发复用的完整机制。这部分(控制面与调度)常常比单个 kernel 更决定实际可用性和利用率,却最容易在“先把算法跑通”的阶段被忽视,等到多任务、多进程、多卡时才发现架构不支持。
任务提交的抽象层级有一个演进谱系。最原始的是裸寄存器:主机直接写控制寄存器(启动、地址、长度、模式),轮询状态位,一次只能有一个任务,简单但完全无法并发。进一步是命令队列/描述符环:主机在内存里准备一个或多个环形队列,每个描述符写明输入/输出缓冲地址、长度、操作码、标志;加速器按序或乱序消费,通过门铃(doorbell)寄存器通知“有新命令”,通过完成队列或中断通知“命令做完”。这使主机可以一次排多个任务、让加速器在主机做别的事时持续有活干,是高利用率的关键,也和 专家 29 的驱动机制对齐。再往上是多队列/多上下文:为不同进程/虚拟机/优先级维护独立队列,加速器内部做调度与隔离,支持多租户和 QoS;最高层是把加速器抽象成一个可被框架(OpenCL、自研 runtime、图编译器)调度的设备,接受计算图/算子描述而非裸命令。
数据传递的零拷贝与一致性策略要在架构期定好。理想路径是主机把缓冲区交给加速器、加速器经 DMA 直接读写、双方共享内存而不在中间倒手;这要求加速器侧支持散列-聚集(scatter-gather,一个命令描述多段不连续内存)、虚拟地址到设备地址的转换(经 IOMMU 或由驱动 pin 后传总线地址)、以及明确的缓存一致性责任。架构上要决定加速器是否参与一致性(coherent)、是否有自己的 MMU/地址翻译、是否支持主机和设备并发访问同一缓冲。这些选择会写进 DMA 引擎和命令格式,后期很难改。
调度策略决定多个任务/多个 PE 之间怎么分配工作。批量/静态调度适合规则、同类、大批量任务:一次性把数据切块分给所有 PE,开销最小、最容易喂满。任务并行(不同命令用不同 kernel 或模式)需要加速器能在不同 kernel 间切换——要么重配置(慢,见部分重配置),要么在片上同时容纳多个 kernel 并按命令路由(overlapping kernels),用空间换切换开销。优先级与延迟插队对低延迟业务重要:控制队列要允许高优先级命令抢占或旁路长批量命令,否则一个大吞吐任务会把延迟敏感命令堵在后面。调度器还必须处理背压和资源依赖:当内部缓冲、DDR 带宽、PE 都占满时停止取新命令,而不是无限接收后死锁;有依赖关系的命令(A 的输出是 B 的输入)要么由主机排序,要么加速器支持等待/事件标志。
完成、错误与可观测同样是控制面的一等公民。完成语义要定义清楚:命令完成是“数据已写回且对主机可见”还是仅“计算完但还在缓存”,两者差别决定主机能否立刻读结果(涉及缓存刷新)。错误要能精确定位到命令并上报类型(DMA 错误、非法地址、校验错、kernel 内部异常、超时),而不是一个笼统的“设备错误”;一个坏命令不应拖垮整个队列,需要定义错误后队列是停住、跳过还是复位。可观测性要求加速器暴露性能计数器(入队/完成数、空转周期、各队列深度、DDR/PCIe 带宽利用率、反压次数、各类错误),这些计数器是线上调优和故障定位的主要依据——没有它们,“加速器变卡了”完全无从分析。
九、典型坑与架构评审清单
加速架构的失败大多不在 RTL 语法,而在架构假设与系统接缝。把高频坑和评审时应逐项过的检查点集中如下。
误判瓶颈类:只算峰值算力不算搬运、忽略 host↔device PCIe 边界、假设 DDR 能跑到理论峰值、把芯片数据手册数字当端到端性能。正解是开工前画含所有存储层级和 PCIe 的完整 roofline,用实测有效带宽和有效运算强度,先提运算强度再堆算力。
管道喂不满类:数据批太短导致启动/排空开销占比高;没有反压或反压有 bug,真实带宽波动时丢数;并行 PE 供给不足空转、输出归并成瓶颈;要求保序却没做重排。正解是追求长流、标准 valid/ready 握手、参数化 PE 数扫拐点、用随机 stall 测试台验证不丢不乱。
存储层级错配类:内层复用的数据留在 DDR、只访问一次的数据反而片上缓存;工作集超过 BRAM 没有分块;忽略多 bank 冲突。正解是列出每层数据的大小/复用/生命周期,按 roofline 决定驻留与分块,内层热数据进片上。
主机交互薄弱类:裸寄存器一次一任务、主机全程轮询、无描述符环、完成语义含糊、无错误定位、无性能计数器。正解是命令队列 + 门铃 + 完成/中断 + 精确定位错误 + 全套计数器,按“可并发服务”设计控制面。
数据一致性/生命周期类:DMA 缓冲未 pin、用错地址、缓存未同步、硬件还在用内存主机已释放。正解是与驱动共同定义共享内存契约和所有权状态机(详见 专家 29)。
盲目追求 FPGA 类:对规则稠密张量负载硬上 FPGA 而不与 GPU 对比;为 FPGA 而 FPGA,忽略开发成本和生态。正解是 PoC 阶段做 CPU/GPU/FPGA 端到端对比,落在低延迟流式、位级/不规则并行、定制流水线甜区才投入。
架构评审清单:①有含 PCIe/DDR/片上各层的 roofline,kernel 运算强度与瓶颈已定量;②内层热数据复用方案(融合/行缓冲/分块)明确,工作集与 BRAM/URAM 匹配;③数据通路全流水、级数均衡、反压语义标准;④PE 并行度有实测拐点而非拍脑袋;⑤控制面支持命令队列/门铃/完成/错误定位/性能计数;⑥DMA 零拷贝、地址翻译、一致性责任清晰;⑦有随机 stall/反压的端到端验证;⑧有与 CPU/GPU/ASIC 的正面对比和批量/成本依据;⑨kernel 切换/多任务/优先级策略已定义;⑩频率、资源(LUT/FF/BRAM/DSP/URAM)在预算内并留裕量。这份清单应在写 RTL 前的架构评审上逐条通过,它挡掉的错误远比后期调时序时补救便宜。
十、加速器微架构模式库:流式、批量与状态机三类模板
落地一个数据通路时,与其每次从零设计,不如先判断它属于哪一类经典微架构模式,再在模板上裁剪。第一类是纯流式(streaming):数据从输入端流入,穿过一串固定功能的流水级,每级只保留少量行缓冲或局部状态,流出即结果,几乎不随机访问内存。网络包处理、实时滤波、压缩加密、传感器流水线都是这一类。它的优点是延迟确定、控制简单、容易做到每周期一个数据;设计重点在各级均衡、反压握手和偶发的“难样本”(一个需要多周期的特殊包如何旁路到慢路径而不堵死主流)。判断一个功能是否适合流式,关键看“处理当前数据是否依赖大量历史或未来数据”,依赖越少越适合。
第二类是批量分块(block/batch):先把一个数据块取进片上缓存,在片上反复计算直到该块完成,再整体写回。矩阵乘、卷积、大 FFT、排序归并属于此类。它的核心是分块尺寸与存储层级的匹配:块要小到放得进 BRAM/URAM,又要大到让片上复用次数足够高,使运算强度越过 roofline 的拐点;块之间用双缓冲掩盖搬运,使“算第 N 块”和“搬第 N+1 块”重叠。这类微架构的典型风险是边界块(行列不足、补零、尾部不满)的处理,它们往往和主体路径时序不同却最容易出 bug,应当在架构期就定义统一的边界协议,而不是用一堆特判补丁。
第三类是状态机驱动(control-centric):数据移动和计算由一个显式控制器按步骤调度,常用于不规则、数据依赖、需要多轮访问内存的算法(链表遍历、图计算、稀疏矩阵、协议栈慢路径、动态调度器)。这类模式的性能不取决于算力而取决于控制开销和访存延迟隐藏:每一步的等待能否被其他待发请求覆盖(多未完成请求窗口)、能否把不可预测的访问重排成更友好的序列、状态机本身会不会成为单点瓶颈。设计时要把控制器与数据通路解耦——控制器只发命令和收完成事件,具体搬运交给 DMA 和缓冲,避免让一个庞大的集中式状态机直接控制每个多路选择器,那会既难收敛时序又难验证。
真实系统几乎总是三类混合:入口和出口是流式,核心计算是批量分块,整体由状态机/命令处理器编排。评审一个微架构时可以问三个问题:数据在哪个时刻驻留在哪一层存储、谁在那个时刻控制它、这一步的延迟是固定的还是依赖数据的。把这三个问题在时间轴上画清楚,大多数“跑不快”“偶尔死锁”的问题在写 RTL 前就暴露了。此外,无论哪类模式都应参数化(位宽、并行度、缓冲深度、流数量),让同一套 RTL 能按 roofline 拐点和器件资源扫描配置,而不是为每个产品重写——参数化的数据通路配合固定的握手协议,是加速器 IP 可复用的基础。
十一、性能建模与容量规划:用电子表格管理架构决策
专业的加速架构不是“先做出来再测”,而是在 RTL 之前用一个可计算的性能/资源模型指导所有关键决策,并在实现后用实测持续校准模型。模型不需要很精确,但必须结构正确、参数可改、能回答“如果……会怎样”。它通常是一张电子表格或简单脚本,输入包括:数据量、每层算法的运算量和字节数、各存储层级的实测/手册带宽与延迟、目标频率、各级流水和并行度、流水线填充排空开销、DMA 与中断开销、主机往返成本;输出是稳态吞吐、端到端延迟、各资源(LUT、FF、BRAM、URAM、DSP)的预估占用和利用率。
建模的关键纪律有几条。其一,所有带宽用有效值:DDR 打七到九折、PCIe 按有效载荷与 TLP 开销折算、片上互联按仲裁后的实际份额,宁保守勿乐观。其二,把启动和排空摊进去:短任务的流水线填充、DMA 建立、中断和软件开销可能占掉端到端时间的一大半,稳态吞吐只在足够大的批量下成立,模型要同时给出“大批量渐近性能”和“典型小批量实际性能”两条曲线。其三,资源估算分项且留裕量:数据通路、控制、调试探针、互联和 DMA 各自计列,时钟/复位/调试基础设施本身也吃资源,总和留出一两成给布线和后期修改。
模型最重要的用途是做敏感性分析和决策剪枝:把并行度、分块大小、频率、是否上零拷贝等当作变量扫描,看系统性能在哪个区间受带宽限制、在哪个区间受算力限制、拐点在哪里、资源随性能如何增长。很多争论(要不要加 PE、要不要换更宽总线、要不要换更大器件)在图上一眼可决:若处在带宽平台区,加 PE 纯属浪费;若距离拐点很远,先优化数据复用即可。容量规划还要覆盖非吞吐资源:BRAM 块数(受并行 FIFO 和表项数量而非总比特数限制)、时钟缓冲和时钟区域、高速收发器 lane 数、AXI 互联的端口数(互联面积常被低估),这些“第二资源”往往比总 LUT 更早成为瓶颈,应在模型中单列。
模型要随项目存活而不是一次性文档:综合后回填真实资源、板测后回填有效带宽和延迟、每次架构变更更新曲线。这样团队积累的是越来越准的“架构直觉数据库”,下一个项目的早期估算就有据可依。最终的验收指标也从模型导出:吞吐目标、尾延迟目标、资源上限、可接受的最小批量,都写成数字写进规格,而不是“尽量快”。用模型管理架构,本质是把直觉争论变成参数讨论,这是加速项目从“个人英雄”走向“可重复工程”的标志。
十二、从原型到产品:加速器的可演进设计
一个成功的加速器很少一次定型,算法、接口、性能目标都会随客户和标准演进,架构在第一天就要为这种演进留出结构上的余地,否则第二版往往等于重写。可演进性体现在几个具体决策上。接口稳定化是第一位:数据面统一用标准流接口、控制面用寄存器/描述符的稳定抽象,内部微架构可以随意重写而不影响驱动和上下游 IP;把私有握手散落到系统各处的设计,每次内部优化都会引发连锁修改。与主机的契约(命令格式语义、完成顺序、错误上报)要版本化,新增字段用保留位扩展,旧驱动可优雅降级。
计算与编排分离决定了适应新算法的成本。把“做什么”(一系列命令/微操作描述的工作)和“怎么做”(固化的数据通路)分开:通用部分做成可配置的算子单元和可重载的表/系数,控制序列由命令流甚至微码描述。这样一类算法内的变体(不同核大小、不同步长、不同网络层)不必重新综合,换命令和参数即可;跨代的新算子才需要新增硬件单元。要避免的两个极端:把一切都做成一个什么都能算的巨型可配单元(资源爆炸、时序差、验证无望),以及为每个小变种都固化一条新流水线(维护分叉地狱)。合理粒度是“覆盖一个明确算法族的一组参数化算子 + 稳定编排器”。
资源与频率的代际余量也要规划:选器件时不只满足当前版本,而考虑下一代算法可能增加的片上缓存和算子;时序收敛不要贴着极限频率,留出让后续版本插入逻辑仍能收敛的裕量(时序签核的纪律见 专家 40)。片上预留少量“逃生资源”(备用 BRAM、未用的高速收发器、几个预留寄存器),后期加监控、加 workaround 时不必改板。硬件可观测性(性能计数器、trace、错误状态,见 专家 45)从第一版就内置——演进期的性能回归和兼容性问题几乎都靠它定位,后补探针常常受限于布线和资源。
演进还要管理验证资产的连续性:参考模型、测试向量、驱动和性能基准都按接口契约维护,微架构重写时整套回归应当原样复用、预期不变,新架构是在同一套契约下“更快或更省”,而不是重新定义行为。发布节奏上,能用命令/参数/表项解决的演进走不重新综合的配置更新,需要新算子的走计划内的比特流版本,结构性大改才上新平台——三级演进成本相差几个数量级,架构设计时刻意把更多变化推向低成本的那一级,产品才能跟上演进而不被每次小改动拖入漫长的重新验证周期。
总结
FPGA 加速架构的核心不是翻译代码,而是用 roofline 判断 compute/memory-bound,靠分块与数据复用抬高有效算术强度,选对流式/批式/线上旁路形态,并按 Amdahl 和搬运成本划定卸载边界——架构对了,HLS/RTL 才有意义。