寄存器映射表自动化:Markdown 一份表生成 RTL 与 C 头文件
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」中间层(intermediate)的一篇实验文,兼作寄存器表模板页。寄存器表与地址解码:软件怎么靠一组寄存器驱动硬件 讲过软硬件接口的基本面:控制/状态/数据寄存器编进统一地址空间,靠一张寄存器表约定地址、位域与访问属性。那一篇解决「表怎么写」,本篇解决一个更烦的现实问题:同一张表的信息要在 RTL、C 驱动、验证环境、文档里各抄一遍,改一个偏移量就有四处等着漂移。解法是只留一份 Markdown 表当单一事实源(single source of truth),用脚本生成其余产物,本篇实测全链路。
本文要回答的问题
- 寄存器表的「单一事实源」应该长什么样?为什么选 Markdown 而不是 Excel 或专用格式?
- 从一份表能自动生成哪些产物?RTL 头文件和 C 头文件各自该生成什么宏?
- 生成器脚本怎么写才能又小又可靠(纯标准库、无外部依赖)?
- 怎么证明生成的头文件真的能用,而不是「看着像对的」?
实验结果先给一张数据卡,数字全部来自后文日志:
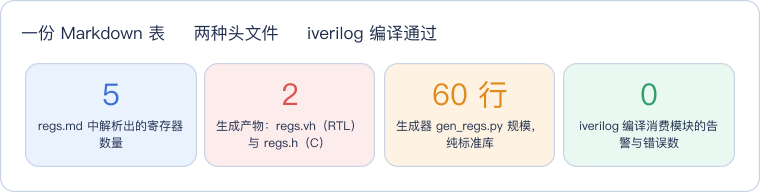
读这张卡抓住一条链:5 个寄存器是输入规模,2 份头文件是产出,60 行脚本是全部成本,0 错误是验收结论。整条链路没有引入任何重型工具——一个能跑 Python 的环境就够。
一、为什么是 Markdown:单一事实源的选型
漂移是怎么发生的?想象一个典型场景:固件工程师发现 IRQ_MASK 的中断位不够用,找硬件把寄存器从 8 位扩到 16 位、偏移从 0x0C 挪到 0x10;硬件改了 RTL 里硬编码的 localparam,文档组的 Word 版寄存器手册下周才更新,驱动里的 #define 没人记得改——三处信息源,三次手工同步,任何一次遗漏都是一个「读写错地址、现象诡异」的现场。这类 bug 的排查成本远超预防成本,因为错误表现为「寄存器写了没反应」或「读回来全是别人的值」,第一反应永远是怀疑硬件。
「寄存器信息只写一份,其他全部生成」的思路不新,业界有 SystemRDL、IP-XACT、CSRtool 等专用格式与工具链。但对中小团队和教学场景,它们的学习与维护成本常常超过收益。候选方案摆在一起比:
| 方案 | 可读性 | 版本管理友好度 | 工具链成本 | 适用场景 |
|---|---|---|---|---|
| Excel / 手工多份维护 | 高 | 差(二进制 diff 不可读) | 零,但漂移代价极高 | 一次性小项目 |
| SystemRDL / IP-XACT | 中(要学专用语法) | 好 | 重(编译器/商业工具) | 大芯片、多团队 |
| Markdown 表 + 小脚本(本篇) | 高(人即读即写) | 极好(纯文本 diff) | 60 行 Python | 中小 IP、教学、原型 |
Markdown 胜出的理由不只是「简单」:它本身就是文档——表写好了,文档章节就有了,评审时看的就是源文件本身,不存在「文档和代码对不上」的空间。git diff 里一行地址改动清晰可见,评审可以直接在 PR 里拦下「这个偏移改了,驱动那边同步了吗」。代价是表达力有限(复杂位域、中断聚合描述不了),真到那个规模再迁 SystemRDL 也不迟——格式本身就在文本里,写个转换器比重抄一遍强。
还有一个容易被忽略的收益:新成员上手成本。Excel 或内部 Wiki 维护的寄存器表,新人要先拿到账号、找到最新版、确认没被某人本地改过;而 regs.md 躺在仓库里,clone 即得,版本历史就是变更历史。表跟着代码走,评审跟着 PR 走,这三件事天然咬合在一起,不需要任何流程文档去强调「请同步更新寄存器手册」——手册就是源文件本身。
二、模板与生成器设计
模板就是一张管道符表格,六个字段:名称、偏移、位宽、访问属性、复位值、描述:
| name      | offset | width | access | reset | description          |
|-----------|--------|-------|--------|-------|----------------------|
| CTRL      | 0x00   | 32    | RW     | 0x0   | global control       |
| STATUS    | 0x04   | 32    | RO     | 0x0   | status flags         |
| BAUD_DIV  | 0x08   | 16    | RW     | 0x1B  | baud rate divider    |
| IRQ_MASK  | 0x0C   | 8     | RW     | 0x00  | interrupt mask       |
| FIFO_DATA | 0x10   | 8     | RW     | 0x00  | FIFO data port       |
生成数据流一张图看清——蓝色是唯一人工维护的输入,橙色是生成器,绿色与紫色是两路自动产物及其消费者:
设计上有三个刻意为之的取舍。第一,每个寄存器生成 ADDR 与 MASK 两个宏:MASK 由位宽算出((1 << width) - 1,32 位特例为全 1),地址解码和字段提取都用得上,比在 RTL 里散落魔法数强得多。第二,**Verilog 侧用 define 而不是 parameter 头文件**:include 进任意模块即用,不引入包依赖,和老代码风格兼容。第三,解析器只认管道表、跳过表头与分隔行,解析失败时(一个寄存器都没解析到)直接报错退出而非生成空头文件——宁可炸在生成期,不让坏文件流进编译期。
解析核心只有几行,逻辑直白:
cells = [c.strip() for c in line.strip("|").split("|")]
if len(cells) < 6: continue
if cells[0].lower() == "name" or set(cells[0]) <= set("-: "): continue
name, offset, width = cells[0], cells[1], cells[2]
regs.append((name.upper(), int(offset, 0), int(width)))
int(offset, 0) 自动识别 0x 前缀与十进制,模板里两种写法都合法;access/reset/description 三个字段本版不生成宏,但留在表里供文档与后续扩展(比如生成 UVM 寄存器模型)使用。
为什么不把 RTL 寄存器本体也生成出来?这是个真实的路线分叉:激进路线(如 CSRtool、regtool)连寄存器堆的 always 块、写一拍清、读数据选择器都自动生成,省代码最多,但生成的 RTL 风格未必符合团队规范,调试时读者面对的是「不认识的代码」。本篇走的是保守路线:只生成「常量」不生成「逻辑」——地址与掩码是纯事实,没有风格问题;寄存器堆的行为逻辑仍由人写,保留 寄存器表与地址解码 里讲的访问语义(RW/RO/W1C)的自由发挥空间。中小 IP 的寄存器堆逻辑通常就几十行,手写一次的成本很低,而常量漂移的代价是反复发生的,自动化的刀口应该切在常量上。
生成宏的命名也值得固定成纪律:REG_<名字>_ADDR 与 REG_<名字>_MASK 双后缀,全大写、下划线分词,与内核驱动风格一致。RTL 侧消费时,case (addr) 的分支项直接写宏、位域比较用 & MASK,全文搜索宏名即可列出所有消费点——审查「这个寄存器谁在读」从翻代码变成一次 grep。
三、实测实录:解析、生成、编译三段全绿
整个实验跑在 eda-golden-v1 镜像里,Python 走虚拟环境、纯标准库零第三方依赖,iverilog 负责编译验证。分三段验收:解析回显对不对、生成文件内容对不对、消费模块编不编得过。
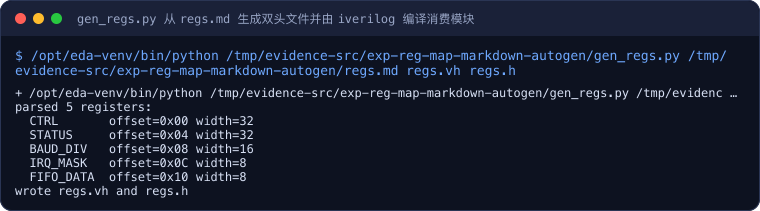
实录里 parsed 5 registers 一行后面逐个列出名称、偏移、位宽——这是生成器的「自检回显」,和源表逐行比对即可确认识别无误。五个寄存器的偏移 0x00/0x04/0x08/0x0C/0x10 连续不重叠,说明模板作者按 4 字节对齐排布,生成器原样继承了这个布局。
生成的 regs.vh 内容原样摘录如下,注意 BAUD_DIV(16 位)的掩码是 0x0000FFFF、IRQ_MASK(8 位)是 0x000000FF——掩码确实由位宽算出,不是一刀切:
// AUTO-GENERATED from regs.md -- do not edit
`ifndef REGS_VH
`define REGS_VH

`define REG_CTRL_ADDR 32'h00000000
`define REG_CTRL_MASK 32'hFFFFFFFF
`define REG_STATUS_ADDR 32'h00000004
`define REG_STATUS_MASK 32'hFFFFFFFF
`define REG_BAUD_DIV_ADDR 32'h00000008
`define REG_BAUD_DIV_MASK 32'h0000FFFF
`define REG_IRQ_MASK_ADDR 32'h0000000C
`define REG_IRQ_MASK_MASK 32'h000000FF
`define REG_FIFO_DATA_ADDR 32'h00000010
`define REG_FIFO_DATA_MASK 32'h000000FF

`endif
四、生成物验收:为什么不能「看着对」就收工
「生成物长得对」还不够,得证明「生成物真的能用」。这是所有代码生成器共同的验收陷阱:人眼扫一遍 regs.vh,地址拼写、进制、掩码位宽任何一处错了都未必看得出来,但消费模块一编译立刻现形。本篇的验收手段是写一个消费模块 reg_user.v,include "regs.vh" 后用五个地址宏做 case 译码,然后拿 iverilog 真编译:
`include "regs.vh"
module reg_user (
    input  wire [31:0] addr,
    output reg         hit
);
    always @(*) begin
        case (addr & `REG_CTRL_MASK)
            `REG_CTRL_ADDR:      hit = 1'b1;
            `REG_STATUS_ADDR:    hit = 1'b1;
            `REG_BAUD_DIV_ADDR:  hit = 1'b1;
            `REG_IRQ_MASK_ADDR:  hit = 1'b1;
            `REG_FIFO_DATA_ADDR: hit = 1'b1;
            default:             hit = 1'b0;
        endcase
    end
endmodule
这个模块刻意把五个宏全部用进 case 分支——只要有一个宏名拼错、位宽格式非法(比如生成了 32'hFFFFFFFFF 这种 33 位字面量),iverilog 在编译期就会报错。生成器改了任何输出行,重跑这条编译即回归。
实测的验收输出原样摘录:
=== compile consumer module with generated header ===
+ iverilog -g2012 -I /tmp/evidence/exp-reg-map-markdown-autogen/work -o reg_user.vvp /tmp/evidence-src/exp-reg-map-markdown-autogen/reg_user.v
+ echo 'iverilog compile OK'
iverilog compile OK
+ '[' -s reg_user.vvp ']'
+ grep -q REG_CTRL_ADDR regs.vh
+ grep -q REG_CTRL_ADDR regs.h
+ echo 'RESULT: PASS'
RESULT: PASS
这段摘录覆盖了验收的全部四道关卡:iverilog 编译零告警通过、产物文件非空、宏名在两份头文件里都存在、脚本级 PASS 落锤。regs.h 的内容与 regs.vh 一一对应(同一组地址与掩码,C 风格的 0x...u 字面量),软件驱动 #include 后和硬件看到的是同一份数字——漂移在机制上被消灭了,除非有人绕过表格直接改生成物,而文件头那行 do not edit 注释加评审流程就是防这个的。
五、落地建议与模板扩展方向
把这套机制接进真实工程,三条建议。第一,把生成器挂进 Makefile/CI:RTL 编译前先跑 gen_regs.py,生成物不进 git(只进构建目录),让「忘记重新生成」这个错误类别直接不存在。一个最小的 Makefile 片段:
GEN := build/regs.vh build/regs.h

$(GEN): regs.md gen_regs.py | build
	python3 gen_regs.py regs.md build/regs.vh build/regs.h

build:
	mkdir -p build

sim: $(GEN)
iverilog -g2012 -I build -o build/reg_user.vvp reg_user.v依赖关系写死后,regs.md 一动、整条编译链自动重新生成,人不参与其中。第二,表即评审:寄存器增删改的 PR 只许动 regs.md,评审者在纯文本 diff 里就能核地址冲突;顺带可以在生成器里加一条廉价检查——按 offset 排序后检测区间重叠,几行代码就能拦下最常见的笔误:
items = sorted(regs, key=lambda r: r[1])
for (n1, o1, w1), (n2, o2, _) in zip(items, items[1:]):
    if o2 < o1 + max(4, (w1 + 7) // 8):
        sys.exit("OVERLAP: %s and %s" % (n1, n2))
每个寄存器至少占 4 字节对齐的槽位,后一个偏移小于前一个的占用末尾即判重叠,直接非零退出——CI 红灯。第三,扩展按需生长:需要位域(field)级描述时,在表里加 field 列或在描述列约定 name[hi:lo] 语法,生成对应的 _SHIFT/_MASK 宏,比如 CTRL 寄存器的 enable[0]、soft_reset[1] 各生成一对宏,驱动里写 val | REG_CTRL_SOFT_RESET_MASK 而不是裸魔法数;需要中断聚合、计数语义、多实例数组时再评估上 SystemRDL,迁移成本因为有现成文本源而很低——写个 Markdown 到 RDL 的转换器,比重抄一遍强。
一个动手指引:把模板里的 FIFO_DATA 改成位宽 32、偏移 0x10 不变,重跑脚本,观察 REG_FIFO_DATA_MASK 从 0x000000FF 变成 0xFFFFFFFF,而其余四行纹丝不动——这就是单一事实源的价值:改一处,全链路一致地变。反向练习也值得做:手工把生成出来的 regs.h 里某个地址改掉、再重跑 make sim,看生成器如何把这份「漂移」当场冲掉——机制不怕漂移,因为漂移根本没有落脚的地方。
这一篇在知识体系里的位置
- 概念承接:寄存器表与地址解码:软件怎么靠一组寄存器驱动硬件(寄存器表本身怎么设计、位域与访问属性怎么约定);
- 译码实现:总线 slave 侧的地址译码实例(intermediate 目录 AXI4-Lite/AHB/APB 篇目);
- 工程配套:本篇生成器思路与「文档即代码」一脉相承,适合纳入 IP 工程的 CI 门禁。
一句话总结
寄存器信息的唯一事实源应该是一份人可读、git 可 diff 的 Markdown 表;60 行纯标准库 Python 即可从它同时生成 Verilog 与 C 头文件(每个寄存器 ADDR + 按位宽算出的 MASK),本篇实测 5 个寄存器解析无误、双头文件生成、iverilog 编译消费模块零告警通过——地址漂移在机制上被消灭,而不再需要靠纪律维持。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:python3(/opt/eda-venv 虚拟环境,纯标准库无第三方依赖);iverilog -g2012(eda-golden-v1 镜像自带 Icarus Verilog)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部执行python gen_regs.py regs.md regs.vh regs.h,随后iverilog -g2012 -I work -o reg_user.vvp reg_user.v,最后校验产物非空与宏存在并打印RESULT: PASS)
代码获取
完整模板、生成器与消费模块已同步到公开仓库:geek-doc.cn/experiments/exp-reg-map-markdown-autogen,克隆后进入该目录执行 bash run.sh 即可复现本文全部结果;把 regs.md 换成自己项目的寄存器表即可直接套用。