FPGA 边缘 AI 系统:从模型到端到端低延迟推理管线的工程化
更新时间:2026-09-26。本文是 FPGA AI 推理 的系统篇:上一篇回答「单个网络怎么在 FPGA 上跑快」,这一篇回答「一套要量产、要运维、要签核端到端延迟的 FPGA 边缘 AI 系统怎么搭」。加速器原理可回看 FPGA 加速架构,确定性时序的硬件基础见 FPGA 低延迟设计。
本文要回答的问题
- 边缘场景里,FPGA 相比边缘 GPU 和 ASIC 到底赢在哪、输在哪,什么需求才该选它?
- 从传感器到执行器的端到端管线有哪些环节,为什么推理算力常常不是真正的瓶颈?
- INT8/INT4 量化掉多少精度,硬件为低比特推理付出/得到了什么?
- 脉动阵列、DSP 复用、片上存储和权重搬运如何共同决定实际性能?
- 算子覆盖不全、编译器映射不了的模型怎么办,量产后的模型更新怎么交付?
一、定位:确定性低延迟、能效与可重配
「边缘」不是把数据中心缩小。边缘设备的约束是:供电常被限制在 10–30W(无风扇工业盒更低至 5–15W),环境温度跨度 -40 到 +85℃,单路摄像头或传感器的 batch 恒为 1,且决策往往要在物理时间窗口内完成——产线分拣要求几毫秒内给出目标坐标,闭环运动控制的预算甚至在 1ms 以内。在这种约束下,「峰值算力」没有意义,有意义的是 batch=1 时的端到端延迟、延迟抖动和每瓦性能。
GPU 靠大量并行核心和批处理吃吞吐,边缘 GPU(功耗 15–60W 一档)跑视觉网络能效不错,但任务要经过驱动调度和缓存层次,单次推理延迟从几十微秒到数毫秒抖动,越负载抖动越大;ASIC(如各类 NPU 芯片)把算子固化成电路,能效最高、单位算力最便宜,但流片后算子集合和位宽就钉死了,一个新算子不支持,整颗芯片就要等下一代。FPGA 的位置在两者之间:电路按当次综合的比特流确定执行,流水线一旦灌满,每拍吐出固定的数据,延迟可以做到微秒级且抖动为时钟周期量级;功耗可按资源用量精细控制;现场重配能力让算子集合甚至网络结构可以在产品生命周期内改变。
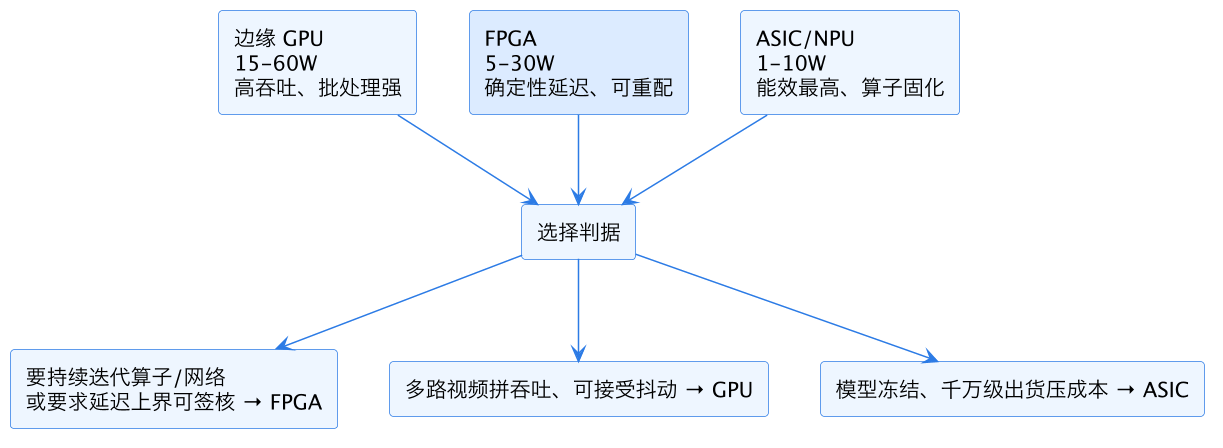
这张图的读法是:三类器件不是谁淘汰谁,而是对应三种风险偏好。FPGA 溢价买的是「两件事不被锁死」——延迟上界可写进合同,算子支持不被硅片锁死。代价也明确:单位算力成本高于 ASIC,开发门槛高于 GPU。
典型适配场景也因此清晰。第一类是高速闭环:产线定位、分选、贴装,视觉结果直接驱动运动轴,晚一毫秒就撞机或漏检;第二类是信号级 AI,例如雷达/声学异常检测,前端采样率在 MHz 量级,预处理是 FFT、滤波而不是图像缩放,GPU 的显存层次对这种流式样本毫无优势;第三类是长寿命装备,工程机械、医疗、轨交设备服役十年以上,期间模型必然迭代,整机返修换芯片不可接受,远程重配是刚需。反过来,十几路摄像头汇聚到一个盒子拼吞吐、只做告警不做硬实时控制的场景,边缘 GPU 的性价比通常更高。
| 维度 | 边缘 GPU | FPGA | ASIC/NPU |
|---|---|---|---|
| batch=1 典型延迟 | 数 ms,抖动大 | 数十 µs–数 ms,抖动仅时钟级 | 数百 µs–数 ms,较确定 |
| 功耗区间 | 15–60W | 5–30W | 1–10W |
| 峰值算力(INT8) | 20–275 TOPS | 1–10 TOPS(主流边缘器件) | 数–数十 TOPS |
| 算子/网络灵活性 | 高(软件可编程) | 高(可重配电路) | 低(流片冻结) |
| 单位算力成本 | 中 | 中高 | 大批量后最低 |
| 迭代方式 | 更新软件 | 更新比特流/模型 | 换芯片 |
二、端到端管线:瓶颈常在推理之外
一套真实的 FPGA 边缘 AI 系统是五级流水:传感器采集与解串、预处理、硬件推理、后处理与决策、通信/执行。以视觉为例,原始数据从 MIPI/LVDS 或 GMSL 链路进来,先做坏点校正、去马赛克、缩放裁剪、色域转换和归一化,再送入量化网络;推理输出的是张量,后处理要做 NMS(非极大值抑制)、坐标换算、跟踪滤波,最后驱动 IO、总线报文或上云。
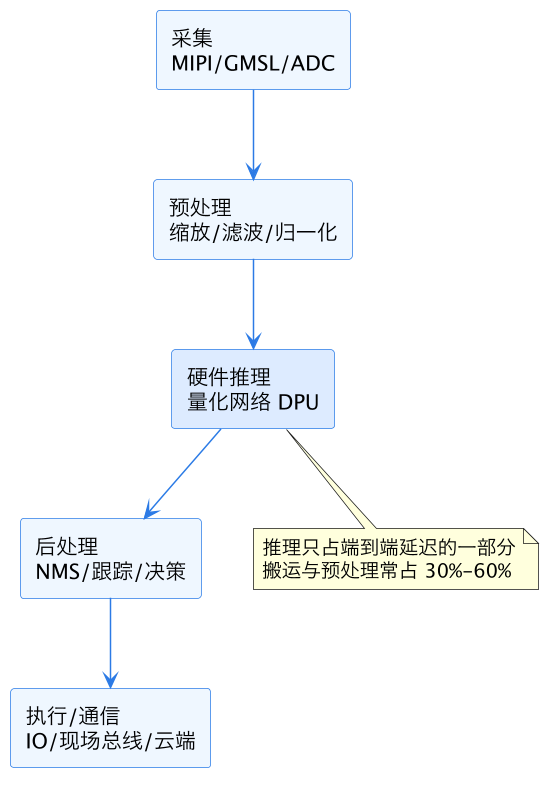
这张流水线图要说的核心是「数据不要落地」。如果预处理在 CPU 做,原始帧先从传感器进内存、CPU 读出处理、再经 PCIe/AXI 拷到 FPGA,一帧 1080P 亮度数据约 3MB、彩色约 6MB,一次额外往返就是毫秒级的 DDR 访问开销,足以把推理本身省下的时间全部吃光。工程上的正确姿势是把预处理也做成 FPGA 里的流式 IP,传感器数据经 AXI-Stream 一路流过缩放、色域转换,直接进入推理引擎,全程不经过外部内存;CPU 只在控制面出现。视觉流水线的硬件实现可参考 视频图像管线。
延迟预算要按级分配而不是只签核推理。一个常见做法是给每一级定预算,例如采集解串 ≤0.5ms、预处理 ≤1ms、推理 ≤3ms、后处理 ≤1ms、通信 ≤0.5ms,总预算 6ms,再各留 20% 裕量。固定流水线 + 静态调度意味着各级预算都是可证明的上界,这正是 FPGA 相对 GPU 能拿出的最有价值的交付物——签核的是最坏情况,不是平均情况。
三、量化:INT8/INT4 与精度的交易
FPGA 里没有免费的浮点。一个 FP32 乘加要占用多个 DSP 并引入长延迟,而 INT8 乘法在 DSP48/E5 里可以一个单元承担多笔(一个 DSP 通常可在单周期完成多组 8bit 乘法累加),算力密度直接差数倍。因此边缘推理几乎都走训练后量化(PTQ)或量化感知训练(QAT):把权重和激活从浮点映射到定点整数,推理全程整数运算。
| 位宽 | 相对 FP32 的精度变化 | 典型适用 | 硬件含义 |
|---|---|---|---|
| FP32 | 基准 | 仅 CPU 侧小模型/校验 | 算力密度最低 |
| INT8 | 视觉分类/检测通常损失 <1% | 主流默认 | DSP 复用,算力约为 FP 方案的数倍 |
| INT4 | 权重 INT4 常见掉点 1%–3%,激活也 4bit 时可能 3%–8% | 权重带宽受限、QAT 后部署 | 权重容量/带宽减半,需校准或蒸馏 |
可核实的量级:ResNet-50 这类网络 ImageNet 上 FP32 约 76%–77% top-1,成熟 PTQ 到 INT8 后掉点通常在 1 个百分点以内;INT4 权重 + INT8 激活的混合方案掉点约 1%–3%,而权重激活都压到 INT4 且只做简单 PTQ,部分检测/分割任务掉点可能超过 5%。所以「INT4 一定行」是错觉——敏感层(第一层、最后一层、归一化附近)业界普遍保留 INT8 甚至浮点,量化工具也默认对这些层豁免。
PTQ 的校准过程值得说一句,因为它是多数项目实际走的路线:用几百到上千张有代表性的现场样本跑一遍网络,统计每层激活的取值分布,据此确定缩放系数(scale)。校准集必须来自真实工况——实验室用白底产品图校准、产线上是深色背景,激活分布偏移就会让量化后的掉点显著放大。QAT 则在训练时就模拟量化误差,通常比 PTQ 再找回半个到一个百分点,代价是要动训练流程。项目里常见的组合是:先用 PTQ 快速验证可部署性,掉点不达标再对敏感层做 QAT,而不是一开始就全量化训练。
量化的第二个作用是压缩权重搬运量。ResNet-50 的 FP32 权重约 98MB,INT8 约 25MB,INT4 约 13MB;MobileNet 系列 INT8 权重只有 4–16MB。权重越小,越可能整片放进片上 SRAM 或在启动时快速加载,这直接决定下一节要谈的存储层级设计。量化与定点实现的硬件细节见 定点与 DSP 设计。
四、加速器架构:脉动阵列、DSP 复用与权重搬运
卷积和全连接层的本质是大量小矩阵乘加。直接的实现——每个乘法器各自从内存取数——会把能量和时间全花在访存上。脉动阵列(systolic array)的思路是让数据像心跳一样在处理单元网格里流动:权重预先载入阵列,激活从一侧流入,每个单元每拍做一次乘加并把部分和传给下一个单元,一条数据被多个单元复用,外存访问次数成倍下降。
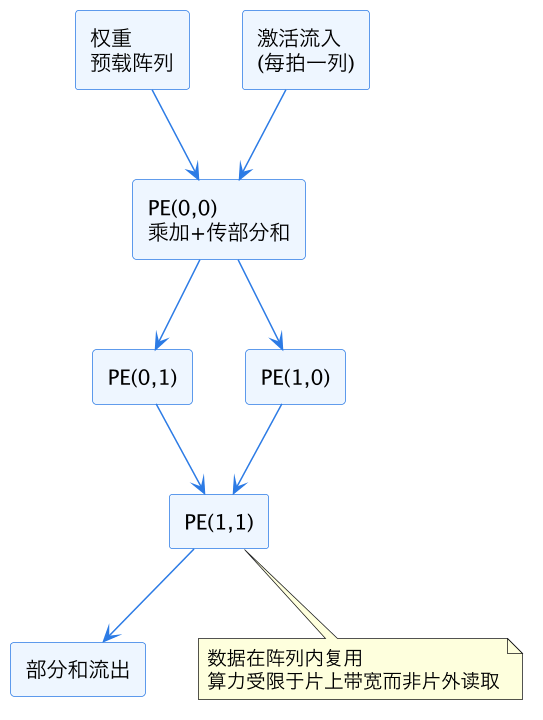
图中每个 PE 对应一个或一组 DSP。规模要照器件选型来:Zynq UltraScale+ ZU3 约 360 个 DSP,ZU9 约 2520 个,因此边缘端常见的 DPU 配置是几百到一两千 INT8 MAC 的阵列,标称 INT8 算力大致 0.5–8 TOPS(取决于频率和阵列规模),和数据中心 PCIe 加速卡的几十上百 TOPS 不是一个量级——边缘赢在确定性和功耗,不赢峰值。
第二个决定性设计是存储层级与权重搬运。FPGA 片上是分布式 RAM 和 BRAM/URAM,容量以 Mb 计(中大型器件片上 SRAM 合计几十 MB 量级),带宽是每拍 TB/s 量级且几乎不耗外存功耗;片外 LPDDR/DDR 容量 GB 级,但一次访问耗能是片上 SRAM 的数十到上百倍。业界经验是推理芯片的能耗大头在数据搬运而非运算,所以架构设计围绕「复用」展开:权重分块(tiling)载入后尽量多复用,激活在层间用片上缓存接力,卷积窗口内相邻像素复用行缓存(line buffer)。
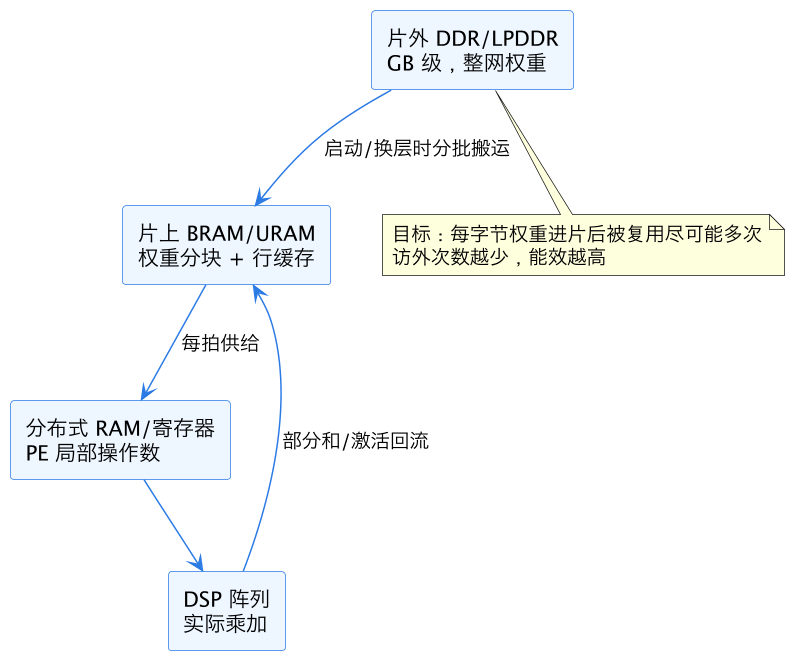
分块尺寸的选择可以用一个算例感受。假设片上可用缓存一次能放 256KB 的权重和激活,某层权重总量 4MB,则该层至少要切成 16 块依次载入;若分块与阵列规模对齐、每块载入后在阵列里完成整批输出通道的计算,每条权重只进片一次;若切分不当,同一权重为了配合不同的激活分块反复载入,外存流量可能翻几倍。工程上调编译器 tiling 参数的过程,本质上就是在「片上容量装得下」和「每块权重复用次数最大」两个约束之间找交点。
这张层级图配一个诊断判据:如果实测能效远低于理论值,先用硬件计数器量「每推理一次访问了多少片外字节数」,多数「算力上不去」的板子问题出在分块尺寸和阵列不匹配,权重反复进出 DDR,而不是 DSP 本身不够快。BRAM 与 DSP 的基础结构见 BRAM 存储设计 和 DSP 运算。
五、算子覆盖与编译器:Vitis AI 与 HLS 的分工
手写 RTL 实现整个网络不现实,主流路径是「编译器 + 可综合算子库」:以 AMD 自适应 SoC 的 Vitis AI 为代表,流程是先在 PyTorch/TensorFlow 训练,量化器做校准量化,AI Compiler 把网络切分、调度到 DPU(深度处理器单元,可配置的软核推理引擎),无法映射的算子(自定义后处理、新激活函数、形态学操作等)留在 CPU 执行或用 HLS 补一个算子 IP。
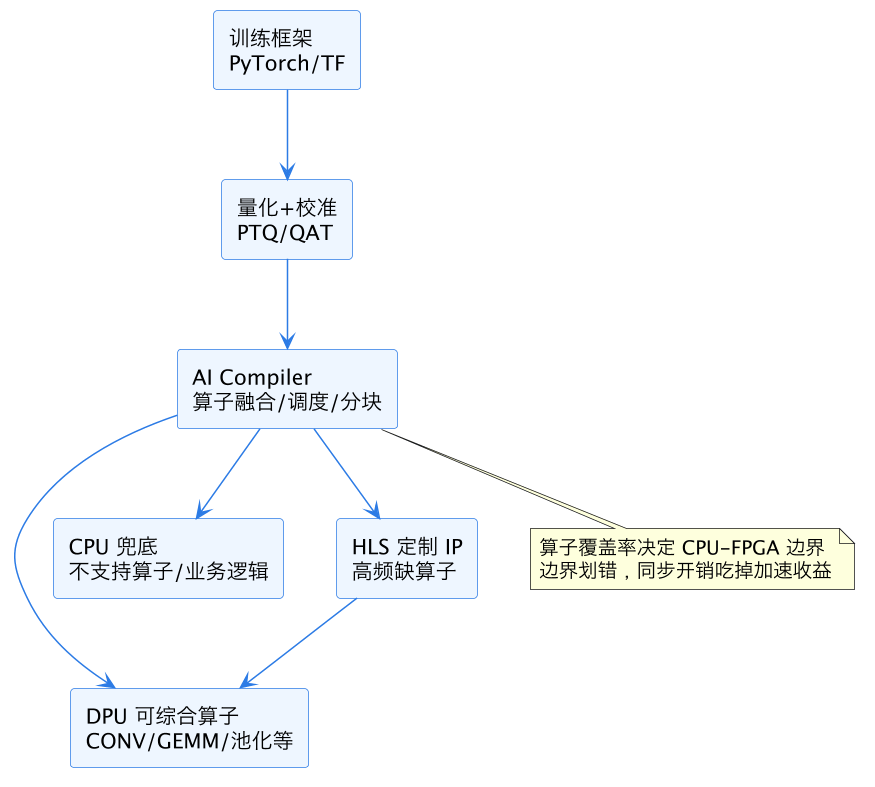
这里的关键工程概念是算子覆盖率。常见 CNN 主干(CONV、depthwise CONV、GEMM、ReLU、池化、concat)覆盖率接近 100%,整网可以几乎全在 DPU 上;但新型网络里的 deformable convn、部分 transformer 结构、自定义 NMS 往往落回 CPU。每一次 DPU→CPU 的边界都意味着数据出片、同步等待、再回片——边界太多,流水就断了。处理优先级是:先查工具链版本能否替代实现;其次用 HLS 把高频缺算子写成可综合 IP 挂回数据流(HLS 方法见 HLS 深入,HLS 与 RTL 的取舍见 HLS vs RTL);只有低频、不规则的算子留 CPU。算法与硬件的联合裁剪方法见 算法硬件协同设计。
六、部署、量产与模型更新
FPGA 边缘 AI 系统的交付物有两层:比特流(电路)和模型文件(数据)。量产工程把这两者分开管理。比特流跟随固件版本,经过 FPGA 量产 所述的烧录/启动流程,并依靠安全启动和比特流加密防篡改(见 FPGA 安全);模型文件存放在闪存独立分区,可以频繁更换而不动电路——前提是新模型只使用当前 DPU 配置支持的算子和位宽,否则必须连比特流一起发布。
更新链路典型为:云端训练与量化 → 回归集验证(精度 + 真机端到端延迟)→ 灰度推送 → 设备 A/B 双分区下载校验 → 重启切换,失败自动回滚。灰度要按设备分组而不是一次性全网,云端同时收三类遥测:精度代理指标(置信度分布、拒检率)、每级延迟实测值、结温与 DPU 占用率;任一项越过基线就暂停扩大灰度。这样一次「精度没掉、但延迟涨了 20%」的坏更新会在百分之几的设备上被拦住,而不是铺满整个车队。部分场景用部分重配置在不停机的情况下更换加速区域,机制见 部分可重配置深入。功耗与热签核(见 FPGA 功耗签核)在换模型时要复算:新网络如果把 DPU 占用率从 40% 拉到 90%,结温可能越过风扇设计裕量。CI/CD 流水线化的做法可参考 FPGA CI/CD。
七、常见坑
- 只报 TOPS 不报端到端延迟:数据手册算力是阵列满载理论值,batch=1、小算子密集时实际可能只用上一两成,必须真机实测传感器到决策的全链路延迟。
- 模型量化后不验敏感层:首层/末层一刀切 INT4,检测精度可能悄悄掉几个点;用标准回归集对比 FP32 基线签核。
- 算子边界划在高频通路上:每帧多次 DPU→CPU 同步,流水被打断;要么换网络结构,要么 HLS 补算子。
- 忽视分块与片上带宽:权重反复进出 DDR,能效和延迟双输;先量片外字节数再怀疑算力。
- 更新只测精度不测时序与热:新模型拉高 DPU 占用率,延迟预算和结温都可能越界。
- 把远程更新和安全启动留到项目末尾:这两件事牵涉分区、回滚、密钥体系,是架构设计而非收尾工作。
这一篇在知识体系里的位置
- 向上承接:FPGA AI 推理 解决单网络加速,FPGA 加速架构 讲通用加速原理,本篇把它们组装成可量产系统。
- 横向支撑:FPGA 低延迟设计 提供确定性时序基础,HLS 深入 与 算法硬件协同设计 覆盖算子实现与模型裁剪。
- 向下交付:FPGA 量产、FPGA 安全、FPGA 功耗签核 分别对应量产、安全、热与功耗的签核环节。
总结
FPGA 边缘 AI 系统的工程本质是用确定性流水线换掉峰值算力崇拜:采集到执行做成数据尽量不落地的流式管线,模型侧靠 INT8/INT4 量化换 DSP 算力密度与权重搬运量,硬件侧靠脉动阵列、DSP 复用和分块片上存储把每字节权重的复用做到最大,编译器与 HLS 按算子覆盖率划定 CPU–FPGA 边界,最终以端到端延迟上界、精度回归和可灰度回滚的模型更新作为量产签核标准——选 FPGA,选的是延迟与灵活性不被硅片锁死。