黑盒桩模型时序流程:大型 SoC 中 IP 黑盒化后用 stub 空壳模型跑顶层时序的接口预算、模型精度与签核边界
更新时间:2026-10-05。黑盒桩模型时序流程是大型 SoC 项目绕不开的一种「妥协式」顶层时序方法:几千万门的芯片不可能每次顶层 STA 都把全部 IP 的晶体管级或门级网表装进来——内存装不下、IP 还没交付、供应商只给 Liberty 不给网表,三条理由任何一条都足以逼你把 IP 黑盒化,换成一个只有端口和时序弧的 stub(空壳)模型,先让顶层时序跑起来。问题在于,stub 模型换来的是容量和进度,付出的是精度:边界路径的内部段被一段「预算值」替代,片上变化、串扰、时钟树效应要么被抽象掉、要么被悲观值覆盖。这一篇把这套流程讲透:stub 模型长什么样、接口时序预算怎么切分、跟 ILM/ETM 这类更精细的层次化模型差在哪、以及最关键的——用 stub 跑出来的顶层报告,哪些结论可以拿去签核、哪些必须等真网表回来重验。读之前建议先有 Signoff STA 与 PrimeTime 和 层次化流程 ILM 与 ETM 的基础,接口约束的细节见 接口时序与虚拟时钟。
本文要回答的问题
- 什么场景必须把 IP 黑盒化成 stub 模型,stub 和 ILM、ETM 的本质区别是什么?
- stub 模型的接口时序弧从哪来,input delay 与 output delay 预算怎么在顶层和 IP 之间切分?
- 用 stub 跑顶层 STA,精度损失集中在哪几个效应上,悲观度补偿怎么加?
- 时钟穿过黑盒 IP 的场景(PLL、时钟分频器在 IP 内部)怎么处理 generated clock?
- stub 流程的签核边界在哪:哪些违例可以信、哪些必须等全芯片扁平化或真模型重验?
一、为什么需要 stub:容量、进度与交付形态三重压力
先看三重压力各自长什么样。第一是容量:一颗旗舰级 SoC 扁平化后门级网表轻松超过 5 亿实例,STA 工具全装进来需要 TB 级内存,一次时序更新跑几天。工程上不可行,层次化是唯一出路。第二是进度:顶层集成启动时,常常有一半 IP 还在综合甚至还在 RTL 阶段,根本没有网表可装;但顶层的顶层——pad ring、时钟复位分配、IP 间互连总线——的时序又必须尽早暴露问题,等所有 IP 就绪再跑第一次顶层 STA,项目已经输了。第三是交付形态:外购硬 IP(SerDes、DDR PHY、GPU 核)供应商出于保密只给 .lib 时序库和抽象视图,压根没有门级网表给你装。
三种压力对应三类模型,精度从低到高排:stub 模型(只有端口和接口时序弧,内部完全空)、ETM(Extracted Timing Model,从门级网表提取的接口时序模型,端口上挂着等效时序弧,内部逻辑被压缩)、ILM(Interface Logic Model,保留接口到第一级寄存器的真实逻辑,内部删减但保留的结构是真实的)。stub 是其中最快也最粗的一档:它甚至不要求 IP 有网表,只要一份接口时序预算文档就能手工写出来。
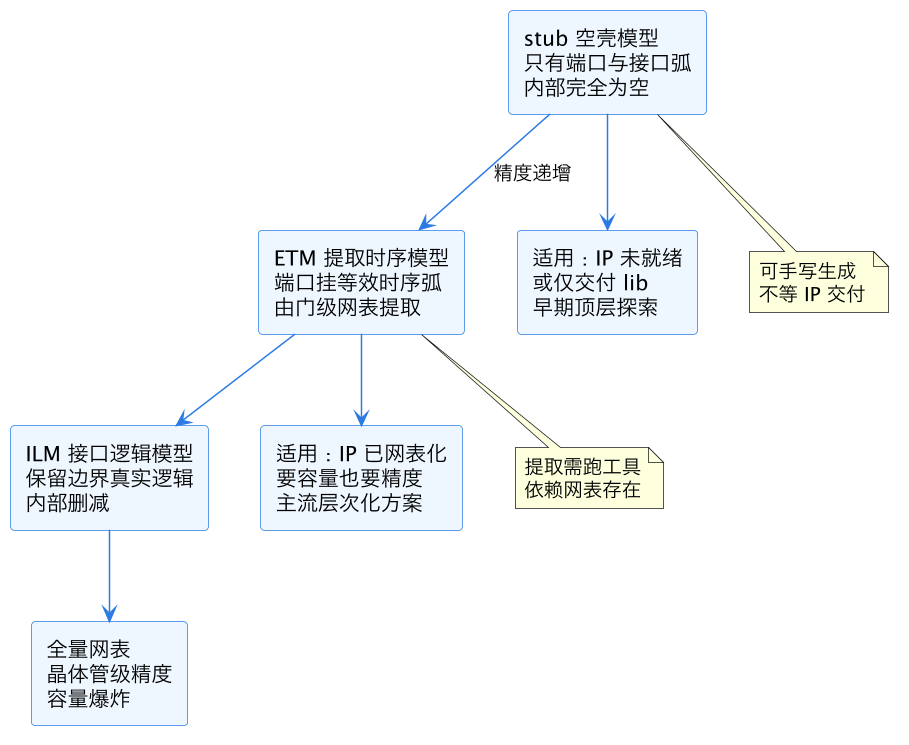
这张图的纵轴是精度、横轴是就绪度要求:stub 站在「什么都不需要」的极端,这也是它在项目早期不可替代的原因。但要时刻记住它是个占位符——stub 跑出的结论都带一个隐形的星号。
二、stub 模型怎么造:从接口预算文档到时序弧
一个 stub 模型本质上由三部分组成:端口列表(方向和位宽,与真实 IP 完全一致,否则顶层网表连不上)、时钟定义(哪些端口是时钟输入、内部有没有 generated clock 需要声明)、接口时序弧(输入端口的 external delay 假设和输出端口的驱动特性)。在 Liberty 格式下,一个输出端口的 stub 弧长这样:一个 timing() 组,related_pin 指向时钟端口,cell_rise/cell_fall 给一组固定延迟值,外加一个 drive 或等效驱动电阻描述输出能力;输入端口则带上 max capacitance 之类的负载约束。
这些数值的来源是接口时序预算(interface timing budget)。预算的核心思想是把一条跨 IP 路径的总周期切成三段:源 IP 内部段(时钟到输出端口)、顶层互连段(走线加中继器)、目的 IP 内部段(输入端口到寄存器)。在 stub 流程里,源 IP 内部段体现为目的 IP 看到的 set_input_delay,目的 IP 内部段体现为源 IP 看到的 set_output_delay,顶层互连段是 stub 流程里唯一被真实分析的部分。切分的常见惯例是「三七开」或「四六开」:比如 1ns 周期的接口,给每个 IP 内部各留 300ps、顶层互连留 400ps。具体比例由架构和 IP 成熟度定,细节见 自顶向下模块时序预算 和 IO 时序预算约束。
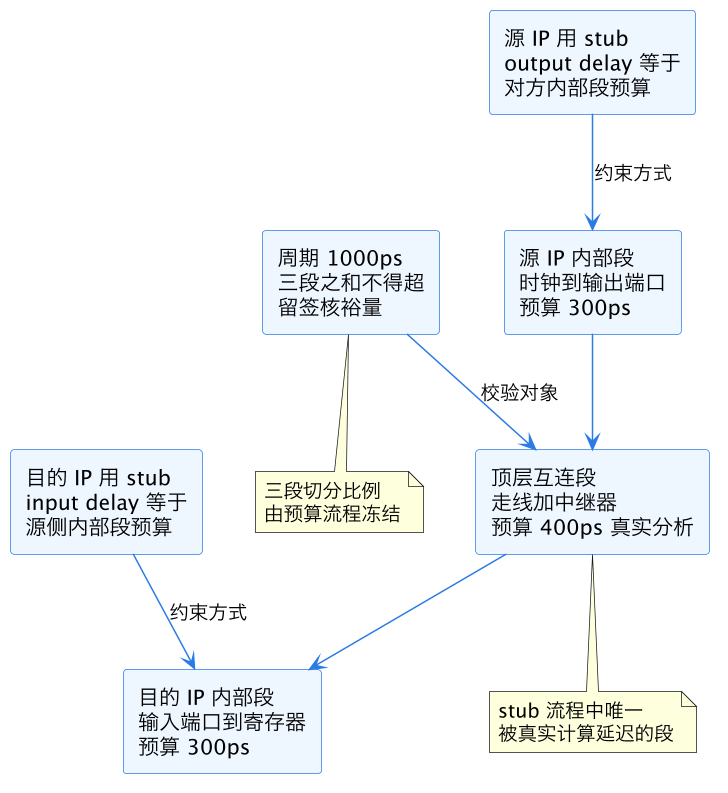
这张图是 stub 流程的账本结构:三段预算里只有中间一段有真实数字,两头都是「承诺值」。这决定了后面要讲的精度问题——stub 流程签的其实是中间段,两头签的是「预算有没有被遵守」。
三、精度损失在哪:被抽象掉的四个效应
用 stub 跑顶层 STA,结果和真网表之间的差距集中在四个效应上,逐个说清楚才知道该补多少悲观度。
第一是片上变化(On-Chip Variation,OCV)。真实 IP 内部的时钟到输出延迟有一个 derate 后的分布区间,stub 弧里只有一个固定数。如果预算值取的是 nominal 而不是带 derate 的 worst,顶层 setup 检查就乐观了。标准做法是预算值直接用 IP 团队签核口径下的 worst-case 接口延迟(含 POCV/AOCV derate,见 STA derate 与 POCV 建模),宁悲观勿乐观。
第二是串扰(SI)。顶层互连线与邻线的耦合电容会在真实分析里产生 delta delay,而 IP 内部段的「预算 300ps」是个死数,不含对方窗口重叠导致的串扰增量。缓解办法是在预算里给每个 IP 内部段额外加一份 SI 余量(经验值是段预算的 10%-15%),顶层段本身因为是真实分析的,由工具的 SI 引擎正常处理,见 STA 串扰与增量延迟。
第三是时钟树效应。IP 的时钟端口在 stub 里是理想点:顶层算出的时钟延迟到端口为止,IP 内部从端口到寄存器的 clock insertion delay 被折进预算。问题是 setup 检查吃的是发射与捕获时钟的延迟差,CRPR(Clock Reconvergence Pessimism Reduction)在真实分析里能抵掉公共段的悲观度,stub 流程里公共段被人为切在端口上,抵不掉,天然偏悲观——这一般是好事,但要在预算评审时知道这笔钱花在哪。
第四是输入转换时间(transition)。顶层驱动到 stub 输入端口的 transition 是真实算的,但 stub 输出端口的 transition 是模型里写的固定值,它决定下游顶层逻辑的第一级单元延迟。写小了,下游整条链乐观。保守做法是让 stub 输出 transition 取 IP 签核报告里的实测 worst 值,而不是 lib 里的默认值。
| 效应 | stub 中的表现 | 补偿手段 | 方向 |
|---|---|---|---|
| OCV/POCV | 接口弧只有固定值 | 预算取 derate 后 worst | 不加会乐观 |
| 串扰 SI | 内部段预算不含串扰增量 | 段预算加 10%-15% 余量 | 不加会乐观 |
| 时钟树/CRPR | 公共段在端口被切断 | 接受偏悲观,评审知悉 | 偏悲观 |
| 输出 transition | 模型固定值 | 取 IP 签核实测 worst | 写小会乐观 |
四、时钟穿过黑盒:generated clock 的两种处理
麻烦的不止数据路径。很多 IP 内部有时钟逻辑——PLL、分频器、时钟门控——时钟从 IP 的一个端口进去、另一个端口出来再分配给其他模块。IP 黑盒化之后,这条时钟路径在顶层网表里是断的,STA 看不到分频关系。
处理有两条路。第一条:在 stub 模型里显式声明时钟传播弧。Liberty 里给时钟输出端口挂一条相对时钟输入端口的 timing() 弧(标注为时钟弧),STA 就能把时钟波形「穿」过去;如果内部分频比固定,还可以在顶层约束里对 stub 输出端口直接定义 generated clock,master 指向输入端口、divide_by 给分频比——这条命令挂在 stub 端口对象上完全合法,工具不需要看到内部寄存器。第二条更彻底:如果 IP 内部时钟逻辑复杂(可编程分频、多模式),干脆不让时钟穿 stub,而是在 IP 边界把时钟「切开」——输出端口定义为独立时钟源,用 SDC 时钟组约束 声明它与源时钟的关系(同步就写清周期比例,异步就交给 CDC)。第二种方法把 IP 内部时钟的签核责任完整推给 IP 团队,顶层只认边界上一份时钟接口规格书。
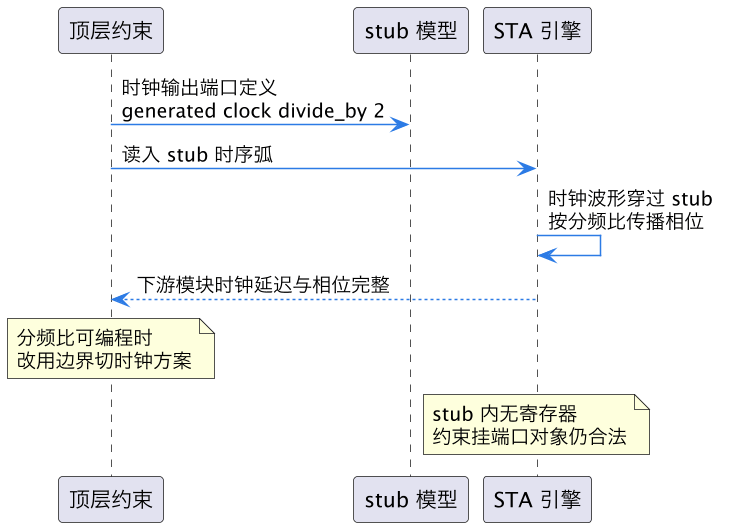
要点是:时钟穿 stub 的处理必须在约束评审里单独立项,因为它是 stub 流程里少有的「写错不报警」的坑——分频比写错,下游所有时序静默地错,没有任何违例提示你。
五、签核边界:stub 报告里什么能信、什么不能信
这是全套流程最需要纪律的部分。可以用一张表先给结论,再展开。
| 顶层报告内容 | 可信度 | 原因 |
|---|---|---|
| 顶层互连段 setup/hold 违例 | 可签核 | 唯一被真实分析的段 |
| IP 间路径的总周期可行性 | 有条件可信 | 依赖预算值被 IP 团队确认 |
| IP 内部路径 | 完全不可见 | stub 里没有这些路径 |
| 时钟穿 IP 的相位关系 | 看约束评审记录 | 分频比错则静默错 |
| 全芯片 hold 收敛结论 | 不可签核 | hold 对悲观度敏感,须真模型重验 |
能签核的只有顶层互连段本身:走线延迟、中继器插入、顶层逻辑的 setup 与 hold,这些是真实计算出来的,报告可以直接进签核包。IP 间路径的总结论则是「有条件」的——条件就是预算值是否被双方冻结确认。工程上的做法是把接口预算做成一份双方签字的规格文件,IP 团队的内部签核报告必须证明「时钟到输出端口 ≤ 预算值」,顶层的 stub 分析证明「互连段 ≤ 预算值」,两份报告拼起来才是完整的路径签核。任何一边超了,拼缝就开了。
不能信的同样要明确。IP 内部路径在 stub 流程里根本不存在,顶层报告里不会有它们的任何痕迹——这听起来是废话,但项目后期常见的事故恰恰是有人拿着「顶层 STA 干净」的报告去回答「IP 内部那条 critical path 怎么样了」。hold 检查整体更敏感:hold 吃的是最短延迟差,stub 预算通常按 setup 口径(worst-case)给值,直接用于 hold 检查会漏掉「IP 内部最快能多快」这个维度,所以全芯片 hold 收敛必须在 IP 真模型(至少 ETM)回来之后重跑一轮,见 STA hold 修复与 buffer 插入。GBA/PBA 的差异在这里也会被放大:stub 弧是图驱动的固定值,PBA 的路径级重算改善不了预算段的精度,见 STA GBA 与 PBA 分析模式。
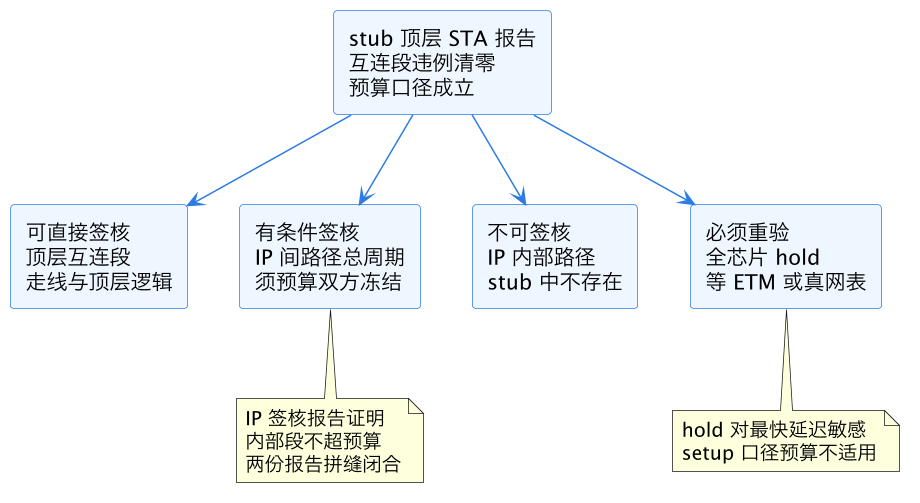
项目节奏上,stub 流程的位置也很清楚:它是「早期占位 + 持续回归」的角色。IP 陆续交付后,stub 应该逐个被 ETM/ILM 替换,顶层 STA 的精度随替换单调提升;到 tapeout 前的最终签核,关键 IP 必须是真模型,stub 最多残留在「确认无交互」的角落模块上。替换过程本身也要回归——每次换一个模型,接口路径的违例数会跳变(通常变多,因为预算的悲观度被真实数字取代),这是预期现象,不是流程坏了。
这一篇在知识体系里的位置
本篇属于 EDA 签核方法学中的层次化时序分支,上接 层次化流程 ILM 与 ETM(stub 是那篇文章里模型谱系最粗的一端),横接 自顶向下模块时序预算 与 IO 时序预算约束(预算值的产生与落法),下接 层次化 STA 与模块接口 和 Signoff STA 与 PrimeTime(真模型回来后的最终签核)。约束侧的配套是 SDC 时钟组约束 与 SDC 约束验证 lint,精度补偿的理论背景在 STA derate 与 POCV 建模。
总结
黑盒桩模型时序流程的本质是「用一份双方冻结的接口预算,换掉 IP 内部的真实分析,让顶层互连段在 IP 就绪前先跑起来」:stub 模型只有端口、时序弧和时钟穿透声明,三段式预算(源内部、顶层互连、目的内部)中只有顶层互连段被真实计算,OCV、串扰、时钟树、transition 四类精度损失靠预算悲观度补偿,时钟穿黑盒靠 stub 端口上的 generated clock 或边界切时钟;这套报告里能签核的只有顶层互连段,IP 间路径结论以预算被双方确认为前提,IP 内部路径与全芯片 hold 则必须等 ETM 或真网表回归后重验——stub 是进度的脚手架,不是签核的终点。