FPGA 专家 04:PCIe 深水区——TLP、LTSSM、配置空间
本文是
fpga/专家层第 07 篇。工程使用(XDMA IP、基本 DMA)见进阶 PCIe 入门使用;DMA 架构深入见下一篇 PCIe DMA 架构,物理层见收发器深水区。
一、协议分层
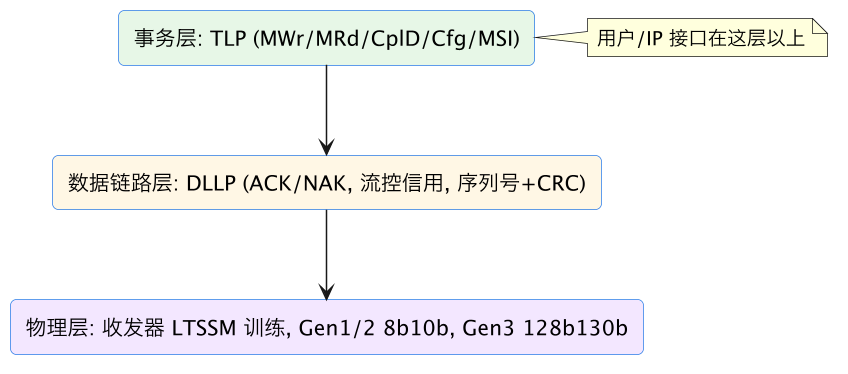
| 层 | 职责 | 关键机制 |
|---|---|---|
| 事务层 | 总线事务打包 | TLP:MWr(posted 写)/MRd(读请求)/CplD(读完成)/Cfg(配置)/MSI |
| 数据链路层 | 可靠传递 | 序列号、CRC、ACK/NAK 重传、流控信用 |
| 物理层 | 串行传输 | LTSSM、lane 宽度协商、8b/10b(Gen1/2)、128b/130b 加扰(Gen3+) |
二、链路训练 LTSSM
Detect(检测对端) → Polling(比特/符号对齐)
 → Configuration(宽度/lane 映射/极性)
 → L0(正常工作) ⇄ Recovery(重均衡/速率切换)
卡在 Detect→物理连接/PERST#
卡在 Polling→REFCLK 抖动/速率/SI
卡在 Configuration→宽度/lane 配置
参考钟 100MHz 差分、抖动规范严格;PERST# 复位时序;lspci 看 LnkSta 协商速率/宽度。
三、事务与数据通路
| TLP | 类型 | 特点 |
|---|---|---|
| MWr(存储器写) | Posted | 不等应答、持续灌包,效率高 |
| MRd(存储器读) | Non-posted | 发请求→等 CplD,往返延迟,需多 outstanding |
| CplD(完成包) | — | 读数据返回载体 |
| Cfg/Msg | 配置/消息 | 枚举、MSI-X 中断 |
- BAR:设备声明地址窗口→主机枚举分配基址→CPU 访问该窗口生成 TLP→FPGA 侧转 AXI-Lite;
- MPS/MRRS:最大负载/读请求长度,协商越大效率越高(受主机限制);
- MSI-X:向特定地址写数据触发中断,多向量支持多队列并行;
- 性能:读方向多 outstanding、描述符批量提交(SG)、MWr 流水。
四、FPGA 侧形态
Xilinx IP(XDMA/QDMA/AXI Bridge)封装协议栈,用户看到:
- BAR 空间 → AXI4-Lite(寄存器/控制);
- DMA 通道 → AXI4 内存映射 + AXI-Stream(数据流);
- 中断源 → MSI-X;
- 调试寄存器 → LTSSM 状态、链路速率宽度、错误计数。
五、LTSSM 深论:链路训练每个状态在解决什么
LTSSM 不是考试要背的状态名,而是一张故障定位地图,每个状态对应一类明确的物理/协议问题。Detect:发射端在 TX 上检测接收器端接(检测到约 50Ω 等效阻抗即认为存在对端),卡在 Detect 意味着物理层没有对端——金手指没插到位、信号完整性问题导致接收端检测失败、PERST# 仍有效、参考钟未就绪,或者 AC 耦合电容漏贴。Polling:两端发送训练序列(TS1/TS2),完成比特/符号锁定、块对齐(Gen3+)、极性协商,并确认对端存在;卡在 Polling 查 REFCLK(PCIe 强制 100MHz 差分,抖动规格远严于普通逻辑钟,常见允许 SSC 展频共 0~-500ppm)、速率/编码一致性、Gen2 以上的信号眼和均衡、极性反接(训练阶段通常能自动翻转,但极端配置要确认)。Configuration:用训练序列交换 lane 编号,协商链路宽度(x1/x4/x8/x16)、完成 lane 到通道的映射和反转(lane reversal)、设定 lane 极性;卡在 Configuration 通常是宽度配置与物理连接不符、部分 lane 焊接/电容问题、lane 顺序超出 IP 允许的反转范围。
进入 L0 后链路正常传输;Recovery 不是故障而是工作状态的一部分:退出低功耗、速率切换(如从 Gen1 协商到目标代际)、重新均衡、或信号劣化时重训,都经 Recovery 返回 L0。正常上电会经历一次 Recovery 完成速率拉升,属预期;反复进出 Recovery(链路抖动/flapping)则说明信号裕量不足或参考钟问题,要查眼图、均衡参数、电源噪声。低功耗状态 L0s/L1/L2 是 ASPM 省电机制,FPGA 卡通常在 BIOS/驱动中禁用 L0s(退出延迟和兼容性问题),是否用 L1 substates 按低功耗需求评估。Gen3 以后训练增加了 equalization 阶段(Phase 0–3,收发器按预设系数和请求做 TX 预加重/接收均衡协商),这是 Gen3 链路 bring-up 最常卡住的地方:preset/系数不匹配、preset request 超时都会失败,调试要读 EQ 状态和收发器眼图,方法与 专家 04 的均衡调优一致。把“卡在哪一状态→查哪一层”固化成团队 checklist,PCIe bring-up 就能从玄学变成流程。
六、TLP 语义深论:Posted/Non-Posted、排序规则与流控信用
事务层的性能和正确性都建立在 Posted 与 Non-Posted 的区分上。Posted 写(MWr、消息/MSI):发送方发出即认为完成,不等待任何应答,数据链路层保证可靠(失败重传)但事务层不返回完成;它延迟低、可连续灌满链路,是高吞吐方向的首选(数据采集 FPGA→主机就是 posted 写)。Non-Posted(MRd、配置读写、I/O):请求方发出后必须等待完成包(Cpl/CplD),是分体事务,一来一回要付完整往返延迟(Root Complex、交换芯片、内存控制器各有延迟,常见几百纳秒到微秒);一次只挂一个读请求时链路利用率极低。完成包本身带状态(成功、UR 不支持请求、CRS 配置重试、CA 配置中止)和长度/字节使能,调试时主机日志里的 UR 往往意味着 BAR/地址路由问题而不是链路问题。还有一类易忽略的细节:读完成允许拆分(一个 MRd 的数据由多个 CplD 返回)且可能与其他事务交错,接收方必须按 TLP 头里的 requester ID、tag、lower address 重组,这正是 DMA 引擎要维护 outstanding 表(tag→缓冲上下文)的原因。
**排序规则(ordering)**决定并发事务能否乱序完成,理解它才能正确设计多 outstanding 与桥接。PCIe 默认“强排序”模型下,相同流量类别的 posted 写按序通过交换结构,non-posted 请求的完成按各自 tag 匹配而不保证全局顺序;ID-O(ID-based ordering,可选)允许不同 requester ID 的事务互相越过,relaxed ordering bit(RO)允许写越过先前的写,二者用于提升性能但要求软件/硬件能接受弱顺序(DMA 描述符环的“先写数据再写拥有者标志”必须用正确的屏障,不能简单置位 RO)。流控是链路层的信用机制:接收方按 TLP 类型(P 头、NP 头、CplD 数据等)通告信用,发送方发一个包扣对应信用、对端释放后经 DLLP 回补;信用耗尽时该类事务被阻塞。典型死锁/性能陷阱是:某方向只发 NP 请求不收 CplD,完成信用耗尽后整条链路停顿;或 AXI 侧反压导致完成包无人接收。设计 FPGA 端点时要保证所有信用类都有接收服务(即使是“不请自来”的 CplD 也要有排空路径),DMA 引擎的 NP outstanding 深度要和信用、tag 数量、MRRS 一起匹配。这套信用语义和 专家 05 讲的端到端信用流控思想同源,只是 PCIe 已在硬件里实现。
七、配置空间、枚举与 BAR:设备如何被操作系统看见
主机“发现”FPGA 的全过程发生在枚举阶段,理解它能解释一大批“链路 up 但系统看不到设备/驱动不工作”的问题。设备上电后,配置空间以默认值就绪:厂商 ID/设备 ID/类代码/版本、命令状态寄存器、能力链表(MSI/MSI-X、Power Management、PCIe capability、扩展能力)和 BAR。BAR 的硬件语义是“可写掩码”:软件先向 BAR 写全 1 再读回,硬件让可分配位返回 0、固定位返回 1,据此得知该 BAR 需要多大窗口(必须 2 的幂且最小对齐一页);随后 BIOS/OS 在内存地址空间中选一段未占用区间,把基地址写回 BAR。此后 CPU 对该地址范围的访问被 Root Complex 翻译成 MWr/MRd TLP,按地址路由到 FPGA,IP 再转成 AXI-Lite 访问用户寄存器。设计要点:BAR 大小按实际寄存器空间向上取 2 的幂(留扩展余量但别浪费地址空间);64 位可预取 BAR 用于大窗口(如卡上显存映射),32 位 BAR 用于小寄存器窗口;不要把大数据通路设计成 PIO(CPU 经 BAR 逐字访问),BAR 只做控制面。
枚举与链路状态的诊断手段要熟练:主机侧 lspci -vvv 能看到协商速率宽度(LnkSta/LnkCap)、MPS/MRRS、BAR 分配、ASPM、重传和错误计数(DevStat);设备完全不出现先查 LTSSM/PERST/REFCLK,出现但带黄色感叹号查 VID/DID/驱动绑定;BAR 全 0 或大小异常查 BAR 配置与响应逻辑(FPGA 必须正确响应配置读写,软核 IP 自己实现配置空间时尤其容易漏能力指针)。MPS/MRRS 是两个协商参数:MPS 是双方约定的最大 TLP 载荷(128B~4KB,整条链取最小值),MRRS 是读请求方一次最多请求的字节数;热复位、FLR(功能级复位)、热插拔都有规定的状态机行为,FPGA 侧要正确响应 FLR(清空 DMA、停止发 TLP、完成在途事务),否则虚拟化直通和驱动重载会残留状态。MSI-X 的能力结构包含中断向量表和 PBA(pending 位阵列)所在的 BAR,向量地址/数据由软件填写,设备发中断本质是一次 MWr——这也意味着中断能否送达取决于 DMA 写路径正常,是“数据通路坏了中断也消失”的原因。
八、性能模型:从代际带宽到真实吞吐的逐项扣减
PCIe 性能规划最忌直接引用“Gen3 x8 = 8GB/s”这类单向理论值。正确做法是逐档扣减。物理编码开销:Gen1/2 的 8b/10b 打八折(Gen2 x8 理论有效约 4GB/s 单向),Gen3/4 用 128b/130b 编码效率约 98.5%,Gen3 x8 单向约 7.88GB/s,Gen4 x16 双向合计超过 60GB/s。协议开销:TLP 头(3 或 4 DW)、序列号与 CRC、DLLP、流控更新、ACK、帧间隔都占带宽,载荷越小开销占比越高,所以 MPS 越大效率越高——但 MPS 由整条链路最弱设备决定,x86 平台常见 256B,嵌入式 Root Complex 可能只有 128B。事务语义开销:读方向的分体往返、完成包头和拆分、NP 信用限制;写方向 posted 高效但要持续供数。流控与信用气泡:信用回补延迟、ACK 延迟、重传(信号差时 CRC 错导致整包重发)。主机侧:Root Complex 上行带宽、内存读写带宽、IOMMU/SMMU 地址翻译(缺页/OTLB miss 极贵)、NUMA 跨 socket、驱动与中断处理。
工程优化按“先排硬伤、再压气泡”的顺序:lspci 确认协商速率宽度(Gen1 x1 误配与 Gen3 x8 差 24 倍带宽,是最常见隐形事故);MPS 尽量大、MRRS 设 512B 左右并确认平台允许;写方向持续 posted + 大 TLP;读方向 outstanding 拉满(几十个 tag)、批量 SG、把多次小读合并成大块读;双向同时有流量时 H2C/C2H 各用独立资源避免互相饿死;中断用 MSI-X 多向量 + 中断合并(NAPI 式批处理),避免每包一中断;缓冲区用 hugepage 减少 IOMMU/TLB 压力并就近 NUMA 节点分配。评估时必须用实际载荷大小画吞吐曲线:4KB 以下小包场景软件/描述符开销主导,曲线在小包区陡降是正常物理现象,应在数据面做聚合而不是怀疑链路。建议在 FPGA 里内置性能计数器(TLP 计数、字节计数、信用等待周期、重传计数、outstanding 占用峰值),把“链路窄、协议气泡、主机慢、用户逻辑反压”四类瓶颈用数据区分开(方法见 专家 08)。
九、代际差异与新特性:Gen3 均衡、Gen4/5 与 CXL 视野
选型和设计时要对代际差异有数。Gen1(2.5GT/s)、Gen2(5GT/s)用 8b/10b,链路训练相对简单;Gen3(8GT/s)起改为 128b/130b 加扰,并在 LTSSM 中引入完整的 link equalization:发送端 preset、系数回读、相位 2/3 的请求—应答,若板级信道裕量不足会卡在 Recovery.equalization 或反复重训;FPGA 侧应保留对 TX preset/RX preset 的配置能力并以眼图/BER 验证(裕量方法见 专家 04)。Gen4(16GT/s)对板材、过孔背钻、连接器和参考钟相噪要求显著提高,MPS 协商保持兼容但误码重传对裕量更敏感;Gen5(32GT/s)几乎强制要求高等级板材和 retimer(纯 redriver 难以覆盖全链路预算),PAM4 则在 Gen6(64GT/s)登场并引入 FEC——与独立收发器的代际规律完全一致(见 专家 04 第十三节)。做底板/线缆 PCIe 时还要区分 CEM(卡规范)、M.2、U.2、IPASS/OCuLink 等机械与信道规范,长度和预算不能混用。
CXL(Compute Express Link)是建立在 PCIe 物理层(Gen5 起)之上的缓存一致互联,包含 CXL.io(等价 PCIe)、CXL.cache(设备访问主机内存并参与一致性)、CXL.mem(主机访问设备内存)三协议;它不改变物理设计但改变了系统假设——设备进入硬件一致性域,FPGA 加速器可极低延迟共享主机内存而不必自行搬运。今天多数 FPGA 团队仍以标准 PCIe DMA 为主,但评估下一代加速架构时应理解:CXL 解决的是 DMA 模型中“所有权切换、缓存同步、精细粒度共享”的痛点,代价是更复杂的一致性协议和软件栈;其物理层设计纪律与 Gen5 PCIe 完全一致。另一个现实变量是Retimer/Redriver:信道超长时 redriver 是模拟放大(不恢复、延迟小但延续抖动),retimer 是重建比特(带 CDR/重传边界,能恢复信号但有延迟),选型要按总插损和协议允许的预算,不能随意串接(两级 redriver 可能把噪声一起放大)。把代际、信道和互联演进放在一张图里看,才能避免“按 Gen2 经验布 Gen4 板”的代差事故。
十、FPGA 端设计与调试清单:从 IP 配置到互通
把 PCIe 当作“必须与一个复杂对端协商”的接口来设计,落地清单如下。IP 配置:器件支持的硬核/软核、代际与宽度、端点模式(不是 Root Port)、参考钟频率与是否 SSC、PF/VF 数量、BAR 个数/位宽/可预取/大小、MSI-X 表大小、用户时钟频率、复位类型;这些与原理图(参考钟来源、PERST#、时钟缓冲、wake 引脚)逐项对应。复位时序:等待参考钟稳定→IP 复位→用户逻辑在 user_clk/reset 释放后才可发起业务;PERST# 与热复位要能重置 DMA 引擎、丢弃在途包、清信用假设;FLR 行为按规范实现。AXI 侧:BAR 转 AXI-Lite 的地址译码、读写响应必须永远返回(不能挂起,否则主机死机);DMA 侧 outstanding 表、tag 管理、完成重组、奇偶/长度检查;所有跨域(user_clk 与业务时钟)经异步 FIFO/握手。电源与信号:Gen3+ 的独立 MGT 电源、参考钟 LDO、AC 耦合(CEM 板侧或金手指侧位置按规范)、金手指阻抗与 lane 长度等长、Retimer 预留(高速代际建议预留焊位)。
bring-up 顺序:先确认主机看到设备且 LTSSM 到 L0、协商速率宽度正确(lspci);再读写 BAR 寄存器(小数据 PIO);再跑单向 DMA(先 H2C 后 C2H)、SG 环、中断;再双向并发和压力;再做 FLR/复位/热插拔/长时间(24 小时 PRBS 式数据校验)。必备可观测点:ltssm_state、当前速率宽度、各类错误计数(bad TLP、bad DLLP、CRC、replay timer 超时、NAK 数)、流控信用、用户 AXI 响应状态、DMA tag 占用、性能计数器;主机侧配合 lspci -vvv、setpci 调 MPS/MRRS、内核 PCIe 错误日志(AER)、性能分析工具。互通矩阵:至少在两代以上芯片组/CPU 平台、有无 SSC、不同 BIOS(ASPM、Above 4G、10-Bit Tag Requester)下测试,PCIe 的很多“兼容性问题”本质是只在自家实验室一台主机上验证过。最终交付件应包含:配置参数表、信道仿真与实测眼图、LTSSM 抓波记录、互通报告和驱动版本组合——这套证据链让“偶发枚举失败”类问题在量产后可以追溯(量产纪律见 专题 04)。
十一、枚举与启动失败案例库:从“设备不见了”到“BAR 错乱”
把工程现场反复出现的枚举问题整理成案例库,比记住协议条文更有用。案例一,设备完全不出现:多数是 PERST# 时序(金手指供电稳定后 PERST# 释放太早)、100MHz 参考钟缺失或抖动超标、或金手指/wake 等辅助引脚问题;先看 FPGA 是否配置完成(从闪存加载慢于主机枚举窗口时,主机扫描不到设备,需要 CCLK 加速或预上电配置)。案例二,出现但反复链接降级/重训:Gen3 equalization 失败后退到 Gen2,lspci 显示 LnkSta 低于 LnkCap;查 TX/RX preset、信道插损和参考钟 SSC 配置(两端对 SSC 的容忍要一致)。案例三,BAR 大小异常或枚举报资源不足:BAR 配置不是 2 的幂、64 位 BAR 漏配高位、或大 BAR 超过 BIOS 的 32 位窗口;Above 4G Decoding 未开时大容量 BAR 无法分配。案例四,能枚举但访问 BAR 挂死:AXI-Lite 从口在某些地址不返回响应或响应未跨到 user_clk 域,主机表现为整机卡死;所有解码空洞也必须返回 DECERR 而不是沉默。
案例五,DMA 一开就 IOMMU/主机报错:DMA 地址用了未映射的虚拟地址、描述符环位于可移动页、或 40 位地址截断(专家 08 第六节)。案例六,MSI-X 中断丢失:向量表/PBA 所在 BAR 没实现或落在不可预取窗口、中断消息写被挂起的数据面阻塞;记住 MSI-X 本质是 posted MWr,数据通路坏时中断自然消失。案例七,重启/FLR 后行为异常:用户逻辑未随 FLR 复位,旧 DMA 继续写主机;必须严格实现 FLR 完成窗口内的静默。案例八,只在某些主板/服务器上失败:BIOS 的 ASPM、Snoop 位设置差异、MPS 被平台锁在 128B、PCIe switch 的信用模型不同——这类问题只能靠互通矩阵提前发现。每个案例的共同教训是:枚举是一次有时限的多方协商,FPGA 不仅要“正确”,还要在主机规定的时序窗口内“准备好并可证明”。
十二、电源管理、热插拔与高可用场景
PCIe 的电源管理在数据采集卡和加速卡上常被忽视,却会在服务器节能策略下咬人。ASPM L0s/L1:硬件自主进入微秒级省电,L0s 兼容性问题多(链路抖动、延迟尖峰),多数低延迟卡通过驱动或 BIOS 禁用;L1.1/L1.2 关断更多电路、省电明显但退出延迟到微秒数十微秒,适合空闲期长的卡,配置时要与主机的 LTR(Latency Tolerance Reporting)协商一致。软件 D 状态(D3hot/D3cold):驱动挂起/系统休眠进入,恢复路径等价一次重新训练,所有上下文需要重建;带 wake 引脚的卡可从 D3 发唤醒。FPGA 设计要保证进入低功耗前排空 DMA、主机保存队列上下文,恢复后完整走初始化,不能假设链路一直在。热插拔与 surprise removal:服务器热插拔槽有供电时序和 PRSNT# 检测;意外拔出时正在进行的 TLP 全部作废,驱动要能从完成超时和链路 down 事件恢复,FPGA 侧重新插入后等价冷复位。高可用系统(双控、冗余链路)还要设计链路故障检测定时器、切换策略和“脑裂”防护(切换决策与心跳分离,见 专家 43)。
延迟敏感部署(高频交易、实时采集)通常采取与省电相反的策略:禁用所有 ASPM、禁用 SSC(平台允许时)、固定 MPS/MRRS、轮询替代中断、固定 CPU 频率与中断亲和,把尾延迟的来源逐项消除。功耗与散热反过来影响链路:Gen4/5 收发器功耗随速率显著上升,散热不良导致芯片结温升高时眼图裕量缩小、重传增加甚至降速,因此高速卡的热设计要把收发器结温纳入监控(功耗签核见 专家 23)。把这些“非数据面”特性写进架构需求(是否休眠、是否热插拔、尾延迟目标、可用温度范围),比在联调阶段被平台默认策略打个措手不及要专业得多。
十三、验证策略:协议合规、互通与压力测试体系
FPGA PCIe 端点的验证要分三层组织。协议层验证(仿真):用 VIP 或开源检查器驱动 LTSSM 各状态、注入 CRC/序号错误验证重传、信用耗尽与恢复、配置读写全字段、FLR 复位序列、乱序完成重组、MPS 边界(1×MPS、MPS+1、4KB 边界)TLP 拆分;检查 AXI 侧响应不丢失。子系统验证(FPGA 原型):在开发板上跑官方驱动 + 自研测试驱动,覆盖 BAR PIO、SG DMA 双向、MSI-X 全部向量、各种传输大小曲线、持续压力;用厂商调试工具抓 LTSSM 迁移和错误计数。系统/互通验证(产品化):至少两代 x86 平台加一个 ARM/嵌入式 Root Complex(若产品涉及)、直连与经 switch、开/关 IOMMU、开/关 SSC、不同操作系统与内核版本、虚拟机直通(VFIO)场景;长时间满速双向(建议 72 小时以上)+ 随机复位/FLR/拔插注入;数据完整性用端到端 PRBS/CRC 比对而不只是“没报错”。
测试要自动化且结果可判读:开发一个 DMA 测试框架,参数化队列数、深度、传输大小分布、H2C/C2H 混合比,输出吞吐/IOPS/p999 延迟和校验结果;FPGA 侧内置错误注入寄存器(强制 CRC、制造 TLP 截断、拉低信用、触发 FLR),让异常路径在实验室就能被覆盖,而不是等现场首次发生。合规性方面,量产前应预留 PCIe-SIG 一致性测试或借用第三方实验室资源(眼图模板、极性、SSC 频偏、电气),自研卡即使功能全通也可能在电气测试不过关。最终把“仿真覆盖率条目—互通矩阵结果—压力报告—电气合规证书”作为发布门禁的一部分(发布纪律见 20 比特流烧录与四方版本一致 manifest/门禁、专家 46)。PCIe 是 FPGA 与外部世界最复杂的标准接口之一,尊重它的协议完备性和测试成本,是专家与“能点亮就行”的分水岭。还应把 PCIe 子系统的配置当作一份受版本控制的产品数据管理:IP 版本、参数(代际/宽度/BAR/MSI-X/SSC/MPS)、参考钟来源、均衡 preset、原理图版本、验证过的主机平台与 BIOS 版本、驱动版本必须绑定记录。现场出现“某批次主板枚举失败”时,这份组合表是唯一能快速复现和回归的依据。最后给团队分工建议:PCIe 至少需要一个人对协议层负责(LTSSM/TLP/配置空间),一个人对硬件信道负责(参考钟/电源/SI),一个人对主机软件负责(驱动/一致性/性能),三方在 bring-up 计划里明确各自的判据和交接点;把 PCIe 当作“一个工程师顺手做的外设”,几乎必然在联调后期成为整个项目的关键路径。再补充两个容易在产品后期才暴露的细节。其一是配置时间窗口:很多 FPGA 从闪存加载比特流需要数百毫秒到数秒,而标准主板在复位后很快开始枚举,金手指设备必须在主机扫描前准备好,常见解法是选择快速配置接口、压缩比特流、或由板上管理控制器先把 FPGA 配置好再释放 PERST#;忽略这一点会出现“冷启动看不到卡、重启却正常”的经典怪象。其二是调试口规划:Gen3 以上链路问题最终常需要示波器或协议分析仪,板上应在 AC 耦合电容附近预留可探测的测试点或隔离开同轴连接器的安装位置,等出问题再飞线几乎不可能测出可信眼图。把配置时序和可探测性与原理图一起评审,能避免两个代价极高的返工。再补一条部署经验:高速卡在不同机箱中的气流方向、相邻槽位发热和背板版本都会改变链路表现,现场安装规范应明确槽位要求和散热条件,并把首台安装的链路参数(速率、宽度、EQ、误码计数)拍照存档,作为后续维护的基线,使“换了机箱后偶发重训”这类问题有数据可比,避免把部署环境问题误判成 FPGA 设计缺陷,减少无意义的往返排查,也让安装文档与现场记录一一对应。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 链路不起查 IP | 多为物理/时钟 | 看 LTSSM 卡态+REFCLK/PERST |
| PIO 方式搬大数据 | CPU 占用高性能低 | 控制走 BAR、数据走 DMA |
| 读请求一个个等 | 带宽全是延迟气泡 | outstanding 拉满+SG 批量 |
| MSI 单中断多队列 | 锁竞争性能差 | MSI-X 多向量 |
| BAR 大小拍脑袋 | 枚举失败/空间不够 | 按 2 幂寄存器空间定 |
| Gen3 不查 SI | 反复 recovery | 眼图/均衡/参考钟抖动 |
相关与延伸
使用:PCIe XDMA 入门;DMA/驱动:PCIe DMA 架构。 物理层:收发器深水区;软件侧:嵌入式软件/Linux。
一句话总结
PCIe 分三层:物理层跑收发器(Gen1/2 用 8b/10b、Gen3+ 用 128b/130b),LTSSM 状态机从 Detect→Polling(对齐)→Configuration(宽度/lane 映射)→L0 训练链路;数据链路层用序列号+CRC+ACK/NAK 和流控信用保证可靠;事务层用 TLP 表达总线事务——MWr 存储器写是 Posted 不等应答(高效),MRd 读是非 Posted 要等完成包 CplD(分体往返延迟,靠多 outstanding 和 SG 批量拉满带宽)。枚举时主机读配置空间、按 BAR 声明给设备分配地址窗口,FPGA 的寄存器经 BAR 映射成 AXI-Lite、大数据走 DMA 转 AXI4/Stream;中断用 MSI-X(内存写消息、多向量支持多队列)。调试链路先读 LTSSM 状态:卡 Detect 查连接/复位,卡 Polling 查 100MHz REFCLK 抖动和信号裕量,lspci 核对协商速率宽度。