UVM TLM FIFO 阻塞语义:blocking_put/get 握手与缓冲解耦
更新时间:2026-09-29。TLM port/export/imp:UVM 组件通信的三层接口 讲了 TLM 连接的「插头插座」怎么接线;UVM driver 与 sequence item 的流转路径 讲了 sequencer 到 driver 的条目级握手。这一篇把镜头对准中间那个常被当作「透明管道」的环节——
uvm_tlm_fifo。它不是一根线,而是一个带深度、带阻塞语义的缓冲器;搞不懂满和空时谁挂起、谁继续,scoreboard 对不齐、driver 饿死、仿真莫名 hang 住都会找上门。
本文要回答的问题
blocking_put在 FIFO 满时、blocking_get在 FIFO 空时分别发生什么?- 用
uvm_tlm_fifo中转和 port 直连 export,语义差别到底在哪? - FIFO 深度设 1、设 2、设很大,各会改变什么行为?
peek、try_put/try_get什么时候该替换 blocking 版本?
一、阻塞语义本身:满挂起写方,空挂起读方
TLM 的 blocking 接口本质是任务(task),可以消耗仿真时间。uvm_tlm_fifo #(T) 内部是一个容量为 depth 的队列加两个 imp:put_export 和 get_export。规则只有两条:
put(tr):队列不满 → 立刻入队返回;队列已满 → 调用者所在进程挂起,直到有别的进程get走一个条目腾出位置。get(tr):队列非空 → 立刻出队返回;队列为空 → 调用者挂起,直到有人put进来。
注意挂起的是「调用者进程」,不是整个组件。driver 在它的 run_phase 里调 get 被挂起时,同组件里 fork 出来的其他进程照常跑——这是和「仿真卡死」要区分的第一点。
class my_scoreboard extends uvm_component;
  uvm_tlm_fifo #(mon_tr) fifo;
  // ...
  task run_phase(uvm_phase phase);
    mon_tr tr;
    forever begin
      fifo.get(tr);        // 空则挂起本进程
      check(tr);
    end
  endtask
endclass
下面这张时序图把深度为 2 的 FIFO 在「快写慢读」下的阻塞过程画了出来。
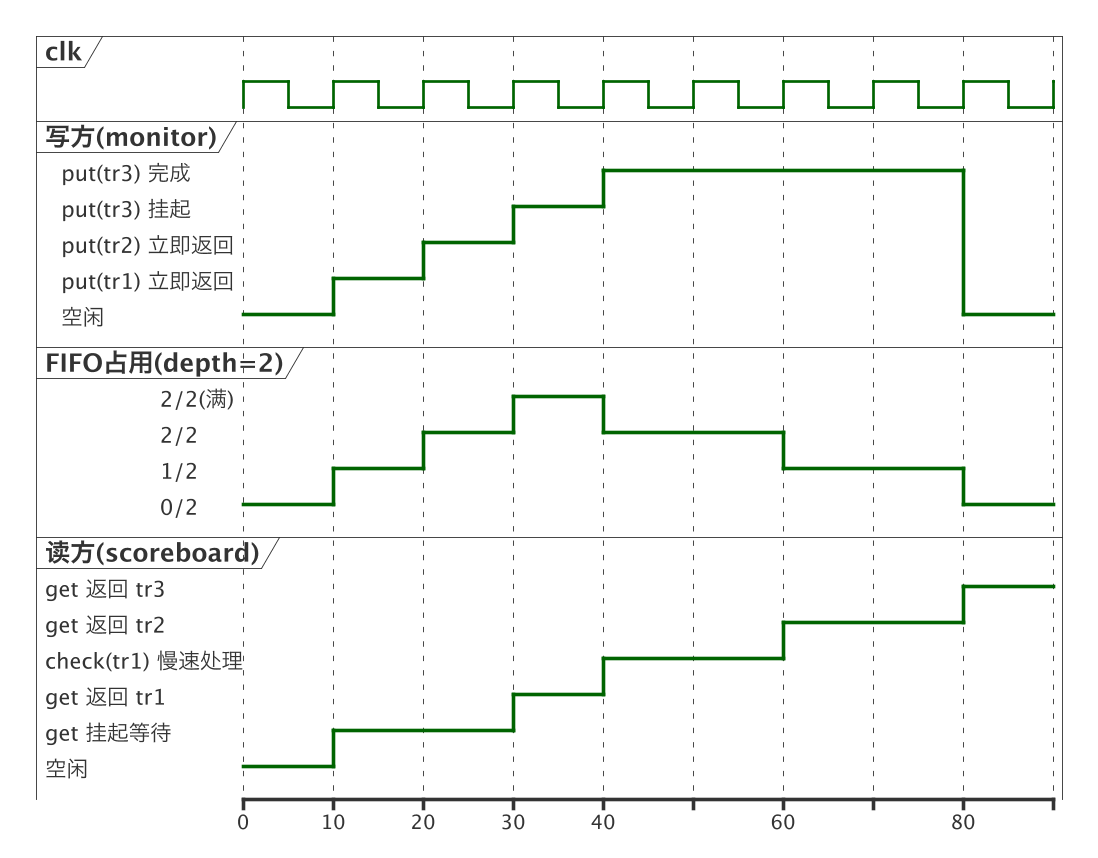
抓三个关键点读这张图:20ns 时 FIFO 占满 2/2,30ns 写方第三次 put 不返回,在波形上表现为写方状态停在「put(tr3) 挂起」;同一拍读方的 get 取走 tr1 腾出一个槽位,挂起的 put 才被唤醒、于 40ns 完成入队;60ns 之后读方慢慢追上,队列重新排空。阻塞语义的全部内容就浓缩在「put 等 get 腾位、get 等 put 喂数」这十个字里。
二、FIFO 中转 vs port 直连:一个解耦了时间
既然 port 可以直连 export,为什么还要塞一个 FIFO?用一张对比表说清楚。
| 维度 | port 直连 export/imp | uvm_tlm_fifo 中转 |
|---|---|---|
| 调用关系 | put 方直接执行 get 方(imp 所在组件)的方法体 | put 只入队,get 方独立进程消费 |
| 时间耦合 | 强:一次 put 的耗时 = 对端处理耗时 | 弱:put 耗时只取决于队列是否有空位 |
| 速率不匹配 | 快方被慢方拖住(背靠背串行) | 深度内可吸收突发,快方先跑 |
| 进程模型 | 单进程穿透两个组件 | 两端各自独立进程 |
| 典型场景 | driver ↔ sequencer 条目级握手 | monitor → scoreboard、跨时钟速率的生产消费 |
直连模式下 put 的实现是:port 顺着连接走到对端 imp,当场调用对端写的 put() 函数体,函数返回调用者才继续。这意味着对端处理逻辑多长,你这边的 stimulus 就被压多慢——monitor 采到一笔交易,scoreboard 的 write 里如果做了昂贵的参考模型比对,monitor 下一笔采样就被推迟,活生生把观测点拖成了性能瓶颈。
FIFO 把这条「实时调用链」斩断:monitor 的 put 只是入队,纳秒级返回;scoreboard 在自己的进程里按自己的节奏 get。两端只剩数据依赖,没有时间依赖——这就是所谓「解耦」。代价是引入了一个新问题:深度,也就是下一节。
三、深度选择的三种后果
uvm_tlm_fifo 构造时 new("fifo", this, depth),默认 depth=1。深度不是性能调参,是语义开关:
- depth=1:近似「乒乓单槽」。写方最多领先读方一笔,背靠背传输时 put/get 严格交替。对顺序敏感的比对场景(如按序检查)最安全,还能尽早暴露「写方其实不该跑那么快」的假设错误。
- depth=2~N(小):吸收短时突发。monitor 在一拍内可能连采两笔(如流水线同拍完成两级),深度 2 保证不丢也不阻塞。经验上,深度 ≥ 生产方单拍最大产出数就够。
- depth 很大:把速率不匹配彻底掩盖。仿真前期看起来一切顺滑,跑到几十万拍后队列里积压几万条未检查的交易,内存暴涨、波形回看困难,更糟的是 scoreboard 报错时对应的 stimulus 早已跑远,定位 bug 要在两条时间轴之间人肉对齐。
一张结构图看深度在组件拓扑里的位置。
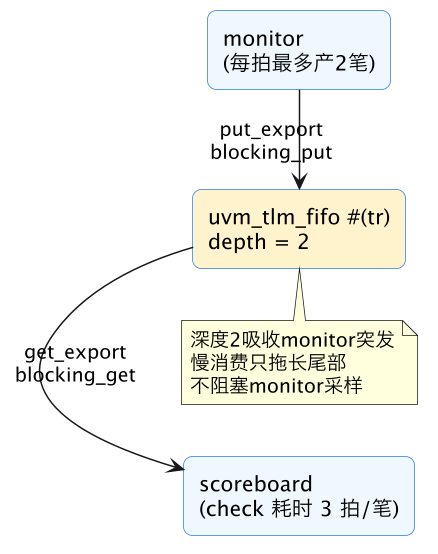
这张图的结构对应上面「快写慢读」的工程常态:monitor 侧瞬时产能高于 scoreboard 消化能力,depth=2 的 FIFO 恰好吸收 monitor 的单拍双发;scoreboard 慢没关系,只要平均消费速率不低于平均产出速率,队列占用就在 0~2 之间波动不溢出。反过来,如果平均速率倒挂,再大的深度也只是拖延满队列的时刻——这是选型时必须先算的账。
四、peek 与 nonblocking 变体:阻塞不是唯一选项
uvm_tlm_fifo 同时挂着 peek_export 和 get_peek_export,并提供全部 nonblocking 变体。什么时候换用?
peek(tr):只看不出队。同一笔交易要被两个消费者各读一次时(如 scoreboard 比数据、coverage 组件采覆盖),一个get+peek组合,或干脆用 UVM analysis 广播:一个 monitor 喂多个订阅者 的 analysis port 更顺——analysis 的write本身就是非阻塞广播,天然没有 FIFO 语义问题。try_put(tr)/try_get(tr):立即返回 bit 成败,不挂起。适用于「有就处理、没有就跳过」的轮询逻辑,比如 watchdog 组件周期性检查队列是否积压:if (!fifo.try_get(tr))就记录当前占用率。在 driver 主循环里用 try_get 通常是坏味道——那等于自己手写了一个空转轮询,既烧仿真性能又可能饿死其他进程。can_put()/can_get():查询容量状态不取数,配合uvm_event做自定义流控时用,日常很少直接碰。
还有一条容易被忽略的语义:get 返回的句柄是出队那一笔,但 peek 之后不做 get,下一笔 peek 拿到的还是同一个句柄——如果调用方没意识到、改了对象成员,所有还持有该句柄的组件看到的是被篡改后的值。事务对象在 FIFO 里是传句柄不是传值,这一点的连带影响(clone 与 copy 的边界)见 UVM clone 与 create:对象复制的正确姿势。
五、三个真实事故模式的快速判据
把阻塞语义反过来用,就是调试清单:
- 仿真 hang 在某一拍不动:先查是不是有
get永远等不到put——典型原因是 monitor 的 analysis 连接到 FIFO 的put_export没连上(connect_phase 里漏一行),或生产方被 objection 提前落下了。uvm_top.print_topology()加上 FIFO 的used()打日志,一分钟定位。 - scoreboard 报错的交易和 stimulus 对不上时间:FIFO 深度过大,积压导致检查滞后。把 depth 临时改 1 重跑,报错点立刻贴回案发时刻。
- 改了 FIFO 深度,随机回归通过率变了:这暴露的是验证环境本身对时序的隐式依赖——深度改变了阻塞点,也就改变了各进程被调度的相对节奏。健壮的环境应该对深度不敏感;敏感的根因多半是别处有竞争,参考 UVM 环境常见问题的调试方法论 里「先固化时序再暴露竞争」的思路。
这一篇在知识体系里的位置
- 接口基础:TLM port/export/imp:UVM 组件通信的三层接口 定义了本篇 FIFO 两端
put_export/get_export的连接规则。 - 握手上游:UVM driver 与 sequence item 的流转路径 讲的
seq_item_port.get_next_item()本质上也是一套带阻塞语义的 FIFO 式握手(sequencer 内建队列),与本篇互为印证。 - 广播替代:UVM analysis 广播:一个 monitor 喂多个订阅者 是非阻塞、一对多的另一极,选型时与本篇的 FIFO 方案对照。
- 对象语义:UVM clone 与 create:对象复制的正确姿势 回答「FIFO 传句柄」带来的共享修改问题。
总结
UVM TLM FIFO 阻塞语义只有两条:put 遇满挂起写方、get 遇空挂起读方,挂起的是调用进程而非组件;它与 port 直连的本质差别是用队列斩断了两端的时间耦合,换来速率解耦,代价是引入深度这个语义开关——深度 1 暴露时序假设、深度 2 吸收突发、深度过大掩盖速率倒挂并拖远报错现场;多消费者用 peek 或 analysis 广播、轮询用 try 变体,记住 FIFO 传的是句柄不是值,满挂起、空挂起这八个字就是排查所有 TLM 类 hang 的第一把钥匙。