非对称位宽 FIFO:写 32 读 8 的拼拆逻辑与统一窄侧单位的满空换算
专题导航:异步FIFO设计全景。前置要求:已读支柱页、异步FIFO 满空信号与FIFO 指针绕回与扩展位,知道普通等宽 FIFO 的指针比较、格雷码跨域与保守满空口径。 上一篇:FIFO almost-full 阈值设计 | 下一篇:FIFO 输出寄存器化的取舍(./fifo-registered-output-tradeoff.md)。 读序说明:前六篇都假设读写两侧等位宽;本篇放开这个假设,回答当一拍写 32 位、一拍读 8 位时,存储怎么摆、指针怎么走、满空还算不算得清。配套实验在工程包 derekzhuo/async-fifo-mini 的
tb/tb_asymmetric_width.v。
本文要回答的问题
- 两端位宽不同(32↔8)时,存储体到底按谁的宽度组织?一拍宽写在窄存储里占几格?
- 满空判定拿写指针和读指针直接比还有效吗?宽口一侧的指针每拍推进多少?
- 写 32 读 8 时一个宽字拆成的 4 个字节按什么顺序出队?反过来只攒到 2 字节时,宽读端能不能先读半个字?
- 同拍又读又写,满判定要不要把当拍腾出的槽算进去?先算读还是先算写?
- 位宽比为什么工程上只做 2、4、8、16 这种 2 的幂,3:2、5:4 到底难在哪?
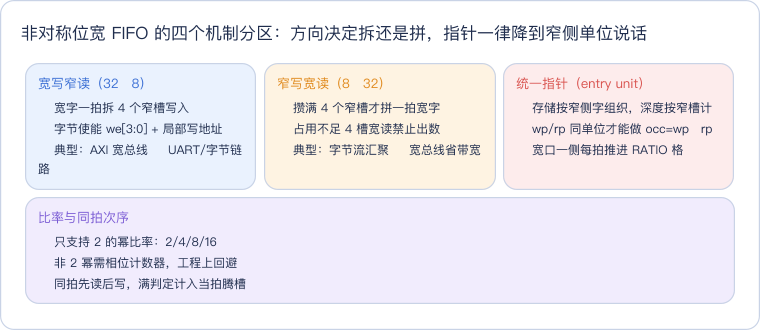
这张概念卡是全文地图:红蓝两组是数据方向(拆与拼),紫色一组是所有换算能成立的地基——指针必须降到同一个最小单位,绿色一组是工程约束。注意它与满空语义篇按「两个时钟域」分区的视角不同,本篇的切分轴是位宽方向。
一、什么时候需要非对称位宽
最常见的出处是总线到字节链路的对接。32 位 AXI/APB 侧一个总线周期给出 4 个字节,UART、SPI、字节级串行链路却只能一拍发一个字节——在跨时钟域 FIFO 的写口接 32 位、读口接 8 位,一次写入自动拆成四次读出,调用方不必再手写拆字寄存器组和四个拍的发送节拍。反方向同样高频:8 位采样口、字节报文流汇入 32/64 位内部总线或 DMA 时,用 8→32 的 FIFO 把零碎字节攒成宽字,下游每拍搬运的数据量翻四倍,总线握手次数和功耗都下降。
Xilinx FIFO Generator、Altera DCFIFO 都把 asymmetric write/read width 做成原生参数,前提是两侧位宽比为 2 的幂。理解了内部机制,就知道这个限制不是厂商偷懒,而是存储体与指针结构的自然结果。
二、存储体按窄侧字组织:一拍宽写拆成四个槽
核心决策只有一条:存储体按窄侧字(entry unit)组织。32→8 的 FIFO,RAM 宽度就是 8 位,深度参数 DEPTH 也以字节计;16 项深度意味着 16 个字节槽,而不是 16 个宽字。宽口写一拍时,一个 32 位字被拆成连续 4 个槽,靠写侧的字节使能 we[3:0] 与「局部写指针」(宽指针内的 2 位槽内偏移)把 4 个字节分别落到 RAM 的 4 个地址。
读图抓住绿色存储体:它根本不知道「宽字」的存在,阵列里只有一排等宽的窄槽。橙色拆字级把宽口语言翻译成窄槽语言,这是宽口侧唯一的额外硬件;蓝色两侧指针虽然身处不同时钟域,记账单位却完全一致,红色比较器因此能直接相减。灰色同步链与等位宽 FIFO 没有任何区别——格雷码跨时钟域原理那一套原封不动沿用,变化的只是指针每次跳变的步长。
窄写宽读是镜像结构:RAM 仍是 8 位宽,写口每拍填 1 槽,读口一次取连续 4 槽在出口拼成宽字,读指针每拍推进 4。两种方向共用同一张存储组织图,这正是「按窄侧组织」的回报——硬件核心只有一份。
三、满空换算:指针在统一的窄侧单位上比较
等宽 FIFO 里占用数是 occ = wp − rp,满是空槽为零。非对称之后公式形态不变,但每个指针的推进量变了:32→8 时写指针每拍 +4、读指针 +1;8→32 时写指针 +1、读指针 +4。指针宽度也要按窄槽总数取,16 字节深、写 32 读 8 的 FIFO 只有 4 个宽字容量,写指针却需要覆盖 16 个槽的寻址空间外加指针绕回用的扩展位。
满判定必须按「下一拍写需要几个槽」来算,而不是简单的 occ==DEPTH:宽口写需要 RATIO 个连续空槽,条件是 DEPTH − occ < RATIO;窄口写只需 1 槽,条件退化为 occ == DEPTH。空判定同理,宽口读一侧要求 occ ≥ RATIO 才允许出一个完整宽字。almost-full 阈值在混合位宽下也全部以窄侧 entry 表达——「剩 8 个字节槽」在 32→8 方向等价于「还能收 2 拍宽写」,阈值预算方法与almost-full 阈值设计完全相同,只是换算到宽口拍数时要除以 RATIO。
读这张波形对照「一拍 wclk 对四拍 rclk」:写侧第一个沿上 wr_en32 有效,W0 一次性占住槽 0–3,wp 从 0 跳到 4 后不再动;读侧连续四个沿,按地址顺序取出 7D、7C、7B、7A——低字节 0x7D 占低地址、最先出队,这是小端排布。occ 在写入后为 4,随后每读一拍减 1,四拍后回零、empty 拉起。一个宽字的生命周期,在两侧时钟里长度相差四倍,记账却从未离开过「字节槽」这一个单位。
同拍读写的更新次序是这个结构里唯一容易写错的地方:必须先执行读、再执行写,满判定计入当拍腾出的槽。occ 顶到 16 的那一拍,如果读侧同时取走 1 字节,宽写需要 4 个空槽——腾出 1 个仍然不够,写必须被拒;连续读到腾出第 4 个槽的那一拍,读写同拍才合法,当拍 occ 从 12 先降后升回到 15。顺序写反(先写后读)会在同一边界上错误地拒掉一笔合法写入,或在 RAM 模型里用旧 occ 误判溢出。
四、实测:字节序、半字边界与同拍满判定
道理用 iverilog 行为模型逐拍验证。存储体 16×8,实验 1 连写四个宽字(W0=7A7B7C7D、W1=6A6B6C6D、W2=5A5B5C5D、W3=4A4B4C4D,每字节取值互不相同,任何错位都会被 CHECK 抓住),再逐字节读回 16 项比对;实验 2 反向 8→32,先只写 2 字节试探宽读,再补齐 4 字节汇聚。
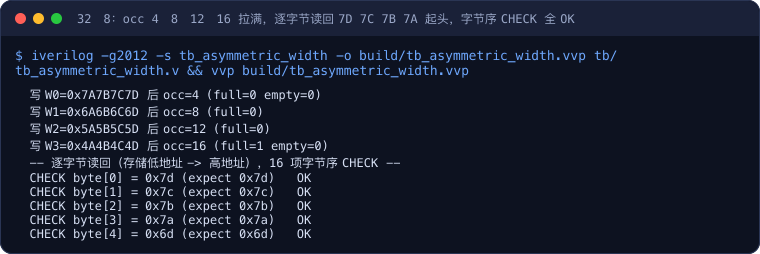
终端卡里 occ 随四次宽写精确地按 4 格一档上行:4、8、12、16,第 4 次写入后 full 拉起;读回的字节序从头四个槽开始是 7D 7C 7B 7A,即宽字 0x7A7B7C7D 的低字节落在低地址、按小端排布,16 项 CHECK 全部 OK。完整日志里还有两个边界证据:occ=16 时读写同拍只腾出 1 槽,宽写被明确拒绝(「空槽 1 < 本次需要 4」),再读三拍后第四个读沿与宽写同拍,槽位先腾后占,W4 才合法写入。
反向实验验证的是汇聚边界:只写入 11 22 两个字节时(occ=2),宽读请求不产出任何数据——半个宽字绝不允许提前出队,这是窄写宽读与宽写窄读最不对称的地方:拆字方向天然可以逐字节放行,拼字方向必须攒齐整个宽字才能交付。补齐 33 44 后 occ=4,宽读一拍输出 0x44332211,CHECK OK;随后连写 16 字节到 occ=16,第 17 字节被满判定拒绝且无覆盖。
两种方向的完整对照如下:
| 维度 | 宽写窄读(32→8) | 窄写宽读(8→32) |
|---|---|---|
| 典型场景 | AXI/APB 宽总线 → UART、字节链路 | 字节采样流 → 内部宽总线/DMA |
| 写指针推进 | 每拍 +4(一次占 4 槽) | 每拍 +1 |
| 读指针推进 | 每拍 +1 | 每拍 +4(一次取 4 槽) |
| 写侧满条件 | DEPTH−occ < 4(不足 4 空槽即拒) | occ == DEPTH |
| 读侧交付门槛 | 有 1 字节即可读 | 必须攒满 4 字节,半字不出队 |
| 主要风险 | 字节序摆反、同拍腾槽误算 | 残字滞留读不出、帧尾 padding 处理 |
位宽比变化时,所有数字都按窄槽重算,深度参数的含义随之换算:
| 位宽比(宽:窄) | 每宽字占窄槽 | 宽口拍容量(DEPTH 窄槽) | 宽口指针每拍推进 | 宽写满条件 |
|---|---|---|---|---|
| 2:1(16:8) | 2 | DEPTH/2 拍 | +2 | DEPTH−occ < 2 |
| 4:1(32:8) | 4 | DEPTH/4 拍 | +4 | DEPTH−occ < 4 |
| 8:1(64:8) | 8 | DEPTH/8 拍 | +8 | DEPTH−occ < 8 |
| 16:1(128:8) | 16 | DEPTH/16 拍 | +16 | DEPTH−occ < 16 |
五、为什么只做 2 的幂比率:非 2 幂的相位债务
2 的幂比率下,槽内偏移就是宽指针的低位:32→8 时低 2 位自然译码成 we[3:0],不需要任何比较器,宽字边界永远与地址边界对齐。换成 3:2(比如 24 位写、16 位读)这件事立刻变味:24 和 16 的最小公倍数是 48,每 2 次宽写或 3 次窄读才有一次边界重合,中间状态要一个相位计数器记录「当前宽字的哪个切片压在哪个窄槽上」,RAM 还要支持非对齐的跨槽写入;5:4 更糟,每 5 拍才对齐一次。
这笔相位债务包括三样硬件:模 N 相位计数器、随相位变化的字节使能图案(N 种而不是 1 种)、以及非对齐访问的拼接/拆分 MUX。验证成本同样膨胀——2 幂比率的边界只有「整宽字」一种,3:2 的边界有两三种相位,灰度指针在非等步长推进下的满空保守性证明也更绕。工业级 IP(Xilinx/Altera)因此只支持 2 幂比;真出现 24:16 这类需求,标准做法是两端各自做一个等位宽 FIFO,中间放一个独立的宽度转换桥(或先统一到 32 位),把相位逻辑隔离在可单独验证的小模块里,而不是让 FIFO 核心背债。
六、设计与思考:四个工程取舍
独立双 RAM 加状态机,还是单 RAM 字节使能? 单 RAM 按窄侧组织、靠 we 与局部指针拆拼,面积最省、指针只有一套,是上文模型和厂商 IP 的主流选择;代价是宽口侧的使能译码与残字处理逻辑耦合在 FIFO 核心里。另一条路是物理上放两块等宽 RAM 加一个搬运状态机(宽 RAM 与上游同宽、窄 RAM 与下游同宽,状态机负责两块之间整字交换),结构直白、残字状态显式可见,但面积翻倍、搬运节拍引入额外延迟,且本质上就是「两个 FIFO 加转换桥」的变体。深度小、比率固定时单 RAM 几乎总是更优;比率非 2 幂或方向需要运行时切换时,双 RAM 方案的解耦才值回面积。
两个方向能不能同一个 FIFO 同时支持? 数据结构层面可以——存储体反正都按最窄字组织;但接口语义会打架:32→8 方向宽口是写口,8→32 方向宽口是读口,同一组物理端口不能既写又读,凑齐两套端口就成了双口宽、双口窄的四口 RAM,残字计数器、满空方向、字节序定义全部要配成两套。工程结论是方向做成配置常量(综合期定死),不做成运行时寄存器;真有双向需求,实例化两个方向相反的 FIFO,让综合器裁掉不用的半边。
亚稳态之外的同源约束。 指针跨域仍是普通的格雷码加两级同步,本篇不引入新的亚稳态问题;但宽口侧多了一条容易忽略的同源要求:写使能与字节写指针(槽内偏移、we 译码)必须由同一拍同一套触发器产生,不能让 we 走组合支路、偏移走打拍支路。两者哪怕错开一拍,表现都是一个宽字的 4 个字节被写进两组相邻槽——数据不丢但顺序全乱,且这种错误在满空标志上毫无征兆,仿真偶现、上板难复现。判据很简单:凡是描述「同一次写入」的控制信号,全部从同一个寄存器状态扇出。
容量浪费与系统拆分。 非对称 FIFO 因为宽度不匹配天然有残字损耗:帧尾不足一个宽字时,窄写宽读方向要么等超时强行读出(带 padding 标志),要么永久滞留;宽写窄读方向则有最多 RATIO−1 个字节的排空尾巴。比率越大,尾巴越贵。若系统里宽度差异来自模块拼装而非真实链路需求(例如两侧其实都是 32 位,中间某级图省事挂了 8 位),更合理的取舍是统一总线宽度、删掉 FIFO 的非对称配置;只有链路协议本身规定了字节宽度(UART、某些 SerDes 字节接口)时,这份残字成本才非付不可。
代码获取:实验平台在独立公开仓库 derekzhuo/async-fifo-mini 的 tb 目录,本篇对应文件为 tb_asymmetric_width.v(自包含窄侧 entry-unit 行为模型 + 32→8 字节序 16 项 CHECK + 8→32 汇聚边界与同拍满判定,不依赖 rtl 目录)。克隆后执行 iverilog -g2012 -s tb_asymmetric_width -o build/x.vvp tb/tb_asymmetric_width.v && vvp build/x.vvp 即可复现本文全部输出;改 RATIO 与写入序列可验证 2:1、8:1 等其他 2 幂比率,本机需安装 Icarus Verilog。
实验环境
- 机器/系统:Mac(Intel)/ macOS,本机原生执行(未使用容器)
- 工具版本:Icarus Verilog 13.0(stable)
- 日期:2026-11-03
- 完整命令:
iverilog -g2012 -s tb_asymmetric_width -o build/tb_asymmetric_width.vvp tb/tb_asymmetric_width.v && vvp build/tb_asymmetric_width.vvp - 原始记录:本文终端卡内嵌输出与 run1.log 一致(32→8 共 16 项字节序 CHECK,8→32 汇聚宽字 0x44332211 CHECK OK,RESULT: PASS),实验源码见上述工程包
这一篇在知识体系里的位置
本篇是异步FIFO 专题原理段第七篇。异步FIFO 满空信号的保守欠账与FIFO 指针绕回与扩展位的指针状态空间在非对称结构里原样成立,本篇只是把两者的记账单位统一降到窄侧 entry;阈值预算沿用上一篇FIFO almost-full 阈值设计的减法公式,跨域折算时除以位宽比换算成宽口拍数;读端残字与交付门槛的语义则要和 FIFO FWFT 与标准读模式的弹出口径一起理解。支柱页异步FIFO设计全景串起整条路径。
总结
非对称位宽 FIFO 的全部技巧可以压成一句话:存储体按窄侧字组织,读写指针在统一的 entry unit 上记账。32→8 时一个宽字拆成 4 个连续字节槽、写指针每拍推进 4、满判定要求至少 4 个空槽;8→32 时镜像汇聚,且必须攒满 4 字节才允许宽读出数,半字绝不提前交付。字节序按低字节占低地址的小端排布,同拍读写坚持先读后写、满判定计入当拍腾出的槽。iverilog 实测逐拍坐实:四次宽写后 occ=4/8/12/16 且 full 拉起,16 项字节序 CHECK 全 OK(7D 7C 7B 7A 起头),occ=16 时只腾 1 槽的宽写被拒、凑齐 4 槽的当拍宽写成功,反向只写 2 字节宽读不出数、补齐后输出 0x44332211。工程上只做 2、4、8、16 这类 2 幂比率,因为非 2 幂要付相位计数器与非对齐访问的双重债务;实现首选单 RAM 加字节使能,方向在综合期定死,写使能与字节写指针必须同源扇出。