UVM sequence 仲裁:lock/grab、优先级与 SEQ_ARB 算法选型及饿死防治
更新时间:2026-09-28。在 sequence 与 driver/scoreboard 协作 里,一个 sequence 把 item 交给 sequencer、driver 再逐个取走,链路是干净的点对点。可真实环境很少这么单纯:复位 sequence、定向业务 sequence、随机背景流 sequence 往往同时挂在同一个 sequencer 上,谁先拿到 driver、谁被压住,全靠 sequencer 内部的仲裁器说了算。这一篇拆开 UVM sequence 仲裁的裁决机制:握手请求如何排队、lock/grab 怎么插队、优先级何时生效、六种仲裁算法各适合什么流量,以及最容易被忽视的高优先级饿死问题。
本文要回答的问题
- start_item 到 finish_item 之间,sequencer 内部到底发生了什么?
- 多个 sequence 同时等 driver 时,默认按什么顺序放行?
- lock 和 grab 都能独占 sequencer,语义差别在哪里?
- set_arbitration 的六种 SEQ_ARB 类型各自的行为与适用场景是什么?
- 高优先级 sequence 持续灌流量把别人饿死,怎么发现、怎么防?
一、从一次 item 下发看仲裁的位置
单个 sequence 跑在 sequencer 上时,感觉不到仲裁的存在:start_item 一调用就返回,finish_item 把 item 送出去,driver 的 seq_item_port.get_next_item 取走。仲裁只在「同一个时刻有多个 sequence 都想发 item」时现身。
拆开看,start_item(item) 内部调用 wait_for_grant,这是一个会挂起的请求:sequence 向 sequencer 的仲裁队列登记自己,然后阻塞等待。sequencer 那一侧,driver 每次调用 get_next_item(或 try_next_item)都会触发一次仲裁:从所有等待中的请求里按当前仲裁算法挑一个,把 grant 发给赢家,输家继续等。赢家拿到 grant 后 start_item 才返回,随后 finish_item 里的 send_request 把 item 推进 sequencer 的请求队列尾部,driver 真正读到 item。
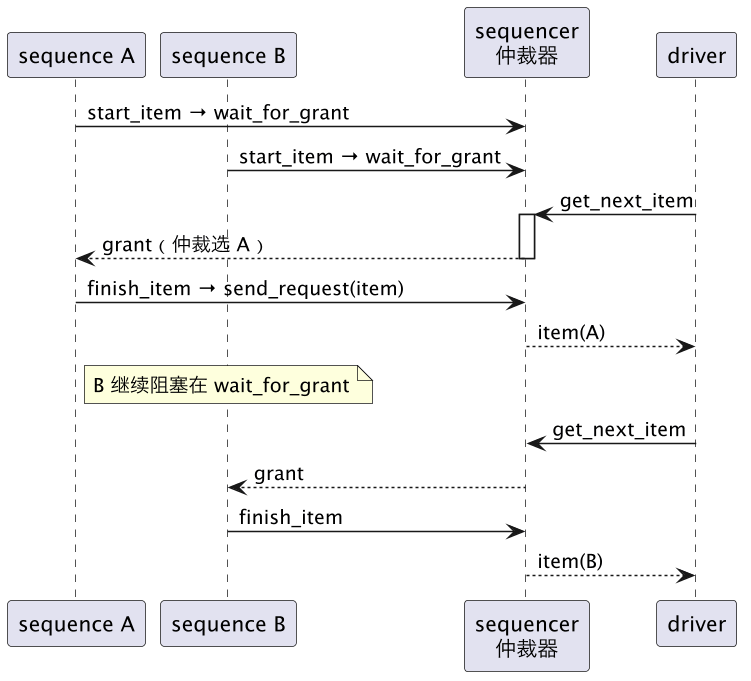
这张时序图有三个值得记住的点。第一,仲裁的触发方是 driver 而不是 sequence——sequence 只负责排队,谁先来谁先排,但先排不一定先走。第二,grant 与 item 发送是两步,中间隔着 finish_item;在这段窗口里 sequence 可以做 item 的后随机化(post-randomize),不需要时就该尽快把 item 交出去,否则占着 grant 不放会拖住所有人。第三,driver 若长时间不取 item(比如在等总线 ready),仲裁根本不发生,所有 sequence 一起等——这是「driver 慢」与「仲裁不公平」两种卡顿现象的分界。
二、仲裁请求队列:谁先排、谁走
sequencer 内部为每个发起请求的 sequence(严格说是每个 sequence 的每个未决 item 请求)登记一条记录,记录里带优先级数值。每次仲裁时,仲裁器先过滤出「可参与」的请求——被 lock 挡住的、grab 没轮到的不算——然后交给当前仲裁算法排序,取队首。
start_item 的完整签名是 start_item(item, set_priority = -1)。这个 set_priority 就是请求的优先级,缺省 -1 表示「继承 sequence 自身的默认优先级」(一个 sequence 没特别设置时也是 -1,仲裁器内部按普通档处理)。数值越大优先级越高,这一点和直觉一致,但注意它只在支持优先级的仲裁算法下生效(见第四节表格)。
另外一个容易混淆的点是:优先级挂在「每一次 start_item 调用」上,不挂在 sequence 类型上。同一个 sequence 可以在不同 transaction 上用不同优先级——比如告警帧用 100、普通数据帧用 0——这比「整个 sequence 一个优先级」灵活得多。
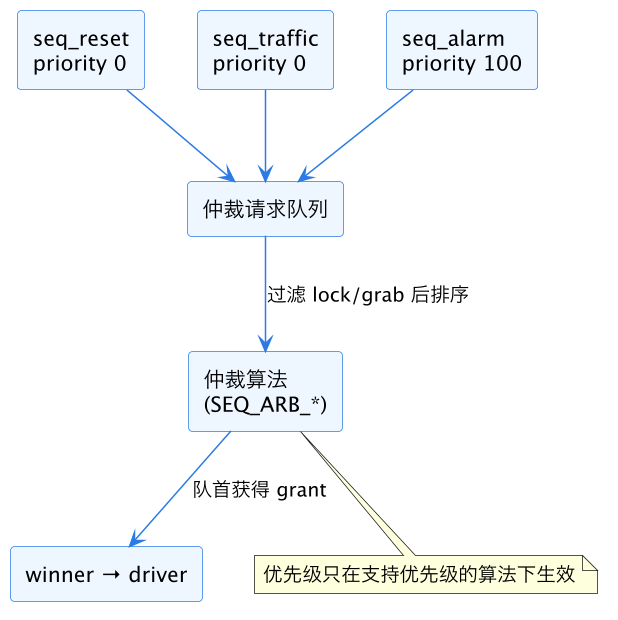
图中三条请求同时入队,seq_alarm 带着 100 的优先级。在 SEQ_ARB_WEIGHTED 或 SEQ_ARB_STRICT_FIFO 这类感知优先级的算法下它会先走;在默认的 SEQ_ARB_FIFO 下,这个 100 被完全忽略,纯粹按登记顺序放行。很多「我设了优先级怎么没用」的疑问,答案就是算法没换。
三、lock 与 grab:两种独占的区别
测试场景里常见「这一串 item 必须连着发,中间不许别人插进来」的需求:比如配置寄存器要先写地址再写数据,插进一笔别的写就配错了地址。UVM 给两种独占手段。
lock() 在 sequencer 的 lock 队列尾部登记,轮到自己时获得独占权,之后该 sequence 的 item 连续放行,其他 sequence 的 start_item 全部阻塞,直到 unlock()。特点是排队等:如果已有别人拿着 lock,你的 lock() 会挂起等它释放。
grab() 不排队,直接插到 lock 队列最前面,下一个仲裁点就轮到它。也就是说它能抢走当前其他 sequence 正在等待的 lock 资格,但不能打断已经持有 lock/grab 的 sequence——已在位的独占者仍然要等它 unlock()/ungrab()。配对释放是 ungrab()。
| 维度 | lock / unlock | grab / ungrab |
|---|---|---|
| 插队位置 | lock 队列尾部 | lock 队列最前 |
| 已有独占者时 | 挂起等待 | 同样挂起等待 |
| 已有排队者时 | 排在队尾 | 越过所有排队者 |
| 典型用途 | 常规原子序列(寄存器配置串) | 紧急抢占(错误注入、复位打断) |
| 忘记释放后果 | 整个 sequencer 死锁 | 同上 |
一张图把队列位置说清。
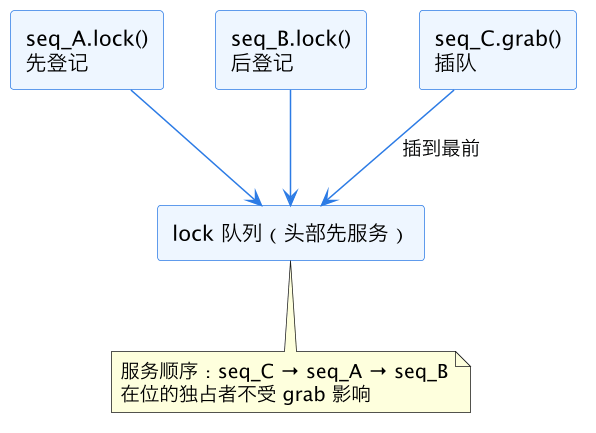
使用上的纪律有三条。第一,lock/grab 区间尽量短,里面只做必须连续的那些 item,前后能拆出去的就拆出去。第二,unlock() 必须放在所有路径都能走到的地方,sequence 被 kill() 或抛出异常时锁不释放,sequencer 从此瘫痪——稳妥写法是在 body 外层包一层保护,或干脆改用 uvm_do_on_with 加优先级而不是真锁。第三,virtual sequence 通过 virtual sequencer 向多个子 sequencer 分别 lock 时,要注意多个子锁之间的顺序一致,否则两个 virtual sequence 互相拿对方要的下一把锁,就是教科书式死锁。
再看两个真实的误用案例。案例一:某项目在错误处理 sequence 里先 grab(),随后调用一个会等待中断的 task,而中断的产生依赖另一条背景 sequence 继续发流量——背景流被 grab 堵死,中断永远不来,grab 方也永远不释放,仿真挂死。教训是:lock/grab 区间内绝不允许依赖「别人的流量」才能推进的条件,独占期间你只能靠自己手上的 item 走完全程。案例二:工程师想「临时插一笔高优先 item」,图省事用 grab,但这个 sequence 是常驻循环体,每轮都 grab 一次,效果等同永久锁,其他 sequence 名义上有优先级却一个 item 都发不出去。定位这种问题时,打开 sequencer 的仲裁调试打印(UVM_MEDIUM 以上 verbosity),能看到 grant 始终落在同一个 sequence id 上,几分钟即可锁定元凶。经验法则:能用优先级表达的需求不用 lock,能用 lock 的不用 grab;grab 只留给「真的要把别人正在排的队也踩过去」的那一两次。
四、六种 SEQ_ARB 算法对比
sequencer.set_arbitration(SEQ_ARB_TYPE) 决定每次 driver 请求时如何排序。UVM 提供六种,差异集中在「是否看优先级」「同级之间按什么顺序」。
| 算法 | 看优先级 | 同级排序 | 公平性 | 典型场景 |
|---|---|---|---|---|
| SEQ_ARB_FIFO(默认) | 否 | 严格按登记先后 | 先来先服务,可能头阻塞 | 单流量或流量差异小 |
| SEQ_ARB_WEIGHTED | 是 | 同级内加权随机 | 高优先级大概率先走 | 背景流 + 偶发高优先业务 |
| SEQ_ARB_RANDOM | 否 | 纯随机 | 长期统计公平 | 想打乱激励顺序做覆盖 |
| SEQ_ARB_STRICT_FIFO | 是 | 同级按登记先后 | 高优先级绝对优先 | 告警/复位必须立即插入 |
| SEQ_ARB_STRICT_RANDOM | 是 | 同级随机 | 高优先级绝对优先 | 同左,但同级想打散 |
| SEQ_ARB_USER | 自定义 | 自定义 | 看实现 | 特殊调度(如 QoS 轮转) |
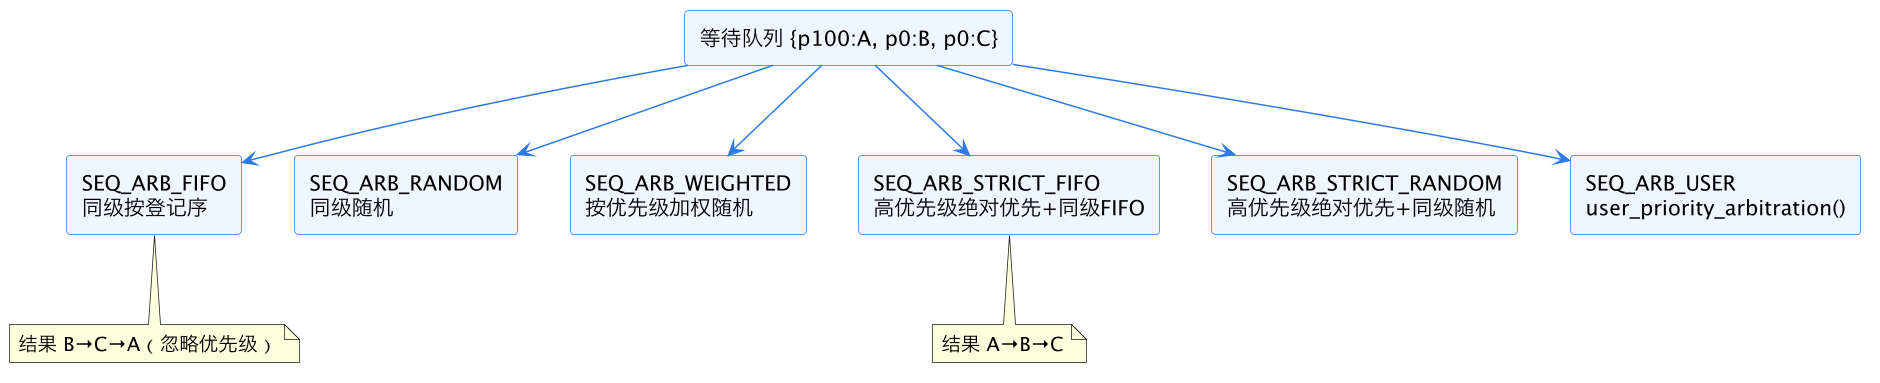
对照图读:同样一个等待队列,FIFO 把最先登记的 B 放走,完全无视 A 的 p100;STRICT_FIFO 则让 A 无条件先走,B、C 之间再按登记序。选择时抓两个决策点:一是「有没有必须绝对先走的流量」,有就上 STRICT 系;二是「同级流量要不要打散顺序」,要打散用 RANDOM 系。
SEQ_ARB_USER 值得单独说两句:它要求你在派生的 sequencer 类里重写 user_priority_arbitration 函数,输入是等待请求的队列,返回你选中的下标。它适合做「业务感知的调度」——比如模拟真实总线 QoS 的轮询、或按 item 里的地址区间做分组公平——但代价是排序逻辑全由你负责,写错了没有框架兜底,仿真表现出来的就是莫名的激励顺序,非常难查。
设置仲裁算法的时机也有讲究:在 env 的 build_phase 或 test 的 build_phase 里 set 一次即可,运行中途切换算法是允许的(仲裁器每次裁决都读当前值),但除了专门的「动态 QoS」实验,没有理由在 run 阶段来回切。
这里有个常见误解要澄清:set_arbitration 是 sequencer 上的一个普通函数调用,立即生效、无需重启 phase。它没有走 config_db 的自动应用通道——config_db 里那把 uvm_sequencer_arb_mode 的 arbitration 键只是 UVM 基类帮你提供的一条配置路径,sequencer 在 build_phase 末尾自己去取出来调用 set_arbitration。因此两条路任选其一:要么 test 直接 sqr.set_arbitration(...)(最直白),要么 env 用 config_db set 给基类代劳。最怕的是两边都写且值不同:直接调用的那一次生效顺序未必是你想的,出问题时先在日志里确认 sequencer 打印的最终仲裁模式。另外注意生效粒度是「下一次仲裁」——已经发出的 grant 不会收回,等待队列里已有请求的相对关系也不重排,切换算法只影响之后的裁决。
五、饿死问题:高优先级流量的另一面
STRICT 系算法解决「紧急流量插不进去」,代价是引入了饿死(starvation):只要高优先级 sequence 源源不断地发 item,低优先级的永远轮不到。这在定向测试里往往就是本意,但在随机回归里是隐蔽的覆盖率杀手——某条低优先级通路的 coverage bin 永远打不中,报出来的原因却是「激励没走到」,排查时很容易先怀疑 constraint 写错了。
饿死有三种典型来源。一是高优先级 sequence 是无限循环的背景流(forever body 里不断 uvm_do),没有发送间隙,低优先级从仿真开始就没 grant 过。二是 lock 忘记释放,等价于永久饿死。三是优先级用错:本想「偶尔优先」却给了 STRICT_FIFO 加上远高于别人的固定值。
防治手段按代价从低到高排:
- 流量整形:高优先级 sequence 的 body 里插入随机间隔(
#delay或先发几笔低优先 item),留出 grant 窗口。零框架改动,最常用。 - 改用 WEIGHTED 替代 STRICT:高优先级变成「大概率先走」而非「必然先走」,低优先级长期统计上总能轮到,饿死从确定事件变成小概率事件。
- 优先级分层而非悬殊:100 对 0 的差距只在 STRICT 下致命;把档位控制在 2 对 1 这种比例,配合 WEIGHTED 更接近真实总线 QoS。
- 仿真结束检查:在 scoreboard 或 sequence 的收尾处断言每条流量通路都至少发出过 N 笔 item,没发到就直接报 error,把饿死从「漏覆盖」变成「用例失败」。
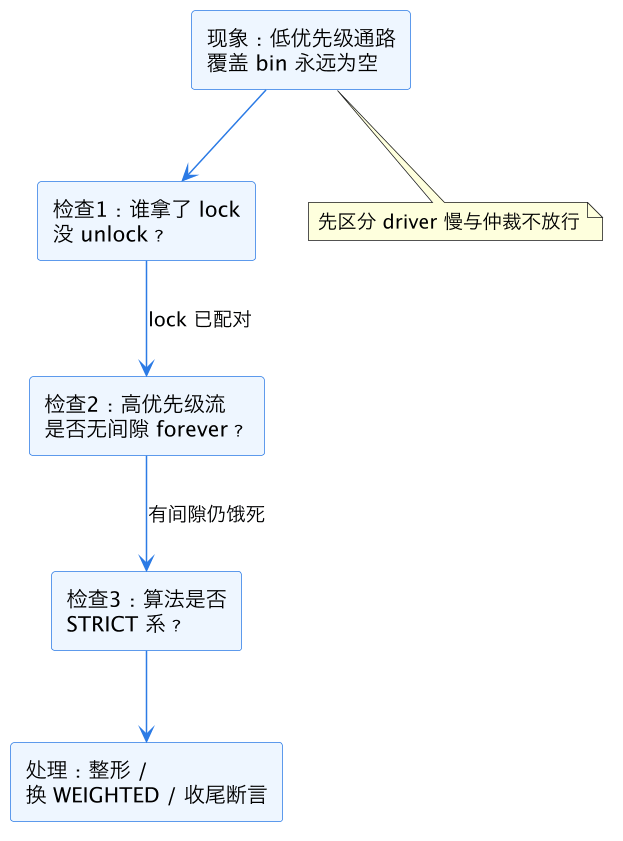
排查顺序图里第一步先问 lock——因为它后果最重(全堵死)且最好验证(搜 lock( 与 unlock( 配对)。再确认高优先级流是否有发送间隙。最后才落到算法选型。还有一个前置判断:如果 driver 本身就取不动 item(比如等总线 grant),那不是饿死而是下游反压,改仲裁算法无济于事,该去查 driver 或总线侧。
六、工程实践:一个多流量 sequencer 的配置样例
把前面的件拼起来,一个典型的 AXI agent 环境可能长这样:背景随机流量(priority 0)、定向业务(priority 0,但用 lock 保证 burst 原子性)、错误注入(priority 100,用 grab 抢占)。
class axi_err_seq extends uvm_sequence #(axi_txn);
  `uvm_object_utils(axi_err_seq)
  task body();
    p_sequencer.grab(this);            // 抢占,插到 lock 队首
    `uvm_do_with(req, { op == ILLEGAL_WRITE; })
    p_sequencer.ungrab(this);
  endtask
endclass

class axi_env extends uvm_env;
  function void build_phase(uvm_phase phase);
    super.build_phase(phase);
    // 高优先级要绝对先走,同级之间保持 FIFO 可预期
    uvm_config_db#(uvm_sequencer_arb_mode)::set(this, "agt.sqr",
        "arbitration", SEQ_ARB_STRICT_FIFO);
  endfunction
endclass

// 或者直接在 test 里:
function void my_test::build_phase(uvm_phase phase);
  agt.sqr.set_arbitration(SEQ_ARB_STRICT_FIFO);
endfunction
注意错误注入 sequence 里 grab 的配对写法,以及仲裁算法只设一次。如果项目里还要求「同级背景流顺序打散以便覆盖更快收敛」,把 STRICT_FIFO 换成 STRICT_RANDOM 即可,其余代码不动。
还要特别说明 virtual sequence 场景下仲裁的独立性。一个 SoC 环境常见三个 agent 各带自己的 sequencer,virtual sequence 通过 virtual sequencer 同时往三路发激励。此时每个子 sequencer 的仲裁器互不相干:AXI sequencer 用 STRICT_FIFO,APB sequencer 用默认 FIFO,两条通路的裁决并发进行,谁也不排队等谁。含义有三层。其一,virtual sequence 里连续两句 uvm_do_on 发到不同 sequencer,只是两个独立的 start_item,它们之间没有任何顺序保证,跨通路的时序关系要靠 fork/join 或显式同步原语自己维护。其二,lock 也是 per-sequencer 的:virtual sequence 想「三路同时原子」,必须分别对三个子 sequencer 各 lock 一次,而且多把锁的获取顺序要在所有 virtual sequence 里全局一致——vseq_a 先锁 AXI 再锁 APB,vseq_b 却反过来,两个并发时就各握一把等对方,前面说的死锁就是这样发生的。其三,饿死也是 per-sequencer 评估的:AXI 通路饿死不代表 APB 不通,收尾断言要按通路分别统计,不能拿全环境总 item 数当健康指标。
横向对比三种「插入紧急流量」的做法,选型一目了然。
| 做法 | 插队强度 | 对同级影响 | 适用 |
|---|---|---|---|
| 高 priority + STRICT 算法 | 每次仲裁都先走 | 持续压制,可能饿死 | 紧急但持续的流(告警) |
| lock | 轮到时连续独占 | 独占期间全堵 | 原子配置串 |
| grab | 立即抢到下一次独占 | 同 lock,但拿到更快 | 一次性打断(错误注入、复位) |
最后提醒一个与 SystemVerilog TLM 通信 侧的对称点:仲裁发生在 seq_item_port 这条激励通路上,monitor 到 scoreboard 的 analysis 通路没有仲裁概念——它是广播,没有竞争。两边的「多对一」问题性质不同,不要用同一套思路去调。
这一篇在知识体系里的位置
- 向上承接:sequence 与 driver/scoreboard 协作 建立单 sequence 的 start_item/get_next_item 握手,本篇回答多 sequence 竞争时谁走谁等。
- 机制基础:UVM 组件与 phase 中 sequencer 作为组件的定位,以及 build_phase 配置仲裁算法的时机。
- 横向相关:SystemVerilog TLM 通信 讲组件间事务通路,本篇聚焦激励通路上的裁决。
- 落地延伸:AXI UVM 环境搭建 中多 sequence 并发挂同一 sequencer 的真实组织方式;分层 testbench 架构与复用 里 virtual sequencer 下多子 sequencer 的 lock 顺序问题。
总结
UVM sequence 仲裁由 driver 的取 item 动作触发,sequencer 按当前 SEQ_ARB 算法从等待队列里选赢家:lock 排队独占、grab 插队独占,start_item 的 set_priority 只在 STRICT/WEIGHTED 等感知优先级的算法下生效;STRICT 系保证紧急流量绝对优先但会饿死低优先级,防治靠流量整形、换 WEIGHTED 与收尾断言,排查时先分清是仲裁不放行还是 driver 取不动。