FPGA 在线升级与 multiboot:黄金镜像双区 Flash 布局与 fallback 回退机制
设备挂在郊外的铁塔上、埋在机房的线缆深处,或者已经卖出去一万台散在全国各地——这些场景里,「插着 JTAG 线重新烧一遍」从来不是一个可用的维护手段。FPGA 又是 SRAM 工艺的易失器件,每次上电都要从板载 Flash 重新加载比特流,于是自然产生一个需求:让设备自己通过网口、串口、CAN 把新比特流收下来,写进 Flash,再重新配置自己。这就是 FPGA 在线升级(in-field reconfiguration),而让它敢在无人现场使用的安全机制,叫 multiboot(多重引导)。
同批的三篇姊妹篇分别讲了配置通道的分类(FPGA 配置方式有哪几种)、单次上电的时间轴(FPGA 上电配置时序)和下载固化的具体操作(FPGA 入门 32:比特流下载与固化)。这三篇默认 Flash 里只有一份镜像、启动地址固定不变;本文讲的是下一层问题:配置地址可以变,而且配置失败时硬件会自动换一个地址重来。注意它和「动态局部可重构」不是一回事,后者不重新配置整个芯片,区别见 FPGA 局部重配置入门。
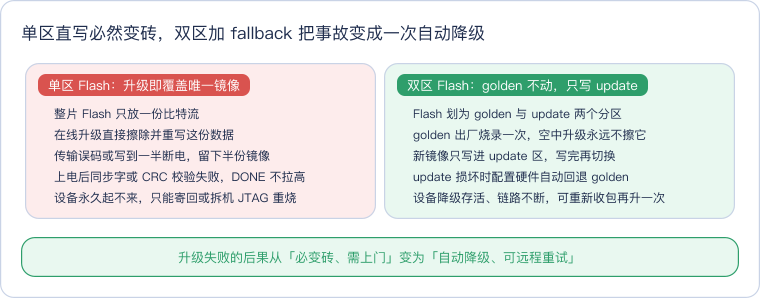
左右两栏的差距,就是 multiboot 存在的全部理由。左栏不是假想的糟糕设计,而是很多团队第一版远程升级的真实写法:能跑通整个下载、擦写、重启流程,于是以为功能完成,直到某次升级赶上停电。右栏也不需要多复杂的硬件,它只要求你在画板子和定 Flash 地址时遵守一套约定,剩下的跳转与回退由 FPGA 的配置控制器完成。
本文要回答的问题
- 为什么「把新镜像通过网络写进 Flash」不够,变砖风险具体发生在哪一步?
- golden 和 update 两个区在 Flash 里怎么摆,地址由谁告诉 FPGA?
- FPGA 上电后凭什么知道该去哪个地址读镜像?WBSTAR 和 IPROG 是什么?
- update 镜像坏掉以后,「自动回退」到底在什么条件下才会触发,什么情况下救不了你?
- 看门狗、版本计数这些软件机制,分别在补硬件回退的哪个漏洞?
一、为什么要多镜像:在线升级的变砖风险
先把一次最朴素的远程升级摊开看。设备正在运行旧逻辑,它通过网络收到一份新比特流,应用逻辑擦除板载 SPI Flash,把新数据逐页写进去,写完后拉低 PROGRAM_B 或者触发内部重配置,让 FPGA 重新加载。一切顺利的话,几秒后设备跑着新逻辑重新上线。
危险全部集中在「擦除完成」到「新镜像写完并校验通过」这段窗口。Flash 的擦除单位是扇区(典型几十到几百 KB),写入单位是页(典型 256 字节),整个比特流却有几 MB 到几十 MB,写一遍要花几十秒。这段时间里 Flash 上的内容是「旧的已碎、新的未全」的中间态:断电、复位、软件跑飞、链路中断,任何一件事都会把这份中间态固化下来。下次上电,FPGA 从 Flash 固定起始地址读到的是一份残缺比特流——找不到同步字,或者帧数据的 CRC 对不上,配置中止,INIT_B 报错,DONE 永远不拉高,应用逻辑根本不存在,自然也没有任何网络栈可以再收一份补救镜像。设备就此变砖。
这和软件升级的 A/B 分区是同一个思想,但 FPGA 有个特殊之处:判断「镜像能不能用」的能力不在镜像里,而在芯片的固化配置硬件里。CPU 上 bootloader 本身可能就是被写坏的对象;FPGA 上配置控制器损坏不了,只要让它在第一份镜像失败后去读第二个地址,设备就一定还有起点。multiboot 本质就是把「第二地址」和「失败后去第二地址」做成配置控制器的硬件行为。
还要分清两个层次的失败:比特流没写完、CRC 错、同步字丢属于配置加载失败,硬件看得见、救得了;镜像完整加载、DONE 拉高后才因代码缺陷死锁,则属于运行期失败,配置硬件一无所知,要靠外部看门狗把芯片拉回配置流程(第五节细讲)。
二、Flash 双区布局与地址约定
双区设计的第一原则是两个区物理隔离、擦除互不影响。常见的 Flash 排布如下表,实际地址随器件容量与手册而定,表中地址只表达相对位置关系。
| 分区 | 相对位置 | 内容 | 谁能写 | 升级时是否擦除 |
|---|---|---|---|---|
| golden 区(黄金镜像) | Flash 低地址,从 0 起始 | 出厂版精简比特流:含 Flash 写控制器与通信口,保证能收镜像 | 仅产线 JTAG/烧录器 | 永不擦除 |
| update 区(升级镜像) | golden 之后的高地址,按扇区对齐 | 最新全功能比特流 | 应用逻辑在线擦写 | 每次升级整区重写 |
| 元数据区(可选) | Flash 顶部扇区 | 版本号、升级计数、镜像长度与镜像自身 CRC、重试标记 | 应用逻辑按扇区写 | 按字段更新 |
三个地址约定值得逐条记住。其一,golden 必须放在 FPGA 的默认配置起始地址。主 SPI 模式下 FPGA 上电无条件从 Flash 的 0 地址开始读,所以这份镜像必须永远可信,它是整个链条不依赖任何前提的锚点。其二,update 区起始地址要按 Flash 扇区边界对齐,更要按配置控制器要求的地址粒度对齐:不同家族对跳转地址的单位约定不同(有的按字节、有的按字),把 update 地址写错单位是现场最常见的低级错误,具体格式以所用器件的配置指南为准。其三,两个区之间留出整扇区的隔离余量,不要让 update 区的擦除范围在扇区回绕时蹭到 golden 区的尾扇区——擦除指令一旦误指 golden 所在扇区,安全绳就被自己剪断了。
golden 镜像要刻意做小、做稳、做少:不需要全部业务功能,只保留三件事——一个最基础的通信口、一套能擦写 update 区的 Flash 控制逻辑、下一节要讲的跳转逻辑。功能越少越久不用改,它的价值恰恰在于「旧而可靠」。
元数据区是工程化补充,不是 multiboot 硬件的一部分:固定扇区里存镜像长度、期望 CRC、版本号,golden 启动先读它判断 update 是否有效;升级计数与重试标记则用于第六节的死循环防护。Flash 只能把 1 写成 0,更新字段要按扇区擦除或用追加日志式写法。
三、multiboot 硬件机制:WBSTAR、IPROG 与 fallback 触发
现在到了核心问题:FPGA 上电只认 0 地址,那它怎么会跑去高地址读 update?答案是一次由 golden 主动发起的「热启动」(warm boot / warm reconfiguration,不重新上电的内部重配置)。Xilinx 家族把这套机制称为 MultiBoot,关键寄存器叫 WBSTAR(Warm Boot Start Address,热启动起始地址寄存器),触发命令是比特流内嵌的 IPROG(Internal PROGram,内部重配置)命令;Intel(Altera)家族的远程更新方案里有平行的重配置地址与远程更新控制逻辑(如 ASMI/remote update IP),名字不同,模型一致。下文用通用名描述,具体寄存器位域与命令编码一律以各家手册为准,本文不给固定数值。
读这张图抓住颜色语义:灰色是无条件入口,蓝色是配置控制器的加载动作,橙色是 golden 执行的跳转动作,红色是失败相关节点,绿色是成功落点。整条链分两棒:上电后硬件先把 0 地址的 golden 加载起来,这一棒不需要任何人帮忙;第二棒由 golden 的逻辑完成——向热启动地址寄存器写入 update 区地址,再发出内部重配置命令,配置控制器于是不经过断电重来,直接从新地址重新走一遍配置流程。这个「第二棒」是很多人对 multiboot 最大的误解来源:回退不是纯硬件自动的,跳转到 update 这一步必须由 golden 发起。如果 golden 比特流生成时没有使能多引导属性、逻辑里也没有写地址和触发跳转的动作,设备会永远停在 golden,update 区写得再对也不会被执行。
真正「硬件自动」的是红色那条失败边。配置控制器从 update 地址读数据时,先找同步字(sync word,比特流开头用于对齐的固定标识),随后逐帧做 CRC 校验;一旦同步字找不到、CRC 不匹配,或者配置过程中出现 IDCODE 不符等致命错误,控制器不等任何软件介入,自动放弃当前加载,按内置的回退地址(fallback / golden address)重新从 0 地址加载 golden。这一检测和跳转全部发生在配置阶段,应用逻辑此刻尚未存在,所以它不依赖镜像里的任何代码——这正是半份镜像、全错镜像也能救回来的原因。
把一次「成功的热重配」按信号展开,可以看到 DONE、INIT_B 和配置时钟的配合关系:
图中前六拍 golden 正在运行:CCLK 停振、INIT_B 与 DONE 均为高。第六拍 golden 写好热启动地址并触发内部重配置,DONE 与 INIT_B 相继拉低,配置 SRAM 被清空,CCLK 重新振荡,控制器改从 update 地址读入同步字与配置帧;CRC 通过后启动序列释放,DONE 重新拉高,新逻辑开始运行。整条波形与一次冷上电配置几乎相同,唯一区别是电源与 POR 没有发生——这也是「热启动」名字的由来。如果读入的是半份镜像,波形会停在校验阶段:同步字或 CRC 一旦报错,INIT_B 作为开漏状态脚被拉低报错,控制器自动把读指针切回 0 地址,再来一遍这样的加载,只是数据换成 golden。
fallback 的触发边界必须背下来,它决定了哪些「坏」真的能被救:
| update 区状态 | 配置硬件能否感知 | 是否自动回退 golden |
|---|---|---|
| 升级中断电,只写了一半 | 同步字缺失或帧长度/CRC 错 | 是 |
| 传输误码,个别位翻转 | 帧 CRC 不匹配 | 是 |
| 整区被擦空(全 0xFF) | 找不到合法同步字 | 是 |
| 比特流完整但目标器件型号不对 | IDCODE 校验失败(器件支持时) | 是 |
| 镜像完整、加载成功,运行后死锁 | 不能,配置阶段一切正常 | 否,需外部看门狗 |
| golden 自身被擦坏 | 不能,0 地址锚点已失 | 否,只能返厂 JTAG |
这张表也顺带解释了为什么 CRC 检查不能为了省时间而关掉:关掉校验等于亲手废掉红色回退边的触发条件,损坏镜像可能加载出一个行为随机的配置,比老老实实回退危险得多。
四、一次远程升级的完整流程
把前面的机制串成一次完整升级,参与方有三个:远端升级服务器、板上正在运行的 FPGA 逻辑(首次是 golden,之后通常是 update 自己)、以及板载 Flash。
- 收包与暂存:应用逻辑通过通信口接收新比特流,先放进片内 RAM 外配的 DDR 或直接流式缓存,边收边算整包 CRC,与升级包里附带的期望值比对。CRC 不过直接丢弃,绝不开始擦 Flash——这一步把绝大多数链路误码挡在 Flash 之前。
- 擦写 update 区:校验通过后,只对 update 区所在扇区发擦除命令,再逐页写入。写的过程中可以回读比对;任何一页失败就中止本次升级并报错,已写坏的 update 区留给下次覆盖,golden 与正在运行的当前逻辑都不受影响。
- 更新元数据:写好镜像长度、版本号、新的期望 CRC 与升级计数(元数据扇区的擦写要安排在内容写完之后)。
- 触发重配置:当前逻辑写热启动地址为 update 区并发出 IPROG(或拉低 PROGRAM_B 走一次外部重配置)。芯片清空配置 SRAM,从 update 地址加载,走第三节那条信号波形。
- 失败自动回退:新镜像 CRC 或同步字不过,硬件自动加载 golden;golden 读到元数据里的失败标记,知道上一跳没有成功,保持在 golden 运行并上报「升级失败、当前黄金版本」,等待重新推送。
- 成功后的新循环:新 update 正常上线后,下一次升级由它来写 update 区——注意永远是自己写另一个区,golden 区在整个产品生命周期里一次都不被空中擦除。
初学者常问:当前逻辑正在跑,擦 Flash 会不会擦掉正在执行的配置?不会。配置在启动时已全部搬入片内配置 SRAM,运行期 Flash 内容与正在运行的电路没有持续依赖;唯一不安全的时机是下次加载读到坏数据,而那正是双区布局兜底的时刻。
五、断电、半写、死循环:三类失败与兜底设计
机制讲完,工程上仍有三个经典的坑,每个都对应一条明确的设计纪律。
第一类:升级中断电。 双区布局已经回答了最危险的形态——半份 update 必然触发加载期回退。但要注意掉电也可能发生在元数据区擦写的瞬间:内容是新的、元数据是残缺的,或者相反。纪律是先写数据区、最后提交元数据,并且元数据用「魔数加 CRC」做成全有或全无的记录,golden 只承认完整记录。更稳的做法是元数据双副本加序号轮换(A/B 两份,取序号新且 CRC 正确的那份),任一扇区写到一半掉电都至少剩一份好记录。
第二类:半写与误码。 除了整包 CRC 与写后回读,地址对齐是这里的高发区:热启动地址的字节与字单位写错一位,控制器跳到一个错位地址,读到的全是垃圾。这类问题在实验室就会暴露,纪律是把分区地址、扇区边界、地址单位三项在 golden 工程里做成常量并评审,排错速查可对照这篇现场记录:FPGA 多重启动回退失败排查。
第三类:回退死循环,这是双区设计独有的新风险。 update 配置成功但运行后很快死锁,外部看门狗超时拉低 PROGRAM_B,golden 起来后又老老实实跳 update,update 又死——设备以几十秒为周期无限重启,永远停不到能通信的版本。更隐蔽的变体是镜像完好但与现场环境不兼容,每次都「成功运行」几分钟才崩。硬件 fallback 对此毫无责任能力,因为它眼里配置全程合法。
兜底靠两条软件纪律。其一,golden 限制重试:借助元数据区的升级计数,若检测到连续 N 次「刚跳走又回到 golden」,就判定 update 不可信,本轮停在 golden 并主动上报,把「自动试新」退化为「明确守旧」。其二,外部看门狗守护运行期:独立看门狗芯片监控喂狗信号,update 死锁无法喂狗时经 PROGRAM_B 强制重配,用法见 看门狗定时器工作原理。硬件 fallback 管「加载得起来吗」,看门狗加计数管「跑起来之后活得好吗」,两段合起来才覆盖全部失败面。
六、选型检查清单:哪些配置口与器件支持热启动多引导
multiboot 不是任意配置组合都能用,画板子前按下表逐项确认,别等板子回来才发现跳转命令无处可发。
| 检查项 | 要求 | 不满足时的后果 |
|---|---|---|
| 配置接口支持多引导 | 主 SPI/BPI 等器件主动读 Flash 的模式支持热启动地址与回退;纯从模式需外部主机配合重新送流 | 无法让芯片自主换地址启动 |
| Flash 容量够双区 | 容量 ≥ 两份镜像加元数据,且两区间隔整扇区 | 只能单区,退回变砖风险 |
| golden 工程使能多引导 | 比特流属性打开 MultiBoot/回退、CRC 保持开启、嵌入正确跳转命令与地址 | 上电永停 golden 或不回退 |
| 地址格式与手册一致 | update 起始地址的单位(字节/字)、对齐粒度符合配置指南 | 跳到错位地址,必回退 |
| 回退地址正确 | fallback 指向 0 地址 golden | 失败后无镜像可回 |
| 运行期看护 | 板上有独立看门狗并接到 PROGRAM_B/复位链路 | 加载成功但跑死时无法自救 |
| 元数据与重试策略 | 有版本、CRC、升级计数与「连败 N 次停 golden」逻辑 | 回退死循环或无法远程判断现场版本 |
| 生产烧录隔离 | 产线能单独烧 golden 且售后流程禁止擦除低地址扇区 | 售后操作误擦 golden,锚点永久丢失 |
各家厂商的术语差异在选型时也要对上:Xilinx 文档里是 MultiBoot、IPROG、WBSTAR 与 fallback;Intel(Altera)的远程更新用 remote system upgrade/ASMI 类 IP 与重新配置地址寄存器表达同一模型;Lattice 等家族也有各自的热启动原语。思路完全一致——默认地址放不可动的黄金镜像,可升级镜像放高地址,加载失败硬件自动回退——但寄存器名、地址粒度、使能比特各不相同,工程实现一律以目标器件家族的配置用户指南为准。若你的应用还要求镜像防抄板、防回读,双区可以与比特流加密叠加,密钥烧录与密文镜像的细节见同批的比特流加密一文(发布后可在 FPGA 入门目录检索「比特流加密」)。
这一篇在知识体系里的位置
本篇属于 FPGA 配置机制簇,回答的是「配置地址可变与失败换址」这一个机制点。通道由谁发时钟、数据走哪几根脚,读 FPGA 配置方式有哪几种;一次冷上电从电源爬升到 DONE 拉高的完整时间轴,读 FPGA 上电配置时序;Vivado 里点按钮完成 JTAG 下载与 Flash 固化的操作步骤,读 FPGA 入门 32:比特流下载与固化。线上真实事故的寄存器级排查(WBSTAR 写错、同步字与 CRC 设置、RS 引脚配合),读 FPGA 多重启动回退失败排查;multiboot 与「不重启、运行中换一部分逻辑」的区别,读 FPGA 局部重配置入门;运行期失败兜底的独立器件原理,读 看门狗定时器工作原理。
总结
FPGA 在线升级与 multiboot 的核心不是「怎么把新镜像写进 Flash」,而是「承认写 Flash 一定会失败,然后让失败无害」:把 Flash 划成出厂只烧一次、永不空中擦除的 golden 黄金区和专供在线改写的 update 区,上电先无条件加载 0 地址的 golden,由 golden 写热启动地址寄存器(WBSTAR)并触发 IPROG 热启动跳到 update;配置控制器在同步字或 CRC 失败时硬件自动回退 golden,把半写、断电、误码的后果从变砖降级为一次自动回退;而加载成功后的运行期死机硬件管不着,必须用外部看门狗加升级计数补完,并用「连败 N 次停 golden」切断回退死循环。