CTS buffer 选型:时钟树 buffer 与反相器对的上升下降均衡、功耗与延迟取舍
更新时间:2026-10-02。时钟树综合(CTS)是后端流程里最「吃单元」的一步:一颗中等规模芯片的时钟树上能挂着几千到几万个缓冲单元,它们直接决定 clock latency、skew、功耗这三大指标。本站 CTS 时钟树综合 讲了树的整体构建流程,useful skew 与 CTS 优化 讲了偏斜的主动利用,clock latency 之源与网络延迟 讲了延迟的分解。这一篇聚焦到构成树的砖块本身:CTS buffer 选型到底在选什么——为什么有的工艺库鼓励用反相器对而不是 buffer,为什么时钟单元要单独做一套「上升下降均衡」的版本,驱动强度、面积、功耗之间怎么权衡。看懂这些,你在 CTS 约束里写下的那个 clock cell list 才不是拍脑袋。
本文要回答的问题
- 时钟树为什么不能用普通信号线 buffer,时钟专用单元多了哪些设计?
- buffer 和反相器对(inverter pair)在电气行为上有什么本质差异,各自适合什么场景?
- 「上升下降均衡」是什么,为什么它对时钟树比对数据路径重要得多?
- 驱动强度、延迟、功耗、面积之间的取舍关系长什么样,选型时先定哪个维度?
- CTS 工具约束里的 clock cell list 怎么配,常见踩坑有哪些?
一、为什么时钟树需要「专用」单元
先明确一个前提:时钟网络和数据网络对单元的要求完全不同。数据路径上的缓冲器只关心「把这个逻辑值尽快送过去」,上升慢一点还是下降慢一点,STA 工具会分别按 rise/fall 弧查表,最坏情况兜底即可。时钟不一样——时钟的上升沿和下降沿都可能是有效沿:双沿触发器、负沿触发器、DDR 接口、时钟门控单元的内部锁存结构,都会用到下降沿。更关键的是 duty cycle(占空比):时钟沿树一级级往下传,每一级单元的 rise 延迟和 fall 延迟只要有一点点不等,占空比失真就会逐级累积,传到叶子端时 50% 的占空比可能已经漂到 45% 或 55%,半周期路径的时序预算直接被啃掉一块。
所以时钟单元库的第一条设计纪律是 rise/fall 均衡:单元的上升延迟和下降延迟要在全工艺角、全输入 transition、全负载范围内尽量相等。这件事在晶体管层面并不容易——CMOS 天然不对称,PMOS 的空穴迁移率大约是 NMOS 电子迁移率的二分之一到三分之一,要让上拉下拉速度相等,PMOS 宽度就得做到 NMOS 的两到三倍,版图面积和输入电容都会变大。时钟专用单元就是「愿意为均衡付出面积」的那批单元。
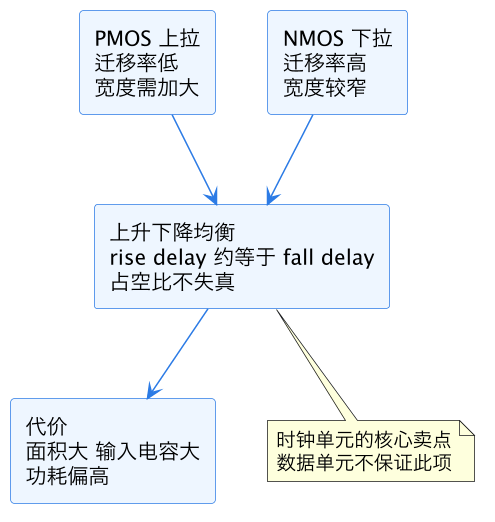
这张图说的是时钟单元的「第一性原理」:均衡不是免费特性,是用硅面积和功耗换来的。这也解释了为什么标准单元库里的普通 buffer(比如 BUF_X2)不应该随手拿来插时钟树——它的 P/N 尺寸比通常按面积最优而非均衡最优设计,rise/fall 延迟差可能达到标称延迟的 10% 到 20%,插十几级之后占空比就没法看了。
第二条纪律是抗偏差(variation tolerance)。时钟树是全网最在乎 OCV 的结构:launch 路径和 capture 路径的延迟差直接构成 skew 悲观度。时钟单元因此倾向用较大的沟道长度、更规则的版图,把随机掺杂涨落引起的延迟散布压小,LVF/SOCV 统计时序背景下这一点的量化方法见 LVF/SOCV 统计时序。第三条纪律是 slew 控制能力:时钟单元在不同负载下的输出 transition 要平缓可控,因为下游单元的延迟对输入 slew 敏感,skew 的一半来源其实是 slew 不匹配。
二、buffer 与反相器对:两种砖块的电气性格
时钟树的缓冲单元有两个流派。一派是 clock buffer:两级反相器串联,输入输出同相,结构上就是「一个反相器驱动一个更大的反相器」。另一派是 clock inverter 加反相器对的用法:树上每一级用单个反相器,极性交替,工具在构建树时保证任何一段对称分支上的反相器级数奇偶一致,到达叶子端的总体极性正确。
两者电气性格差异很大。单个反相器是 CMOS 里最快、最省的基本单元:一级逻辑、延迟最小、功耗最低,而且天然更容易做均衡——只有一个上拉路径和一个下拉路径,P/N 尺寸比调好就均衡了。buffer 是两级,第一级小第二级大,延迟天然比单反相器大(同驱动能力下通常大 50% 到 100%),功耗也更高,但它有两个反相器给不了的优点:输入输出同相让树的构建和 ECO 简单(不用担心极性翻转改变逻辑),以及输入电容小、驱动能力强——buffer 的第二级可以做得很大而第一级保持很小的输入负载,扇出能力远超同等输入电容的反相器。
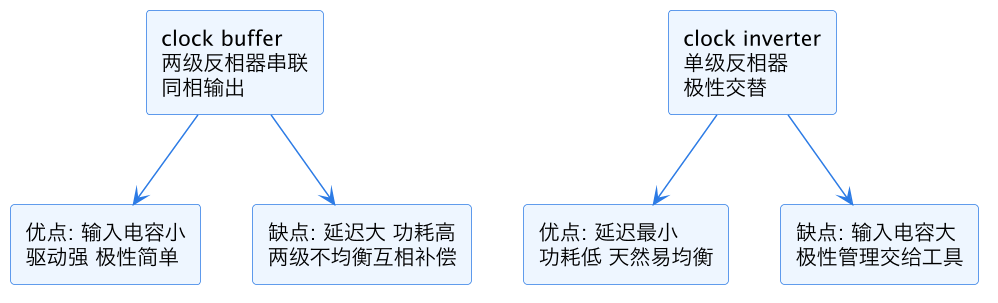
这张对比图的核心信息是:反相器赢在「每级性能」,buffer 赢在「驱动效率与工程简单」。什么时候哪个赢?看树的形态。树的总延迟大致等于级数乘以每级延迟,而级数由「每一级能驱动多大负载」决定——扇出规则(比如每级驱动 3 到 4 倍自身输入电容)是固定的,从树根到叶子的总电容比决定了级数下限。在这个约束下:反相器每级延迟低但输入电容大、单级驱动能力弱,往往级数更多;buffer 每级延迟高但级数可能更少。实际库里做选型实验时你会发现一个常见结论:在深树(十几级以上)里,精心均衡的反相器链总延迟和总功耗通常优于 buffer 链,这就是为什么先进工艺的 CTS 越来越倾向 inverter-based 时钟树。
但反相器方案有一个隐性门槛:rise/fall 均衡的要求更高。buffer 的两级结构有「误差互补」的余地——第一级偏快上升,第二级可以调得偏快下降,整体均衡比单级好调;反相器链每一级都是独立暴露的,任何一级的 P/N 失衡直接体现在占空比上。所以用反相器的前提是库里有真正均衡过的 clock inverter,而不是把普通 INV_X1 拉来凑数。另外反相器单级输入电容大,源端(时钟根或门控单元)驱动它时 transition 容易变缓,需要在树顶几级特殊处理。
| 维度 | clock buffer | clock inverter / 反相器对 |
|---|---|---|
| 单级延迟 | 较大(两级) | 最小(单级) |
| 静态加动态功耗 | 高 | 低 |
| 输入电容 | 小,对上游友好 | 大,树顶需特殊处理 |
| 均衡实现 | 两级互补可调 | 靠单级 P/N 比硬调 |
| 极性管理 | 无需关心 | 工具须保证分支奇偶一致 |
| 适用场景 | 中小规模设计、mesh 前级、ECO 友好 | 先进工艺深树、功耗敏感设计 |
上表是选型时的第一参照系。注意「反相器对」这个提法的由来:很多流程为了回避极性问题,以两级反相器为一个逻辑单元(等效一个 buffer)来规划树,但物理上仍按两个独立反相器摆放——这样既拿到反相器的性能,又把极性管理简化成「以对为单位」。CTS 工具对 clock inverter 的支持成熟度不同,老流程只接受 buffer 列表,配约束前先确认工具版本。
三、上升下降均衡:物理来源与度量
上一节反复提到「均衡」,这一节把它量化。定义很简单:一个单元的 rise 延迟(输入下降、输出上升)与 fall 延迟之差,除以标称延迟,就是均衡度。时钟单元的目标通常是把全角点范围内的不均衡压到 5% 以内,优秀的库单元能到 2%。
不均衡的物理来源有三层。第一层是迁移率差异,P/N 宽度比按标称工艺角调好 2.5:1 左右能均衡,但这个比值随工艺角漂移——FF 角 NMOS 快得比 PMOS 多,SS 角反过来,单一尺寸比不可能全角点均衡,库设计者只能选折中点并把残余不均衡写进库表。第二层是输入 slew 相关性:慢输入下上拉下拉不对称被放大,所以均衡指标必须在库表的全部 transition 索引点上都成立,而不是只挑典型点。第三层是版图环境:时钟单元两侧的填充单元、阱接触距离、上层走线都会微调寄生,这就是为什么 CTS 阶段对时钟单元常有 placement halo 和 NDR(非默认布线规则)保护,NDR 与时钟屏蔽规则 专门讲布线侧的手段。
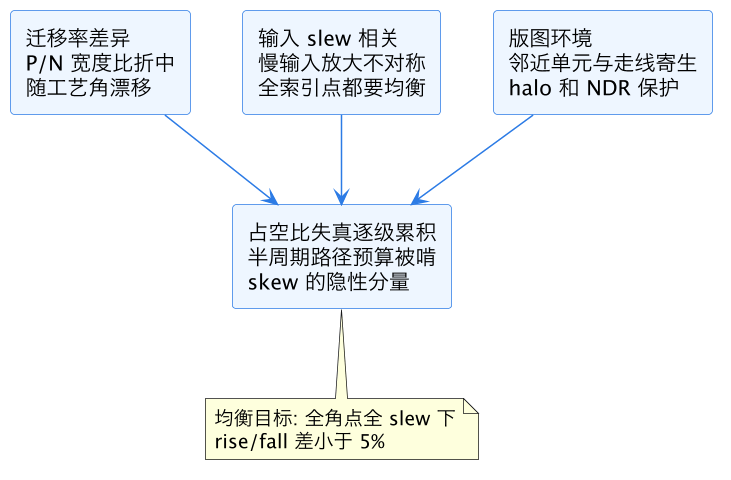
这张图把三个来源汇到同一个后果上:占空比失真加 skew。工程度量上有两个实用做法。一是看库报告里的 rise/fall 延迟比值表,按你最差角点、最差 transition 点取数,别用典型值自欺。二是 CTS 后看时钟树报告里的 half-cycle path 裕量——很多设计 setup 全过但半周期检查(比如负沿到正沿的路径)紧巴巴,根因就是树上某一段用了不均衡的单元。修复手段是换均衡更好的单元或在该段插一级反相器对做「极性翻修」,后者恰好是反相器方案的隐藏福利:两级反相器各自的不均衡方向可以刻意配对,让它们互相抵消。
还有一个和均衡纠缠在一起的指标是 pulse width(最小脉宽)。时钟沿树传下去,不均衡让高电平脉宽和矮电平脉宽一个变宽一个变窄,窄的那个可能跌破触发器的最小脉宽约束。这类违例在 STA 报告里归到 min pulse width check,出现时第一反应应该是回看时钟树的单元均衡性,而不是去改触发器。
四、驱动强度、延迟、功耗、面积的四维权衡
选定 buffer 还是反相器之后,第二个问题是驱动强度档位。时钟单元库通常给一个家族(比如 CLKBUF 或 CLKINV)从 X1 到 X20 甚至更高的驱动梯度。选型的四个维度互相牵制:
延迟维度上,大驱动单元自身延迟低、驱动线网后 slew 好,能减少总级数;但大单元输入电容大,把负担推给上一级。功耗维度上,时钟网络是全芯片动态功耗大户(常占总功耗 30% 到 40%),每一级单元的充放电功耗与其内部电容成正比,驱动翻一倍功耗大致翻一倍——所以「全程用最大驱动怼平 skew」的方案在功耗上是灾难。面积维度相对温和,时钟树总面积通常占芯片几个百分点,但大驱动单元的宽度可能超出行高整数倍的布局格子,造成局部利用率空洞。抗偏差维度上有个反直觉点:更大的单元 RDF 散布更小(沟道面积大,原子涨落被平均),所以对 skew 的贡献反而小——这是「树顶用大单元、树底用小单元」这一常见策略的依据之一。
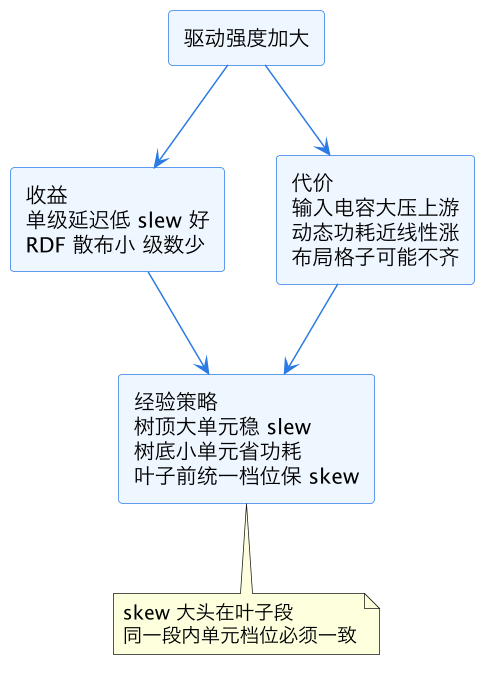
这张图的注记是实战里最有用的一条规则:skew 主要不是在树顶产生的,而是在叶子段产生的——到达不同触发器的最后几级如果用了不同驱动的单元、驱动着不同的局部负载,延迟差就直接变成 skew。所以 CTS 约束里通常规定叶子段只能用一到两个固定档位,树顶和自由段才放开梯度让工具优化延迟和功耗。
功耗侧还有一个结构性手段要提:clock gating(时钟门控)和单元选型是正交但互相影响的两件事,门控单元的 setup 检查对它前面的时钟缓冲级数敏感,clock gating 的 STA 检查 和 clock gating 功耗收益 两篇分别讲了时序和功耗两侧。选型时的配合点是:门控单元之后的子树(gated domain)可以用和主树不同的单元策略,因为门控关断时子树不翻转,功耗压力小,可以选延迟更优的档位换 skew。
五、实战:clock cell list 怎么配,坑在哪里
CTS 工具的选型接口通常就是一份 clock cell list:约束里写明「树顶段允许用哪些、干线段允许用哪些、叶子段允许用哪些」,工具在列表内做优化。配这份列表的实战步骤可以归纳为四步。
第一步,筛库。从工艺库提供的 clock 单元家族里,按第三节的均衡指标(全角点全 slew 下 rise/fall 差)筛掉不及格的,再按 LVF sigma 数据筛掉散布大的。这一步强烈建议自己跑一个小实验:用候选单元各搭一条五级链,在每个签核角点下仿真总延迟、rise/fall 差和功耗,表格化对比——库文档的标称数字经常是挑好看的条件给的。库的整体背景见 标准单元 PDK 库视图 和 Liberty 特征化流程。
第二步,分段定档。树顶到第一级分叉用大驱动(压 slew、压散布),干线中段用中等档位(延迟功耗平衡),叶子段锁死一到两个档位(保 skew)。每个段给工具的列表最好只含 2 到 4 个候选,给得太多工具优化空间发散,CTS 时间和结果稳定性都变差。
第三步,定 buffer/inverter 策略。确认 CTS 引擎对反相器的支持等级:有的工具要求显式开启 inverter-based CTS,有的要求 inverter 必须成对出现在列表里。先进工艺低功耗设计优先 inverter;设计里大量用半周期路径或第三方硬核(硬核内部时钟极性假设要核实)时,buffer 方案省心。
第四步,CTS 后验证三件事:skew report 达标只是及格线;half-cycle 和 min pulse width 检查要全过;时钟树功耗占比要和预算对账(超了优先砍树顶驱动档位,而不是砍叶子段——叶子段一动 skew 就崩)。
常见坑列四个。其一,把普通 BUF/INV 混进 clock list:均衡没保证,占空比慢性失血,硅后很难查。其二,叶子段档位不锁:工具为了修 transition 在个别叶子上用大驱动单元,局部 skew 爆掉。其三,忽略门控单元之后的子树极性:inverter-based 树里门控后第一级如果是反相器,整个子树的时钟极性翻转,负沿逻辑全错——工具的极性检查必须开。其四,ECO 阶段随手插 buffer 修 hold:插进时钟网络会破坏极性和均衡,时钟路径上的 ECO 只能用 clock 单元家族,PR 时序收敛 ECO 的纪律在时钟侧要加这一层。
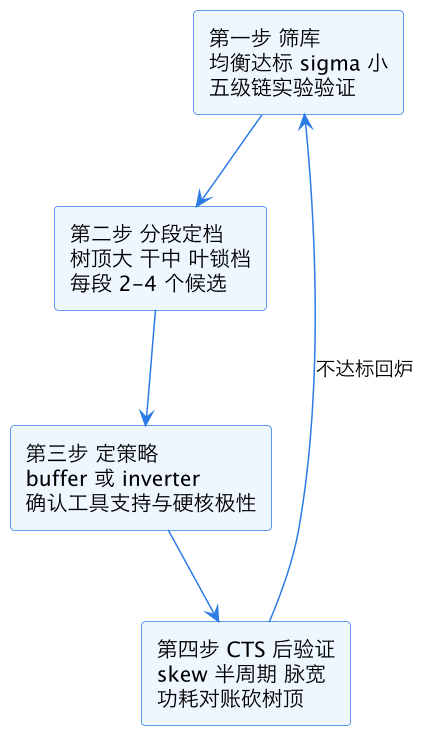
这张流程图是全篇的操作主线。注意回路:验证不过要回到对应的步骤改,而不是一味在 CTS 约束里加悲观度——clock uncertainty 加得越多,STA clock uncertainty 与 jitter 那篇讲过的时序预算代价越大,能用单元选型解决的结构性问题就不要用裕量去糊。
这一篇在知识体系里的位置
本篇是 eda/ 目录时钟线的一篇 S 级标准文,向上承接 CTS 时钟树综合 的构建流程与 数据流 S4 CTS 与布线 的阶段视角,聚焦到树的「砖块」选型这个被整体流程文一笔带过的话题。横向关联:useful skew 与 CTS 优化 讲 skew 的主动利用,本篇讲 skew 的单元级来源;clock latency 之源与网络延迟 讲延迟分解,本篇讲构成延迟的单元特性;NDR 与时钟屏蔽规则 讲布线侧保护,本篇讲单元侧素质。库侧背景见 标准单元 PDK 库视图、Liberty 特征化流程、Liberty NLDM 与 CCS 时序模型;统计偏差视角延伸到 LVF/SOCV 统计时序;结构对比类读者可看 clock mesh 与 tree 混合结构。后续落地接 PR 时序收敛 ECO 和 Signoff STA 与 PrimeTime。
总结
CTS buffer 选型是在均衡、延迟、功耗、面积四个维度上为时钟树挑砖块:时钟单元必须全角点全 slew 下保持上升下降均衡以守住占空比,反相器以最低延迟和功耗赢得先进工艺深树、buffer 以小输入电容和极性简单赢得工程便利,驱动强度按「树顶大、叶段锁档」分配,最终通过一份分段受限的 clock cell list 交给工具,并用 skew、半周期、脉宽、功耗四项验证闭环——单元选型能解决的结构性问题,绝不用 clock uncertainty 裕量去糊。