CSV 驱动 testbench:用表格文件驱动 UVM 环境配置与场景参数的回归矩阵解耦实践
更新时间:2026-10-04。每个验证项目做到中期都会撞上同一堵墙:环境里的可调旋钮(agent 使能、速率、时延分布、错误注入率、覆盖率目标)越攒越多,它们散落在 test 类的
build_phase、sequence 的约束块、还有启动脚本的+define+里。想加一个回归维度,要改代码重新编译;想复现某次失败,得翻半天才能拼出当时的配置组合。站内的 SystemVerilog plusargs 配置 和 UVM 命令行 plusargs 解决了「命令行传参进仿真」这一层,但 plusargs 只适合旋钮数量个位数的场景——旋钮上百个、回归矩阵几千行时,命令行会膨胀成不可维护的怪物。CSV 驱动 testbench 是这一层的解法:把所有旋钮抽到一张表格文件里,一行一个配置组合,仿真启动时解析入 config_db,回归脚本按行派发。这一篇讲清这套做法的建模方法、落地代码、解耦收益和那些踩过的坑。
本文要回答的问题
- CSV 驱动 testbench 到底解决什么问题,它和 plusargs、config_db 各自的边界在哪?
- 环境旋钮怎么建模成 CSV 的列,哪些旋钮适合进表、哪些坚决不该进?
- CSV 怎么在仿真启动时解析并注入 config_db,解析代码长什么样?
- 「回归矩阵与激励生成解耦」具体怎么解,解完收益在哪?
- 这套机制有哪些必须提前堵住的坑(schema 漂移、类型错误、组合爆炸)?
一、为什么需要 CSV 驱动:plusargs 的天花板
先把问题说清楚。UVM 环境里的配置传递有三层机制,各管一段,谁也别越界。
最底层是 plusargs,命令行传 +BURST_LEN=16 +ERR_RATE=5,testbench 里 $value$plusargs 接住。它的问题是「三无」:无类型(全是字符串,解析靠自觉)、无结构(平铺的键值对,上百个旋钮时命令行超过一行能读的极限)、无默认值管理(脚本里漏传一个,行为静默退化)。UVM 命令行 plusargs 讲的覆盖优先级纪律在这层仍然适用,但当旋钮数量过了二十个,plusargs 本身就成了新的混乱源。
中间层是 config_db / 配置对象,test 在 build_phase 里 uvm_config_db#(env_cfg)::set(...),env 和各 agent 在 get。UVM 配置对象与 resource_db 讲了这套机制的细节。它是旋钮的「运输层」,但不解决「旋钮从哪来」——传统写法是值硬编码在 test 类里,每个 test 类就是一份冻结的配置快照,加一个维度就要派生一个新 test 类,UVM test 库组织 里说的 test 类爆炸就是这么来的。
CSV 驱动坐在最上面:旋钮的取值从代码里抽走,放进一张受版本控制的表格文件。仿真启动时,一个通用的解析器读指定行,把每个字段按声明的类型注入 config_db;回归脚本不再枚举「test 类名」,而是枚举「CSV 行号」。test 类从几百个塌缩成几个(按验证目标分,不按参数组合分),参数组合的全部自由度交给表格。
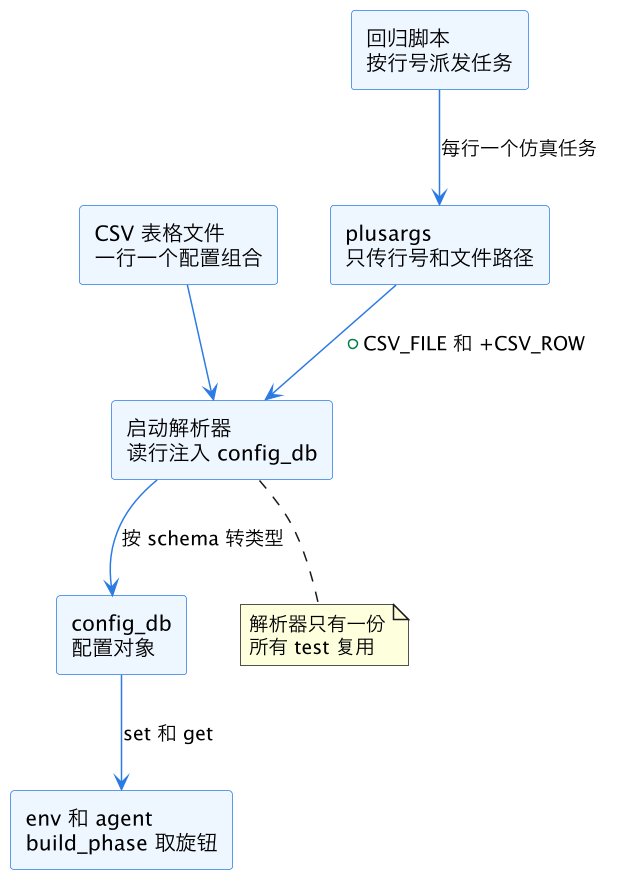
上图是 CSV 驱动 testbench 的数据流骨架:回归脚本按行号派发,plusargs 只承担「告诉仿真读哪个文件哪一行」这一件事,解析器把表格字段转成类型正确的配置对象塞进 config_db,环境组件照常 get。注意箭头方向——配置的唯一来源是 CSV,代码里不再出现任何字面量旋钮值,这是整套机制成立的前提。
二、旋钮建模:哪些列该进表,哪些不该
不是什么都适合塞进 CSV。进表前先过一道筛子,标准是「这个旋钮的变化是否需要覆盖回归矩阵的一个维度」。
该进表的是场景自由度:协议参数(burst 长度、outstanding 深度、速率档位)、激励分布权重(读多写少还是写多读少、错误注入率)、环境形态(active/passive、使能哪些 agent、virtual sequence 选哪条主线)、覆盖率相关阈值(at_least 目标、非法 bin 是否豁免)。这类旋钮的特征是——回归就是想扫它们的不同取值组合。
不该进表的有三类。一是编译期决定的东西:+define+ 宏、接口宽度参数、DUT 顶层 parameter,它们改动就要重编译,运行时注入无意义,应该留在编译脚本层。二是每次仿真都必须唯一的东西:seed。seed 由回归系统派发(LSF 网格回归 讲了派发细节),写进 CSV 等于冻结随机性,把回归变成了定向测试。三是路径类环境差异:波形 dump 路径、log 目录,这类属于运行环境而非验证意图,交给脚本。
一个常见的纠结是「默认值」放哪。纪律是:CSV 里每一列都必须有值,不允许空单元格;真正想表达「用默认」时,在 schema 里定义一个哨兵值(比如 default 关键字),解析器见到它就走内置默认。空单元格在团队协作里是个灾难——没人说得清那是「忘了填」还是「故意留空」。
| 旋钮类别 | 例子 | 归宿 |
|---|---|---|
| 场景自由度 | burst_len、err_rate、agent 使能 | CSV 列 |
| 编译期参数 | 接口宽度、功能宏 | 编译脚本 +define+ |
| 随机种子 | seed | 回归系统派发 |
| 运行环境 | dump 路径、log 目录 | 启动脚本 |
| 测试身份 | csv_file、csv_row、test 名 | plusargs |
三、落地实现:从 CSV 行到 config_db
实现上分三块:schema 声明、解析器、env 侧取值。核心思想是「schema 先行」——每一列的名字、类型、合法范围、默认值,全部在一份 SystemVerilog 结构里声明,CSV 只是这份 schema 的实例数据。
// schema:列声明集中在一处
class env_knob_schema;
  // 列名、类型、范围、默认值
  typedef struct {
    string name;
    string dtype;   // "int" "string" "real" "bool" "enum"
    string min_val, max_val;
    string dflt;
  } knob_decl_t;

  static knob_decl_t decls[$] = '{
    '{"burst_len",   "int",   "1",   "256",  "16"},
    '{"outstanding", "int",   "1",   "32",   "8"},
    '{"err_rate",    "real",  "0.0", "10.0", "0.0"},
    '{"rd_wr_ratio", "int",   "0",   "100",  "50"},
    '{"slave_agent", "bool",  "",    "",     "1"},
    '{"main_vseq",   "string","","",     "smoke"}
  };
endclass
解析器读 +CSV_FILE= 和 +CSV_ROW= 两个 plusargs,打开文件,跳过表头,定位到目标行,按逗号切分(字段里允许引号包裹的字符串),然后逐列对照 schema 做三件事:类型转换、范围检查、注入 config_db。任何一步失败都 uvm_fatal——配置错误必须在仿真第 0 时刻炸掉,绝不允许带着错误配置跑两小时再给你一个莫名其妙的失败。
function void csv_loader::load_and_set(uvm_component ctxt);
  string file; int row;
  void'($value$plusargs("CSV_FILE=%s", file));
  void'($value$plusargs("CSV_ROW=%d", row));
  fields = parse_row(file, row);          // 读行并按 schema 对齐
  foreach (env_knob_schema::decls[i]) begin
    knob_decl_t d = env_knob_schema::decls[i];
    string raw = fields.exists(d.name) ? fields[d.name] : d.dflt;
    if (raw == "default") raw = d.dflt;
    check_range(d, raw);                  // 越界直接 fatal
    case (d.dtype)
      "int":    uvm_config_db#(int)::set(ctxt, "*", d.name, raw.atoi());
      "real":   uvm_config_db#(real)::set(ctxt, "*", d.name, raw.atoreal());
      "string": uvm_config_db#(string)::set(ctxt, "*", d.name, raw);
      "bool":   uvm_config_db#(bit)::set(ctxt, "*", d.name, raw.atoi());
    endcase
  endfunction
env 侧的取值代码和常规 config_db 用法完全一样,test 类的 build_phase 顶部调一次 csv_loader::load_and_set(this) 就完事——所有 test 共享同一套旋钮,区别只在它们选择的验证目标(UVM test 库组织 里「test 按意图分类而非按参数分类」的原则由此真正落地)。
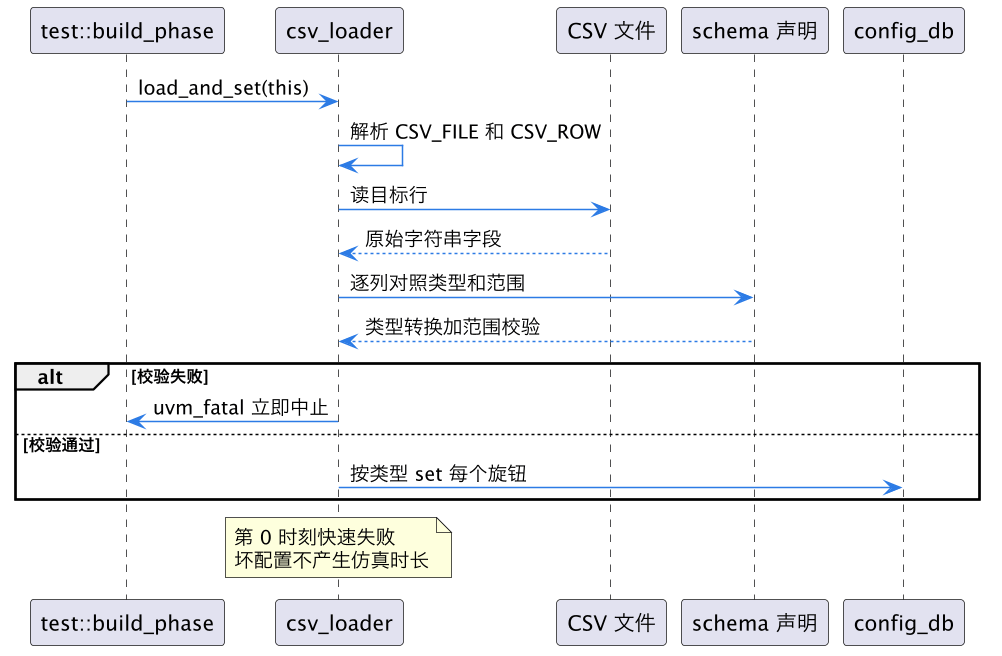
这段时序的关键是 alt 分支:校验失败走 uvm_fatal,仿真在 elab 之前死掉,而不是消耗机时。回归网格上几千个任务并发时,一个坏配置行如果没被快速拦截,会污染整批结果的分诊——回归失败分桶 最怕的就是混入「配置错误」这种本不该发生的桶。
四、解耦的收益:回归矩阵和激励生成各走各路
CSV 驱动最大的架构收益,是把「回归要跑哪些场景」和「场景怎么生成激励」拆成两个可独立演化的工件。
解耦之前,回归矩阵活在测试工程师的脑子里和 Makefile 的目标列表里,激励参数活在 test 类和 sequence 约束里,两边通过「test 类名」这个脆弱的契约绑定。改激励约束可能影响一批 test 的行为而回归方毫不知情;加一个回归维度要动代码、重新编译、改脚本三处。
解耦之后,回归矩阵就是那张 CSV 本身——它是数据,可以被脚本 diff、被评审、被覆盖率系统反向生成(哪些组合没覆盖就往表里追加行)。激励生成只认 config_db 里的旋钮,不关心这一行是谁派发的、属于哪个 milestone。两边各自的变更互不打扰:算法工程师改 sequence 的时延分布模型,回归矩阵一行不动;验证经理往矩阵里加两百行新组合,代码一行不改、不需要重编译。
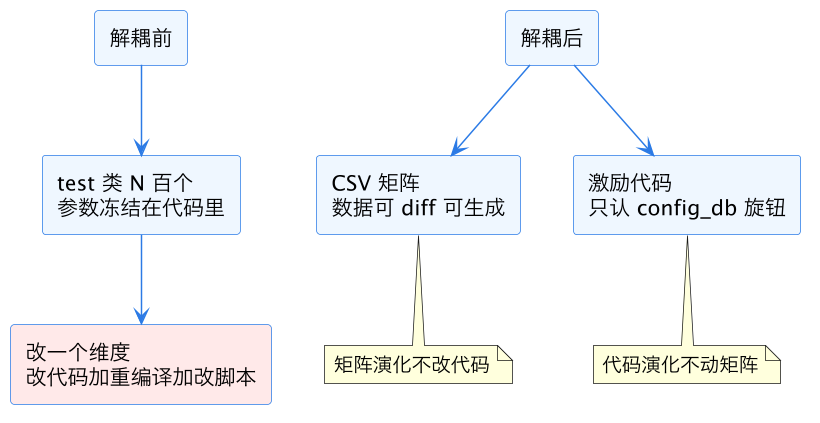
这张对比图里左右两半唯一的共同点是中间那条看不见的契约——config_db 的旋钮 schema。schema 是两边唯一的耦合点,所以它的稳定性要用纪律保证:列只能新增、不改名、不删除(废弃列保留并标注,解析器忽略),这条纪律和 覆盖率合并与排除流程 里对豁免项「只增审计不改历史」的原则是同一种思维——矩阵是回归的历史记录,历史不可改写。
还有一层收益常被忽视:失败复现的确定性。传统模式下复现一次回归失败要凑齐 test 名、若干 plusargs、seed;CSV 模式下复现命令就是「同一个文件、同一行、同一个 seed」,回归报告里直接记录三元组(file、row、seed),一行信息完整刻画一次仿真的全部输入,回归管理方法学 里要求的可追溯性天然达成。
五、坑与纪律:schema 漂移、类型错误、组合爆炸
这套机制用起来爽,坑也都实打实踩过,列四个必须提前堵的。
坑一,schema 漂移。有人在 CSV 里加了一列但忘了在 schema 里声明,解析器静默忽略,该旋钮永远吃默认值——回归跑了一个月,那一列的所有取值实际上从未生效过,和 形式验证 vacuity 调试 里的假收敛是同一类「看着在验证实际没验证」的事故。堵法:解析器做双向检查,schema 有的列 CSV 必须有,CSV 有的列 schema 必须认,任何一边多出字段都 fatal;再加一个 --list-knobs 模式,仿真启动时把实际生效的旋钮全量打印进 log,分诊时第一眼就能核对。
坑二,类型与格式。CSV 本质是文本,1,000 这种千分位、全角逗号、行尾 \r(Windows 编辑过的文件)都会让切分出诡异的字段。堵法:解析器统一做 trim 和 \r 剥除,数字字段严格用正则校验格式,字符串字段禁止内嵌逗号(要内嵌就换分隔约定或用枚举值代替自由文本)。更进一步,团队约定 CSV 只用脚本生成或经 lint 工具检查后入库,人肉编辑必须过 CI 的 schema 校验。
坑三,组合爆炸。旋钮二十个、每个三档,全组合是三的二十次方——三十多亿行,谁也跑不完。CSV 驱动让「加行」变得零成本,反而容易诱发不加思考的笛卡尔积枚举。堵法:矩阵生成用 Pairwise 之类的组合缩减算法(站外工具如 pict 都支持直接输出 CSV),核心列全组合、外围列成对覆盖;同时给每行挂一个「优先级」列,机时紧张时按优先级截断,回归管理方法学 里的分级回归策略在这里直接映射成按列过滤。
坑四,枚举值拼写。main_vseq 这类字符串旋钮,表里写 smoek 和代码里的枚举对不上,行为取决于 env 侧的兜底写法——兜底写成「不认识就用默认」就是又一次静默退化。堵法:字符串旋钮在 schema 里挂合法值列表,解析器逐一核对,拼写错误第 0 时刻 fatal。
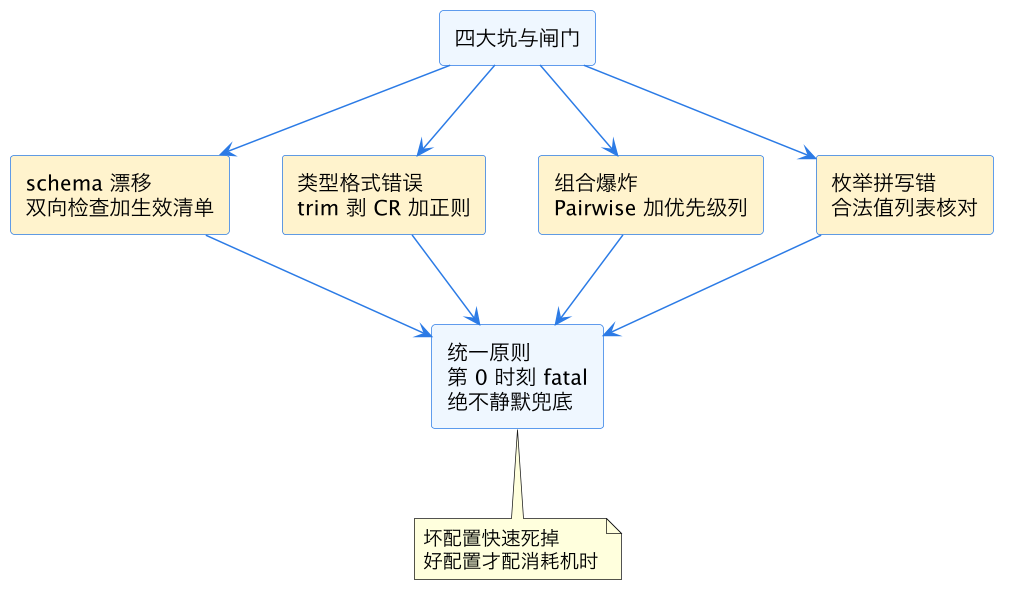
四个坑收敛到同一条总原则:任何配置层面的问题,都必须在仿真消耗机时之前变成显式失败。静默兜底是 CSV 驱动机制的头号敌人——机制的初衷是让配置变成可审计的数据,静默兜底会把数据重新变回不可审计的玄学。把这条原则写进解析器的每一行分支,这套机制就能从「能用的技巧」升级成「敢签核的基础设施」。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 环境构建线的一篇 S 层深文,主关键词 CSV 驱动 testbench。向上承接 SystemVerilog plusargs 配置 与 UVM 命令行 plusargs——那两篇解决「参数怎么进仿真」,本篇解决「参数规模爆炸后怎么治理」,plusargs 在本方案里退化为只传 CSV 文件路径与行号的引导层。横向与 UVM 配置对象与 resource_db(config_db 运输层机制)、UVM test 库组织(test 按意图而非参数分类)互为支撑——本文的解析器产出正是 config_db 配置对象,而解耦后 test 库才能真正按意图组织。向下衔接 回归管理方法学 与 LSF 网格回归:CSV 矩阵是回归系统的输入数据源,(file、row、seed)三元组是派发与复现的最小单元;失败侧的 回归失败分桶 则依赖本文「配置错误第 0 时刻 fatal」的纪律,保证配置类问题不混入设计缺陷的分诊队列。
总结
CSV 驱动 testbench 的核心是把环境旋钮从代码抽到受版本控制的表格文件、仿真启动时由统一解析器按 schema 校验类型与范围后注入 config_db,让回归矩阵变成可 diff、可评审、可由覆盖率反向生成的纯数据,从而实现「回归要跑什么」与「激励怎么生成」的彻底解耦——plusargs 退化为只传文件路径与行号,test 类按验证意图而非参数组合组织,(file、row、seed)三元组完整刻画一次仿真;而整套机制成立的红线只有一条:schema 双向检查、格式严格校验、枚举值核对全部第 0 时刻 fatal,任何配置问题都绝不允许静默兜底——坏配置快速死掉,好配置才配消耗回归机时。