Manchester、NRZI:让数据流自己带着节拍
更新时间:2026-09-24。本文是「集成电路大类 · 芯片设计」入门层(beginner)数字逻辑基础的一篇。芯片之间只要通过一根线串行传数据,就绕不开一个看似琐碎的问题:接收端怎么知道「这一跳」是第几个 bit?SerDes 与 8b/10b 讲了高速链路怎么靠 CDR(时钟数据恢复)恢复时钟,这一篇看更朴素、在单线和低速场景广泛使用的两类自时钟线路编码——Manchester(曼彻斯特)和 NRZI。它们的核心命题相同:不单独传时钟,又要让接收端知道每个 bit 的边界。
本文要回答的问题
- 直接用高电平=1、低电平=0(NRZ)传数据,遇到一长串相同 bit 会出什么问题?
- 曼彻斯特编码为什么能保证「每个 bit 中间都有跳变」?它为此付出的代价是什么?
- 两种曼彻斯特约定(G.E. Thomas 与 IEEE 802.3)差在哪里,设备会接反吗?
- NRZI 用「翻不翻转」表示 bit,为什么还需要位填充(bit stuffing)?
- 接收端到底是怎么从跳变里「摸」出时钟节拍的?
- 这些编码和 8b/10b、64b/66b 在速率和复杂度上怎么分工?
一、NRZ 的死穴:长 0 长 1 没有沿
最直白的编码是 NRZ(Non-Return-to-Zero,不归零码):高电平表示 1,低电平表示 0,电平在整个 bit 周期内保持不变、不回到零电平,所以叫「不归零」。板内并行总线、芯片内部寄存器之间传数据,大多就是这种形态——因为时钟由另一根线单独送,不存在找不到节拍的问题。
可一旦想在一根线上串行传输,再单独拉一根时钟线就有两个麻烦。一是费线:连接器、线缆、PCB 走线都要加倍;二是更隐蔽的数据-时钟偏斜(skew):两根线长度、负载、温漂不可能完全一致,时钟沿和数据到达接收端的时间会错开,速率越高越严重。
那干脆不送时钟,让接收端用自己的本地晶振去数节拍行不行?传 0101 这种翻转密集的数据没问题;可连续发 11110000 时,线上长时间没有任何跳变,接收端没有任何「事件」可以校准自己数到了第几个 bit,只能闷头硬数。本地晶振总有误差,便宜的晶振偏差在 ±50ppm(百万分之五十)上下,这意味着每数 20000 个 bit 就可能差出整整一个 bit 周期。为了留足裕量,一般累计几千到一万个 bit 就必须出现一次跳变来重新对齐,否则采样点会从比特中心慢慢漂到比特边界上,再往后就把相邻 bit 的值采进来了。长 0 长 1 在直流上也不友好:信号长期偏向一侧,交流耦合(串联电容)的链路会把这种偏置慢慢滤掉,基线跟着数据内容漂移。
把漂移算成具体数字更直观。以 12 Mbps 的 USB 全速为例,一个 bit 只有约 83 ns,半比特窗口约 42 ns;±50ppm 的晶振每 bit 偏差约 4.2 ps,单向累积约一万个 bit(不到 1 ms)就可能漂出半个比特。实际链路还叠加温度变化、电源噪声和线路抖动,安全裕量要再砍一半,所以工程上常见的「再同步间隔」普遍只有几千 bit。异步串口(UART)用的是另一种妥协:每个字节开头发一个起始位强行制造一次下降沿,接收端在这一帧的 8~10 个 bit 内靠本地时钟数完——这也是为什么串口波特率偏差超过约 2% 就开始乱码。
所以问题被归结为一句话:必须想办法保证数据流里的跳变密度(transition density)。 曼彻斯特和 NRZI 是两条思路不同的解法,前者从规则上「强制每 bit 一跳」,后者维持高平均效率、只在极端情况下「补跳」。
二、Manchester:每个 bit 中间强制跳一次
曼彻斯特编码(Manchester coding)的做法非常直接:把每个 bit 周期切成前后两半,在正中间放一个必然发生的跳变。这个中间跳变一身二任——它既给接收端提供时钟沿,又按跳变方向携带数据内容。由于每个 bit 都 guaranteed 有一次中间跳变,链路上最长无跳变间隔只有一个 bit 周期,接收端永远不会失去沿;而且每个 bit 内高电平和低电平各占一半时间,长时间平均下来直流分量恒为零,天然直流平衡,交流耦合变压器也能直接挂上去。
还有一个便于用数字逻辑实现的视角:曼彻斯特波形等于 NRZ 数据和时钟异或(XOR)的结果。时钟在每个 bit 中间翻转一次,数据为 1 时异或把翻转方向反过来,数据为 0 时保持原方向——一个异或门就完成了编码,这也是它在数字电路里长盛不衰的原因。解码同样简单:接收端用恢复出的节拍在半个 bit 处采样,或者干脆用 D 触发器对相邻半周期的电平做比较,就能判出方向。
先看一张三种编码在同一串数据下的波形对比,这是本篇的核心图。
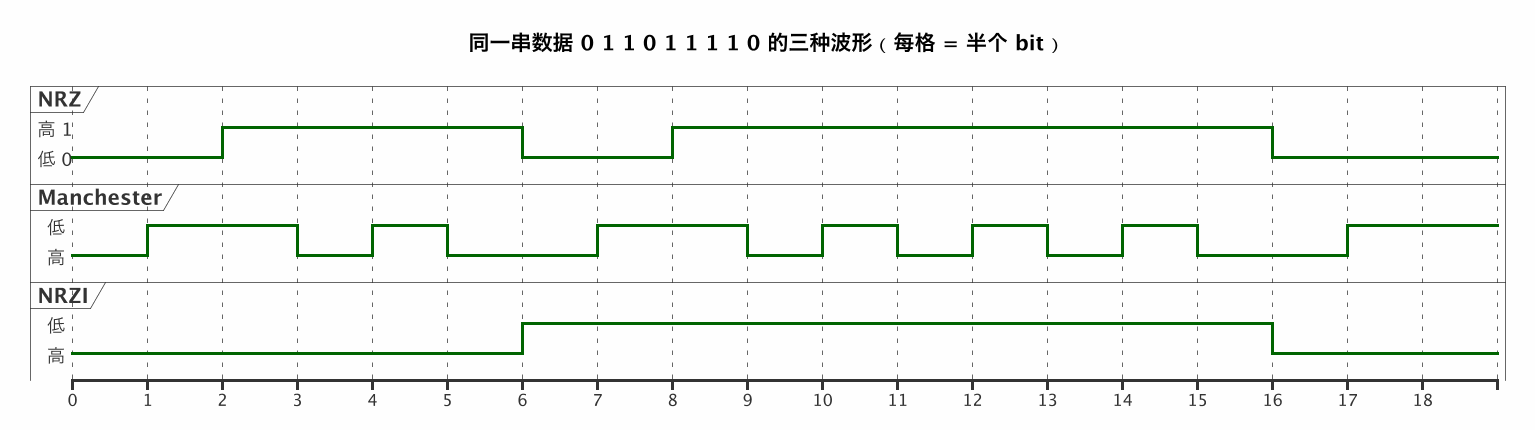
对照波形读:最上面的 NRZ 在 1111 那四个 bit(对应第 5 到第 8 个 bit)期间电平一动不动,整整四个 bit 周期没有一个沿——这就是接收端丢失节拍的情形。中间的曼彻斯特波形截然相反,无论 bit 是 0 还是 1,每个 bit 正中间必有一次翻转,密度稳定得像时钟本身;注意看 bit 边界上有时也会翻转(比如连续两个相同 bit 时),但那只是「附带」的,真正承载节拍的是每个 bit 中间那次雷打不动的跳变。最下面 NRZI 的读法和前两者都不同,第四节细说。
顺着波形再走一遍解码过程,能体会它为什么「简单可靠」。接收端锁定节拍后,在每个 bit 的前四分之一处和后四分之一处各采一次电平:前高后低判 0,前低后高判 1。即使某一次中间跳变因为噪声稍微提前或延后,只要两次采样点离 bit 边界还远,判决结果就不受影响——数据眼图最宽的位置恰恰被利用了起来。也可以把相邻两半周期的电平送入一个 D 触发器做比较,比较结果就是 bit 值,全程不需要乘法器、不需要模拟器件。曼彻斯特的这种「规则对称、判决点天然落在眼图中央」的特性,是它在教学和工程里都经久不衰的根本原因。早年硬盘磁记录还用过它的变体 MFM(改进频率调制,也称密勒编码):只在必要处安排翻转,把翻转密度降下来以提高记录密度,可以看作「舍不得双倍带宽」之后对曼彻斯特的第一次改良。
代价同样很实在,图上一眼可见:曼彻斯特信号每个 bit 最多出现两次跳变,最高翻转频率是数据率的两倍。在 NRZ 上 1 Mbps 的数据率只需要约 0.5 MHz 的模拟带宽,曼彻斯特就得按 1 MHz 准备线路——编码效率只有 50%,即每传 1 个 bit 要占 2 个波特(baud,线路符号率)。这正是「用双倍带宽换自时钟」。因此曼彻斯特用在带宽不紧张、但希望解码尽量简单可靠的场合:10BASE-T 以太网(10 Mbps)、红外遥控与 IrDA、RFID 读卡器与标签之间、不少无线传感网和工业单线链路。线路便宜、协议简单、接收端几个触发器就能解,比省下那点带宽划算。
三、两种曼彻斯特约定与差分曼彻斯特
中间跳变的方向到底怎么对应 0 和 1?历史上留下了两套极性完全相反的约定,对接设备时必须留意:
| bit | G.E. Thomas 约定(常见教材、红外、RFID) | IEEE 802.3 约定(早期以太网) |
|---|---|---|
| 0 | 前高后低(中间 1→0) | 前低后高(中间 0→1) |
| 1 | 前低后高(中间 0→1) | 前高后低(中间 1→0) |
第二节的波形图采用的是 G.E. Thomas 约定:bit 0 前高后低,bit 1 前低后高。两套约定本身没有对错,只是「同一张波形表会被解出完全相反的数据」,所以标准必须写死。实际工程中这件事危害有限——通信前总有固定的同步头和已知训练序列,接收端发现解出来的前导码反了,就知道极性约定相反或者线对被接反,软件里把结果整体取反即可。
直流平衡为什么值得专门强调?很多长距离或隔离链路在线上串有变压器或耦合电容,这些器件只能通过变化的分量、过不去直流。若编码长期偏向高电平,电容会被慢慢充电,接收端看到的基线就随数据内容上下漂,原本以 0V 为界的判决阈值变得不再可靠;信号还会向变压器铁芯注入直流偏磁,极端情况下使磁芯饱和、彻底失去传输能力。曼彻斯特每 bit 内高低各半,无论数据内容是什么,任意时刻向前数若干 bit,高低时间几乎严格相等,相当于从数学上消除了这个问题,这也是它在隔离和变压器耦合场景(早期以太网每段都靠脉冲变压器隔离)受青睐的原因之一。
如果希望从物理层就免疫极性接反,可以用差分曼彻斯特编码(Differential Manchester):中间跳变仍然只承担时钟功能,数据改由「bit 开头是否翻转」表示——比如开头翻转表示 0、不翻转表示 1。差分编码读的是「变与不变」,和电平绝对值无关,两根线无论怎么对调都能正确解码。令牌环(Token Ring)网曾经使用它,差分曼彻斯特同样是每 bit 至少一跳、效率 50%、天然直流平衡,今天在一些磁记录和抗干扰要求高的工业链路里还能见到。
四、NRZI:用「翻转与否」携带数据,外加位填充
**NRZI(Non-Return-to-Zero Inverted,翻转不归零码)**换了一个映射思路:遇到 0 就在比特边界翻转电平,遇到 1 则保持电平不变(USB 采用的约定;也有标准定义相反)。数据藏在「变不变」这个事件里,而不是电平的绝对高低里。对照篇首波形图最下面一行:数据 0 1 1 0 ...,初始为低,第一个 0 让它翻成高,接着两个 1 保持高,第四个 bit 是 0 又翻回低——NRZI 电平变化次数明显比曼彻斯特少,没有数据时线路几乎不动,因此它的编码效率接近 100%,不需要付双倍带宽。
差分的语义还附带一个好处:发送端或线缆把两根差分线接反,只是把所有电平整体取反,「哪里翻了、哪里没翻」完全不变,数据照样正确。
但 NRZI 有个一望可知的软肋:连续发 1 时线路长时间不翻转,接收端又回到了 NRZ 的困境。USB(全速 12 Mbps、低速 1.5 Mbps)的解法叫位填充(bit stuffing):发送端检查比特流,只要连续出现 6 个 1,就强制插入一个 0,人为制造一次翻转;接收端数到连续 6 个 1 之后,就把紧跟着的那个 bit 识别为填充位并删除(destuffing),还原出原始数据。这样一来,链路上实际传输的波形最多只有 6 个 bit 不跳变,接收端的时钟跟踪电路始终有沿可锁。位填充是按数据内容动态插入的,最坏情况下开销约 1/6(约 17%),平均开销小得多,比曼彻斯特固定 50% 省不少。
原始数据 : 0  1  1  0  1  1  1  1  1  1  0
                              ↑ 第 6 个连续 1
线路实际 : 0  1  1  0  1  1  1  1  1  1 [0] 0
                                  强插的填充位(强制翻转)
USB 在物理层还做了另外两件配合的事:差分线 D+/D- 用 J、K 两个差分状态承载 NRZI(J 是静态空闲电平,K 是它的翻转状态),包开始前先发同步域(Sync:全速是 KJKJKJKK 共 8 个 bit,即一连串翻转后以两个 1 收尾),接收端数这串翻转既锁定频率又对齐相位;包结束用两个 bit 时间的 SE0(D+、D- 同时拉低的单端零状态,正常数据里永远不会出现)强制跳出位填充规则,明确告诉设备「后面不用再删填充位了」。位填充规则为什么选 6 而不是 3 或 20?这是在两端之间折中:间隔太短,填充开销大且频繁打断波形;间隔太长,接收端 PLL 在两次翻转之间自由漂移的时间过久,相位误差会累积。6 个 bit 对应全速 USB 约 500 ns 的最大失锁时间,正是接收端晶振精度和 PLL 设计能轻松兜住的量级——这类「数字拍脑袋、其实算过量级」的参数,在协议标准里随处可见。顺便一提,NRZI 最早同样来自磁记录领域,磁带、软盘都用过它的变体,因为磁头读出来的本来就是「翻转脉冲」而非绝对电平,和 NRZI 的事件语义天然契合。需要注意 NRZI 本身不保证严格直流平衡——数据里 0 偏多翻转就偏多、1 偏多电平就长期不动,USB 靠差分驱动、上层数据的统计特性和较短的包长共同兜底,不像曼彻斯特那样有数学上的保证。
五、接收端:时钟是怎么从跳变里「摸」出来的
编码保证「线上有足够的沿」,只是完成了一半;另一半是接收端如何利用这些沿重建节拍。曼彻斯特和 NRZI 速率不高,最常见的两种实现是数字过采样和小型数字 PLL。
过采样(oversampling):接收端用一个频率 4 倍、8 倍甚至 16 倍于比特率的采样时钟连续采样线路电平,在高速样本流里检测电平翻转的位置,翻转附近的样本不可信(处在建立过渡区),取两次翻转「正中间」的样本作为该 bit 的判决值。由于每个 bit 都有跳变,曼彻斯特的采样窗口可以逐 bit 修正;NRZI 加位填充后最久 6 个 bit 也会等来一次修正。这种方法纯数字、可综合、不需要模拟电路,是 USB 收发器和低速链路的主流做法。**数字 PLL(锁相环)**则更精巧:用鉴相器比较「本地预测的跳变时刻」和「实际跳变时刻」,早了就把本地相位往后拨一点、晚了往前拨一点,反复几次后本地时钟就咬住线路节拍,详见 全数字 PLL 与时钟数据恢复。
以 8 倍过采样为例把过采样过程走一遍:每个 bit 周期采 8 个点,记为位置 0 到 7。检测到翻转后,把翻转发生的位置登记为相位参考;理想情况下翻转应出现在位置 0(bit 边界)或位置 4(曼彻斯特的中间沿),若实际出现在位置 5,说明本地采样相位偏早一拍,逻辑就把判决窗口整体往后挪一个样本。连续几个 bit 修正之后,判决位置稳定在两次沿的正中(位置 2、6 附近),那里离任何跳变都最远、电平最干净。因为相位修正是「逐沿小步挪」而不是「每帧重来」,线路上零星一个迟到或早到的沿只会让窗口轻微晃动,这就是接收端对抖动(jitter)的容忍能力。跨时钟域采样还涉及亚稳态问题,工程上会在输入端串两级触发器再判决,原理见脉冲整形与同步。
下图把「时钟藏进跳变」这条完整链路画出来。

这张图对应着全篇的逻辑闭环:发送端通过编码规则把时钟信息「溶解」进跳变流,线路上只有一根信号线在走;接收端做的事情恰好相反,用过采样或 PLL 把跳变里的节拍信息「提炼」回一个本地时钟,再用这个时钟在每个 bit 最稳妥的中心位置采样,重新得到 NRZ 数据。硬件上这条接收通路的骨架就是一个串入并出移位寄存器配上时钟恢复单元;比特收齐之后,还要做 CRC 校验确认数据没在噪声中传错——编码解决的是「保证能收」,校验解决的是「保证收对」,是两件互补的事。
六、三代自时钟编码的取舍
把几类常见线路编码摆在一起对比,工程选型的逻辑就非常清楚了。
| 编码 | 自时钟手段 | 效率 | DC 平衡 | 典型场景 |
|---|---|---|---|---|
| NRZ | 无(需独立时钟或成帧) | 最高(1 bit/波特) | 不保证 | 板内并行总线、芯片内部 |
| 曼彻斯特 | 每 bit 中间必有跳变 | 50%(2 波特/bit) | 天然严格平衡 | 10BASE-T、红外、RFID |
| NRZI + 位填充 | 靠翻转,连续 6 个 1 强插 0 | 平均接近 100%,最坏约 83% | 不严格 | USB 全速/低速 |
| 8b/10b | 运行度 RD 平衡 + comma 字符 | 80% | 严格平衡 | PCIe 1/2、SATA、千兆以太网 |
| 64b/66b + 扰码 | LFSR 扰码 + 2 bit 同步头 | 约 97% | 统计平衡 | PCIe 3 及以上、10GbE |
表里藏着一条清晰的工程主线:速率越低、带宽越不珍贵,越倾向用简单可靠、强跳变的方案——曼彻斯特几个逻辑门就能编解码,出错模式也简单。速率越高,每一个百分点的带宽都意味着真金白银的模拟成本,编码就从「每 bit 强制跳变(50% 效率)」演进到 8b/10b(80%,同时精确保证直流平衡和字节对齐的 comma),再到 64b/66b 扰码(约 97%,只牺牲 2 个同步头,直流平衡改为统计意义上的保证)。「保证有沿可跟、保证直流平衡、提供字节对齐」这三样东西始终都要买,只是买法越来越省、电路越来越复杂。
对入门者而言,先把曼彻斯特和 NRZI 这两个「极端」吃透——一个用最直白的方式保证每 bit 一跳,一个用最省的方式靠规则兜底——再去看高速 SerDes 世界里的 8b/10b 和扰码,就只是同一思想的精细化版本,而不是一堆陌生协议。
这一篇在知识体系里的位置
本篇属于芯片设计入门层的数字逻辑与接口基础,回答「一根线怎么既传数据又传节拍」。向基础读,编码与解码电路本身是移位寄存器与串并转换和码制转换的直接应用,接收端的同步处理可配合脉冲整形与同步一起看;向高速读,本篇是 SerDes 与 8b/10b、64b/66b 的低速预演,时钟恢复的深入版本在全数字 PLL 与 CDR;向可靠性读,数据收下来之后交给 CRC 与 LFSR 把关。把「跳变密度」这一个概念想通,这条线就全部串起来了。
总结
Manchester 与 NRZI 自时钟编码的本质,是用编码规则把时钟「藏」进数据跳变里:NRZ 直接用高低表 1/0,遇到长 0 长 1 没有沿,接收端靠本地晶振硬数必然漂移;曼彻斯特在每个 bit 中间强制放一次跳变,既当时钟又按方向表数据(G.E. Thomas 与 IEEE 802.3 两约定极性相反,差分曼彻斯特改为按 bit 开头是否翻转表数据、免疫接反),最长无沿只有一个 bit 且天然直流平衡,代价是每 bit 最多两个沿、效率只有 50%,适合 10BASE-T、红外、RFID 等带宽宽松、要求解码简单的链路;NRZI 用「比特边界翻转表 0、不翻表 1」,极性接反也不影响且效率接近 100%,但连续 1 会失沿,USB 用位填充——连续 6 个 1 强插一个 0、接收端照规则删除——保证跳变密度;接收端统一靠数字过采样或小型 PLL 从沿中恢复节拍、在比特中心采样,再用 CRC 保证收对;从曼彻斯特到 NRZI 位填充、8b/10b(80%)再到 64b/66b 扰码(约 97%),工程主线是速率越高越舍不得为自时钟和直流平衡付带宽,用越来越精巧的编码把「有沿可跟、直流平衡、字节对齐」以更低开销买到。