Makefile 和 Shell 脚本哪个适合 EDA 工程管理:依赖图与顺序脚本怎么分工
更新时间:2026-10-28。刚接触 EDA 流程的同学几乎都会写一个
run.sh把综合、仿真、版图几步串起来,然后在某天改了一个 RTL 文件、看着脚本把整个流程从头重跑十分钟后,第一次听说「其实应该用 Makefile」。这篇回答:Makefile 和 Shell 到底谁适合管 EDA 工程,以及真实团队里两者怎么混用。它承上启下:上游是 芯片设计流程全景 与 EDA 工具链概览,下游你会在各环节的回归脚本里反复遇到这个选择。
本文要回答的问题
- Makefile 和 Shell 脚本的本质差异是什么?为什么一个「聪明」一个「老实」?
- EDA 工程里哪些活该给 Makefile,哪些活该给 Shell?
- 「增量重建」到底省了什么?为什么回归跑不完往往是脚本写的?
- 常见的误区有哪些——比如用 Makefile 写环境准备、用 Shell 手写依赖判断?
简短结论
两者不是替代关系,是分工关系:涉及「一堆输入文件产生一堆输出文件、改了哪部分只重做哪部分」的流程(编译、仿真、综合、回归),用 Makefile——它按文件依赖关系增量重建,还能天然并行;涉及「一次性把若干步按顺序做完、和环境打交道」的流程(环境变量设置、工具 license 检查、目录初始化、跑完打包归档),用 Shell 脚本——它顺序执行、直白好读。真实工程里最常见的姿势是:Shell 脚本做入口和收尾,中间的核心构建段调 make。
理由一:本质差异是「依赖图」对「顺序流」
Shell 脚本是一本菜谱:从上到下逐条执行,执行到谁就做什么,不知道也不关心「这一步的输入有没有变过」。Makefile 是一张依赖关系图:每条规则声明「目标文件 ← 由哪些前提文件 ← 用什么命令生成」,make 启动时把整张图建出来,按文件的最后修改时间判断哪些目标过期了,只重跑过期的那一小片。
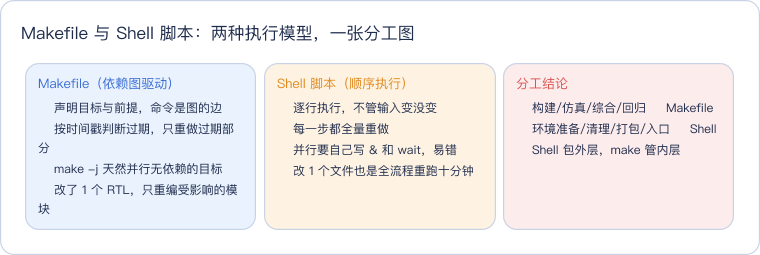
读这张对比卡抓住一个判据就够了:这一步的「重来成本」是否取决于「输入有没有变」。取决于输入的(编译、仿真),给 Makefile 去算依赖;不取决于输入的(建目录、设环境),给 Shell 顺序做掉。
理由二:增量重建省的不是时间,是迭代心态
EDA 流程的典型依赖链是这样的——RTL 变了要重编译,编译产物变了要重仿真,testbench 变了只影响仿真不影响综合结果:
这张图要读的是箭头的「分叉」:改了 tb_top.sv,过期的只有「编译产物 → 仿真结果 → 报告」这一条链,综合网表不受影响;用 Shell 顺序脚本则不分青红皂白整条链重跑。在一个真实项目里,回归一次可能是几十分钟到几小时——「改一行注释要不要重跑全部」这个差别,直接决定工程师一天敢迭代几轮。Makefile 把「重来成本」压到最小,人就更敢小步快跑地改。依赖写错导致的另一种灾难(改了文件却没触发重建)是真实事故高发区,回归依赖不重建的排查 讲的就是这类坑。
对应的最小 Makefile 长这样,规则即依赖边:
work/dut.stamp: dut.v fifo.v
	vlog dut.v fifo.v && touch $@

sim.log: work/dut.stamp tb_top.sv
	vsim -c -do "run -all" tb_top | tee sim.log
理由三:并行是 Makefile 的免费红利
Shell 脚本要并行,得自己写后台任务、管理等待和错误传播,写对不容易。Makefile 只要 make -j8,它会沿着依赖图自动找出彼此无依赖的目标同时跑——8 个测试用例的仿真、多个模块的综合,天然可以铺满核。这也是为什么大规模回归系统(无论是自研还是 CI 里套一层)几乎都以 make 或类 make 的构建系统为骨架。
还有一个容易被忽略的附属收益:依赖图本身就是文档。一个新同事拿到工程,读 Makefile 就能看清「仿真依赖编译、报告依赖仿真、综合和仿真互不依赖」的拓扑;而读一个两千行的 run.sh,得从头到尾脑内模拟执行顺序才能拼出同一张图。Makefile 把「流程知识」从顺序叙述变成了显式的图结构,这在人员流动频繁的团队里是实打实的可维护性资产。
理由四:Shell 的主场是「环境」和「一次性流程」
反过来看 Shell 的优势区。EDA 工具的启动非常依赖环境:license 指向、工具路径、模块加载(module load)、工程目录初始化、跑完之后的日志收集与归档。这些事情没有「输入文件变没变」的概念,每次都要原样做一遍,而且充满判断和错误处理(license 没起来就报错退出)——这正是 Shell 的顺序流加 if/exit 最顺手的场景。硬塞进 Makefile 只会得到一堆 .PHONY 伪目标和别扭的 Tab 缩进。
常见误区
用一张思维导图把两者的分工与误区收拢起来:
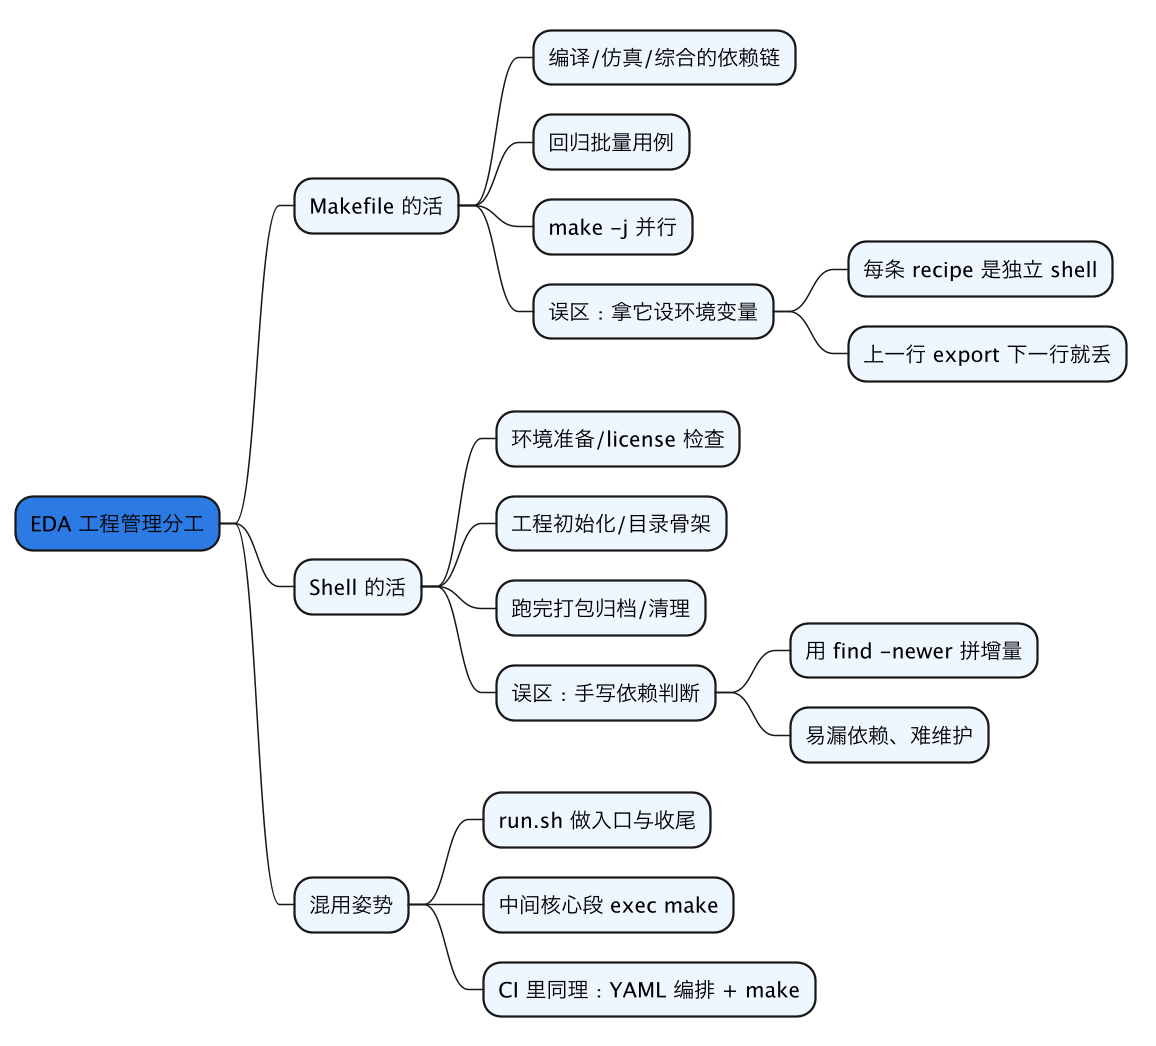
导图里两个误区值得展开说。用 Makefile 设环境是最常见的:Makefile 每一行 recipe 都在一个独立的子 shell 里跑,这一行 export LM_LICENSE_FILE=...,下一行命令根本看不到——环境准备必须在进 make 之前由 Shell 完成,或者用 export VAR := ... 这种 Makefile 变量导出语法(它作用于 make 派生的所有子进程,语义完全不同)。用 Shell 手写增量则是另一个极端:用 find -newer、手比较 md5 拼一个「穷人版 make」,初期看似灵活,依赖一复杂就开始漏——某个头文件改了没触发重编,仿真结果用的是旧 RTL,查一晚上。工具已经存在几十年了,不要重造。
完整的混合骨架通常是这样:
#!/bin/bash
# run.sh:入口脚本,管环境和收尾
set -e
module load vcs/2023.03
export PROJ_ROOT=$(pwd)
make -j8 regression        # 核心构建段交给 make
./scripts/collect_logs.sh  # 收尾归档
延伸阅读
- 芯片设计流程全景:看 RTL 到 GDS 各环节各是哪类「依赖链」,哪里该放 Makefile。
- EDA 工具链概览:各环节工具怎么被脚本驱动。
- 逻辑综合入门 与 综合是什么:综合脚本是 Makefile 管理的典型对象。
- 回归依赖不重建排查记:Makefile 依赖写漏时的真实症状与修法。
一句话总结
一句话总结:Makefile 和 Shell 不是二选一,而是「依赖图驱动」与「顺序流执行」两种模型的分工——编译、仿真、综合、回归这类「输入变才重做、还要并行」的活交给 Makefile(make -j 增量重建是工程师敢快速迭代的前提),环境准备、license 检查、初始化、归档这类「每次原样做一遍」的活交给 Shell,真实工程的标准姿势是 Shell 脚本做入口和收尾、中间核心构建段调 make;两个最常见的误区是用 Makefile 设环境变量(每行 recipe 独立子 shell、导出即丢)和用 Shell 手写依赖判断(重造一个不可靠的穷人版 make)。