Vivado 利用率报告怎么读:report_utilization 逐栏拆解
更新时间:2026-10-22。面向 FPGA 入门 阶段第一次跑完综合、面对一屏表格不知道看哪的同学。
report_utilization是 Vivado 给出的「你的设计吃了器件多少资源」的答卷,但报告分 9 节、几十行,新手常犯两个错:要么只看最后一个 Util% 就关掉,要么逐行死磕每个字段。本文用两个真实设计——一个 4 位计数器、一个 16×8 FIFO——在 xc7a35tcpg236-1 器件上综合出的真实报告原文当样本,讲清哪些栏是主角、数字背后的直觉是什么。仿真阶段的验证方法见前置篇 Vivado 命令行批处理仿真。
本文要回答的问题
- report_utilization 九个节里,哪几节是日常必看?
- Slice LUTs / Slice Registers / F7/F8 Muxes 各对应什么硬件?
- 计数器 3 个 LUT、FIFO 63 个 LUT,这些数字合理吗,怎么心算验证?
- 综合阶段的 LUT 数与最终实现为什么可能不一样?
一、先看两个真实设计的数据
两个设计在 Vivado 2017.4、xc7a35tcpg236-1(Artix-7 35T,Cyclone 系常见的教学板器件)上批处理综合,Slice Logic 一节的核心数字:
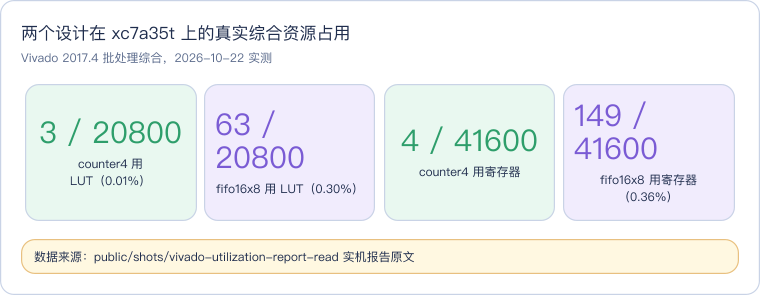
读这张数据卡先建立一个量级感:教学级小设计对这颗器件来说就是「毛毛雨」——counter4 占 0.01%,FIFO 也不过 0.30%。可用量天花板记住两个数:20800 个 Slice LUT、41600 个 Slice Register(寄存器恰是 LUT 两倍,因为每个 Slice 里的触发器数量是查找表的两倍,这是 7 系架构的固定配比)。利用率报告的读法,本质就是拿你的 Used 列跟这两个数(以及 IOB 106、BRAM 50、DSP 90 等)做除法。
二、报告骨架:九节里只看三节半
report_utilization 的目录固定九节:1. Slice Logic(含 1.1 寄存器类型汇总)、2. Memory、3. DSP、4. IO and GT Specific、5. Clocking、6. Specific Feature、7. Primitives、8. Black Boxes、9. Instantiated Netlists。日常使用盯三节半:
读这张图抓住主次:蓝色两节(Slice Logic、IO)是每次综合后必看的主战场,灰色三节按需扫。绝大多数「资源爆了」的问题发生在 Slice Logic;绝大多数「怎么用了这么多」的疑问能在 Primitives 一节找到答案;IO 一节则是和板级原理图对账的地方——FIFO 设计 24 个 IOB 占 22.64%,是全部九节里利用率最高的一栏,引脚比逻辑先耗尽是小器件的常态。
三、Slice Logic 逐栏拆解
以 FIFO 设计的真实报告段为样本(完整原文见文末实验环境):
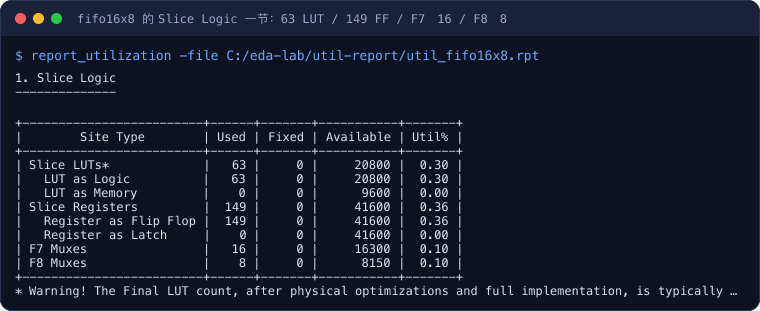
逐栏读这张表。Slice LUTs(63/20800,0.30%):查找表,所有组合逻辑的归宿——LUT as Logic 是当普通逻辑用,LUT as Memory 是当分布式 RAM/移位寄存器用(本设计为 0,因为 FIFO 的存储被映射成了寄存器阵列,见下文)。Slice Registers(149/41600):触发器,Register as Flip Flop 149、as Latch 0——Latch 为 0 是好信号,锁存器多半是代码漏写分支的产物,出现在这里要回头查 RTL。F7/F8 Muxes(16/8):7 系 Slice 里的专用多路器,当一个逻辑函数超过 6 输入(LUT6 装不下)时,综合器用 F7 把两个 LUT6 拼成 7 输入、F8 再拼成 8 输入——FIFO 的 16 选 1 输出 mux 正好撞上这条路径,所以计数器设计这两个是 0、FIFO 设计冒出来 16+8,这是合理推断能验证的。
报告 1.1 节「Summary of Registers by Type」还有一层信息:FIFO 的 149 个寄存器里 128 个是「Clock Enable + Synchronous Reset」(16×8 存储阵列:16 字 × 8 位 = 128,一个不多一个不少),21 个是「Async Reset」(读/写指针与标志位)。寄存器构成能对上设计意图,说明综合器按你预期的方式理解了代码。
四、数字合理性:心算验证两个设计
报告数字不该只是「接受」,要能心算复核。counter4:4 位寄存器 = 4 FF;count + 1 的加法与输出缓冲 = 3 个 LUT(报告 Primitives 节显示 LUT1×2、LUT4×1、LUT3×1、LUT2×1 的细碎组合)。对得上。
counter4 的报告 Slice Logic 一节原文如下,3 LUT / 4 FF 与上面的心算一一对应:
+-------------------------+------+-------+-----------+-------+
|        Site Type        | Used | Fixed | Available | Util% |
+-------------------------+------+-------+-----------+-------+
| Slice LUTs*             |    3 |     0 |     20800 |  0.01 |
|   LUT as Logic          |    3 |     0 |     20800 |  0.01 |
|   LUT as Memory         |    0 |     0 |      9600 |  0.00 |
| Slice Registers         |    4 |     0 |     41600 | <0.01 |
|   Register as Flip Flop |    4 |     0 |     41600 | <0.01 |
|   Register as Latch     |    0 |     0 |     41600 |  0.00 |
| F7 Muxes                |    0 |     0 |     16300 |  0.00 |
fifo16x8:存储阵列 16×8 = 128 FF;读写指针各 4 位 + 满/空标志等约 21 FF;合计 149 FF。输出是 16 选 1 的 8 位 mux——纯 LUT 实现需要大量 LUT6,综合器改用 F7/F8 级联省 LUT(MUXF7×16 + MUXF8×8 在 Primitives 节可见),LUT 只花 63 个。也对得上。
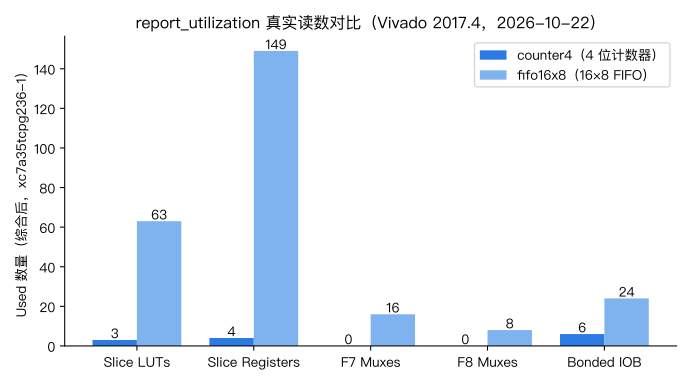
读这张对比图注意两个看点:FF 的放大倍数(4→149,约 37 倍)远大于 LUT(3→63,21 倍)——因为 FIFO 的成本主要在存储阵列而不是控制逻辑;F7/F8 两根柱子只在 FIFO 侧出现,印证「超 6 输入逻辑才动用专用 mux」的判断。图中全部数字取自两份报告原文,不是示意。
五、Primitives 一节:追综合器决策的地方
当 Used 列的数字和直觉对不上时,答案在第七节 Primitives——它把设计映射到的每一个底层原语列成清单。对照两个设计的真实报告:
| 原语 | counter4 | fifo16x8 | 说明 |
|---|---|---|---|
| FDCE / FDRE | 4 / 0 | 21 / 128 | 触发器原语:FDCE 带异步清零,FDRE 带同步复位——正好对应两个设计的复位风格 |
| LUT1–LUT6 | 共 6 | 共 69 | 各输入数的查找表实例,合计数略大于 Slice LUTs(存在共享/打包前统计口径) |
| MUXF7 / MUXF8 | 0 / 0 | 16 / 8 | 宽 mux 的专用级联器,FIFO 输出选择器动用 |
| IBUF / OBUF | 2 / 4 | 12 / 12 | 输入输出缓冲,数量与端口方向一一对应 |
| BUFG | 1 | 1 | 全局时钟缓冲,单时钟设计的定数 |
这张表最有意思的一行是 FDCE/FDRE 的分布:counter4 用异步复位所以 4 个全是 FDCE;fifo16x8 的 128 个存储单元是同步复位(FDRE),21 个指针/标志位是异步复位(FDCE)——原语层面把 RTL 的复位风格原样呈现了出来。再看 1.1 节的寄存器类型汇总(128 个「CE + Sync Reset」、21 个「CE + Async Reset」),两处数字互相印证,这就是「读表读到能对账」的状态。
六、三个易忽略的读表要点
| 报告位置 | 要点 | 为什么重要 |
|---|---|---|
Slice LUTs 行的 * 注释 | 「最终 LUT 数通常会更低,跑 opt_design 后更准」 | 综合阶段是 RTL 级估算,实现(place & route)时物理优化还会合并/删除 LUT,别拿综合数当最终数 |
| Util% 列 | 百分比是相对该器件可用量 | 换器件同一设计百分比全变,比较设计复杂度要用绝对数 |
| Latch 行 | 正常设计应为 0 | 非 0 多半是 if/case 分支没写全,先修 RTL 再看别的 |
另外对照两个设计的 IO 一节:counter4 用 6 个 IOB(clk、rst_n、4 位输出)、5.66%;fifo16x8 用 24 个、22.64%——引脚占用与端口清单一一对应,这栏是发现「端口定义多了/少了」的最快途径。Clocking 一节两个设计都只有 1 个 BUFG:单时钟设计的正常形态;如果哪天冒出 2 个 BUFG 而你只定义了一个时钟,多半是某个信号被综合器自动推上了全局网络,值得追查。
实验环境
- 机器/系统:Windows 10 工作站(Vivado 2017.4 实机)
- 工具版本:Vivado 2017.4(
vivado.bat -mode batch,D:\Xilinx\Vivado\2017.4),器件 xc7a35tcpg236-1 - 日期:2026-10-22
- 完整命令:
vivado.bat -mode batch -source synth_counter.tcl(read_verilog counter4.v→synth_design -top counter4 -part xc7a35tcpg236-1→report_utilization -file util_counter4.rpt);fifo16x8 同流程换顶层
代码获取:本实验完整代码(
counter4.v、fifo16x8.v、两份 synth tcl)见公开仓库 derekzhuo/geek-doc.cn 的experiments/vivado-utilization-report-read/。把 tcl 里的 Vivado 路径改成本机安装目录即可复现。
这一篇在知识体系里的位置
本篇是 FPGA 入门 综合主题的资源读表篇:功能正确性验证在前,仿真侧见 Testbench 与仿真、仿真波形怎么看 与 Vivado 命令行批处理仿真;综合报错类问题见 Vivado 模块找不到 与 Vivado 未定义符号。
一句话总结
report_utilization 九节里日常只盯三节半:Slice Logic 看 LUT/FF/Latch(Latch 必须为 0)、IO 看引脚对账、Clocking 扫 BUFG,用到 BRAM/DSP 才看对应节;xc7a35t 的天花板是 20800 LUT / 41600 FF,读数要会心算复核(FIFO 的 128 个存储 FF、16 选 1 mux 动用 F7/F8 都是能对上的),并记住综合 LUT 数是估算值、实现后通常更低。