UVM test 库组织:命名与工厂注册规范、base test 分层与 smoke/nightly/full 回归集组织
更新时间:2026-10-01。UVM 环境里最先失控的往往不是 scoreboard 也不是 sequence,而是 test 库——项目跑到中期,tests 目录下躺着三百个文件,命名风格三种并存,没人说得清哪些用例该进 nightly、哪些早被新特性废了。本站已有不少相邻弹药:UVM env/top/test 结构 讲 test 在层次里的位置,SV testcase 基类派生 讲单个 test 怎么写,UVM 工厂调试与 override 审计 讲工厂机制本身,回归管理与 triage 讲失败怎么分诊。这一篇解决的是它们中间的空白:当一个团队的用例从十个涨到几百个,UVM test 库组织本身怎么设计,才能不塌。
本文要回答的问题
- test 的命名与工厂注册为什么要立规范,规范该管到哪一层?
- base test 应该分几层,每层放什么、不放什么?
- 功能用例与定向用例怎么从 base test 派生才不重复造轮子?
- smoke、nightly、full 三级回归集怎么划分,划错的代价是什么?
- 用例退役、打标签、与覆盖率映射这些「库卫生」工作怎么落地?
一、命名与工厂注册:先给每个 test 一个不会撞的身份
UVM 的 test 靠工厂创建,run_test("xxx") 传的是字符串——字符串就是身份。身份一旦乱,后面所有自动化(回归脚本、覆盖率映射、失败 triage)全部跟着乱。所以规范的第一刀砍在命名。
推荐的命名模式是 <域>_<特性>_<场景>_<变体>_test,四段各有职责:域说明属于哪个接口或子系统(axi、ddr、irq),特性说明验什么功能点(burst、backpressure),场景说明刺激形态(rand、err_inj、boundary),变体用于区分同场景的不同约束组(short、max_len)。于是 axi_burst_rand_short_test 一眼可读,回归列表按字典序排出来天然按域聚类。要避免的写法有三种:纯序号命名(test_037,三个月后没人记得它验什么)、人名命名(tom_debug_test,人一走用例就成孤儿)、以及把配置参数塞进名字(axi_len128_clk2_test,参数改一次名字就撒谎)。
工厂注册侧的规范更硬:每个 test 类必须 `uvm_component_utils(xxx_test) 注册,类名与 run_test 字符串严格一致,一个文件一个 test 类,文件名与类名一致。三条看着琐碎,违反的代价都很具体——没注册或注册名与类名不一致,run_test 报 "test not found",新人查半天以为是编译问题;一个文件塞多个 test,filelist 维护者为了加一个用例被迫编译全部;文件名与类名漂移,grep 类名找不到文件,IDE 跳转全废。
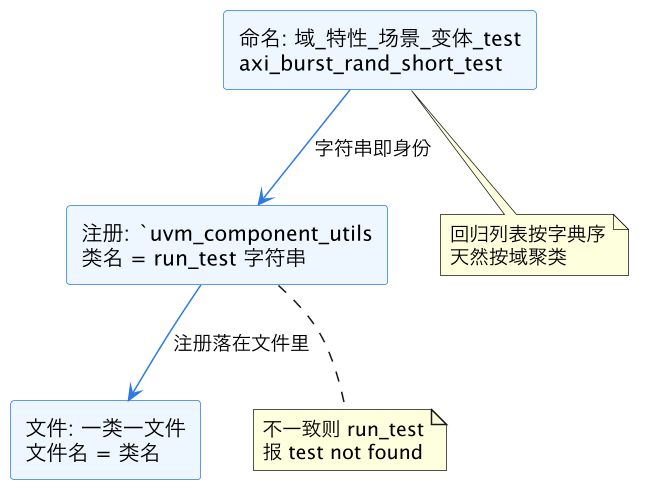
上图是身份三件套的关系:命名给人看,注册给工厂看,文件组织给工具链看。三者对齐,自动化脚本才能用同一套规则同时处理「人写的代码」和「机器跑的列表」。
二、base test 分层:公共逻辑只写一次的艺术
base test 是 test 库的骨架。分层的核心原则一句话:每一层只放该层所有子类百分之百会用的东西,多一点都不放。推荐三层:
| 层级 | 类名示例 | 职责 | 禁止放入 |
|---|---|---|---|
| L1 平台基类 | chip_base_test | env 实例化、config_db 传递、verbosity/objection 基础设施、公共 plusargs 解析 | 任何具体协议、具体激励 |
| L2 域基类 | axi_base_test | 该域 agent 配置、域内公共 virtual sequence 挂接、域级 coverage 使能 | 具体场景约束 |
| L3 功能用例 | axi_burst_rand_test | 启动哪个 sequence、场景特有的覆盖与检查开关 | 公共逻辑(上移回 L1/L2) |
这个表的背后是无数次重构换来的教训。最常见的病是「L1 浮肿」:某个项目着急,把 DDR 的初始化 sequence 启动逻辑塞进了 chip_base_test,结果所有不碰 DDR 的用例也背着这段代码,后来 DDR 控制器换 IP,改动波及面是全库三百个用例的编译。第二种病是「L3 复制粘贴」:用例之间靠拷贝上一个用例改两行产生,同一处 bug 修了十五遍——判别标准很简单,同一段代码出现在第三个用例里,就该上移。
分层还有一个隐藏收益:override 的作用点变清晰。工厂 override 写在哪一层,决定了它影响哪些用例——写在 L1 的 type override 全库生效,写在 L3 的只影响单用例。override 的调试与审计套路见 UVM 工厂调试与 override 审计,配合分层基类,「这个 override 影响了谁」从考古题变成查表题。
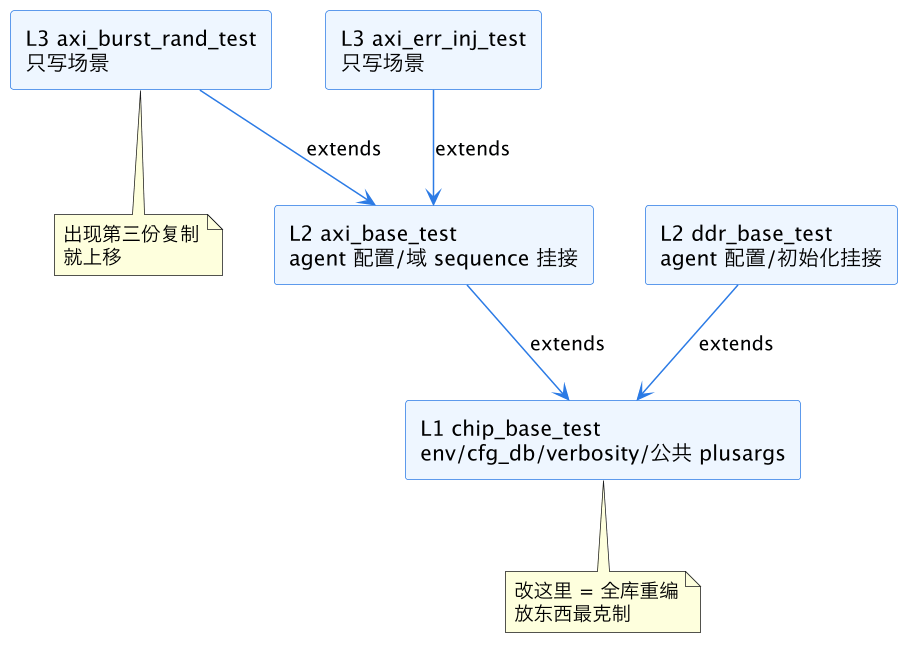
读这张图时盯住箭头方向:依赖关系是自下而上的,所以改动代价也是自下而上放大的。L1 改一行,全库重编一遍;L3 改一行,只影响自己。这就是为什么「L1 最克制」是铁律——层级越高,入层门槛越严。
三、回归集组织:smoke / nightly / full 三级怎么切
有了身份清晰、分层干净的用例库,下一个问题是算力分配:许可证和机器就那么多,不可能每次提交都全量跑。业界通行的解法是三级回归集。
| 回归集 | 触发时机 | 时长预算 | 选例标准 | 典型规模占比 |
|---|---|---|---|---|
| smoke | 每次提交 / 合入前 | 30-60 分钟 | 每域 1-3 条最短路径用例,挡住「环境都起不来」级事故 | 5% 左右 |
| nightly | 每晚定时 | 6-10 小时 | 全部定向用例 + 各场景随机用例的短变体 | 30-40% |
| full | 每周 / 里程碑 | 整个周末 | 全库 + 长随机 + 多 seed 扫射 + 覆盖率合并 | 100% |
切分的关键纪律有三条。第一,smoke 只验「环境活着」不验「功能正确」——它存在的意义是让开发者在提交后一小时内知道「我把环境搞挂了没有」,所以选例标准是快和覆盖面广(每个 agent 至少一条),而不是深度。第二,nightly 是 bug 的主猎场,定向用例全在这里,随机用例跑短变体(同一条用例减短激励长度、固定几个代表性 seed),这样一晚能把主要场景都过一遍。第三,full 的唯一任务是收口:长随机、多 seed、覆盖率合并与缺口分析都在这一级,产出直接喂给覆盖率闭环流程,详见 UVM 覆盖率闭环签核。
用例与回归集的关联不要写在代码里,要写成外部清单(testlist 文件或回归数据库),每条记录至少带:用例名、所属集、超时时间、预期运行时长、负责人、关联 feature 标签。关联靠标签而不是目录——同一条用例完全可以同时属于 smoke(跑短变体)和 full(跑长变体),靠 plusargs 区分变体,这在 UVM 命令行 plusargs 里有机制支撑。
四、库卫生:退役、标签与覆盖率映射
test 库只进不出,两年必成沼泽。三条卫生纪律能挡住大部分腐化。
一是退役机制:特性被砍或 IP 替换时,对应用例进 retired/ 目录并从所有回归集摘除,保留一个里程碑周期后删除。不要直接删——硅后 debug 时偶尔会复活老用例。二是标签体系:每条用例打 feature 标签,与 testplan 条目一一挂钩,这样「这个特性验了没有」可以机器回答,而不是靠人脑回忆;testplan 与覆盖率的映射方法见 testplan 覆盖率映射。三是定期体检:每季度跑一次「僵尸用例扫描」——连续 N 轮回归全过、且从未命中过任何新覆盖点的用例,要么加约束强化,要么降级出 nightly。失败的批量分诊节奏配合 回归管理与 triage 执行即可。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下工程管理线的长尾篇,向上承接 UVM env/top/test 结构 的层次骨架与 SV testcase 基类派生 的单用例写法,横向与工厂机制(UVM 工厂调试与 override 审计)、配置注入(UVM 命令行 plusargs)互相引用,向下把产出喂给 回归管理与 triage 与 UVM 覆盖率闭环签核,构成「写得齐、跑得动、收得口」的完整用例生命周期。
总结
UVM test 库组织就是三件事:用「域_特性_场景_变体」命名加 `uvm_component_utils 注册加一类一文件给每条用例一个不撞车的身份,用「L1 平台、L2 域、L3 场景」三层 base test 让公共逻辑只写一次且高层最克制,再用 smoke 保活、nightly 猎 bug、full 收口的三级回归集把有限算力花在刀刃上,辅以退役、标签、僵尸扫描三条卫生纪律,让用例库从十个涨到几百个也不塌。