row 利用率:标准单元行利用率的设定逻辑——为什么利用率拉满反而烂时序烂布线
更新时间:2026-10-02。floorplan 评审会上最容易吵起来的数字就是 row 利用率:前端觉得「面积就是钱,能塞多满塞多满」,后端拍桌子「上个项目 85% 利用率布线烂了三个月」。双方都没错,只是说的是同一条曲线的两段。本篇是 eda/ 目录下布局布线线的一篇实战向专题,向上承接 floorplan 与布局阶段数据流 的流程定位,横向关联 布局拥塞与 cell padding 和 布线拥塞、DRC 与串扰 两篇——它们讲拥塞的后果,本篇讲拥塞的源头旋钮。读完你应该能回答:row 利用率到底量的是什么、为什么它超过某个阈值后时序和布线质量会加速劣化、以及项目里这个数该怎么定、怎么验。
本文要回答的问题
- row 利用率的精确定义是什么,它和 core 利用率、密度(density)是不是一回事?
- 为什么利用率「越高越省面积」的直觉在超过某个拐点后彻底失效?
- 高利用率劣化时序的物理机制有哪几条,各自对应什么报告特征?
- 布线拥塞和利用率之间是什么关系,为什么 90% 利用率的设计可能反而比 80% 的更占面积?
- 不同模块类型(数据通路、控制逻辑、存储周边)的目标利用率该怎么差异化设定?
- 布局后怎么验收利用率设定是否合适,哪些早期信号提示「定高了」?
一、先对齐定义:row 利用率到底量的是什么
讨论之前先把术语钉死,因为很多争论源于双方说的不是一个数。
标准单元布局区的地板被划成一排排等高的行(row),每行高度等于标准单元的高度,单元像书立在书架上一样沿行摆放。row 利用率(row utilization)的定义是:所有标准单元宽度之和 ÷ 可用 row 位点总宽度。分母要扣掉硬核宏(macro)、硬 blockage、keep-out 区域占掉的位点——这也是最容易算错的地方,用整个 core 面积当分母会把利用率算低好几个百分点。
和它容易混淆的三个兄弟概念:core 利用率是「单元加宏占整个 core 面积的比例」,分母不扣宏,数值天然偏低;placement density 是工具报告里按格子(gcell)统计的局部密度,是空间分布的量而不是全局比例;target utilization 是你写给布局工具的目标值,工具会尽量把全局 row 利用率压在它之下。本篇说的 row 利用率一律指「扣掉宏和 blockage 之后的全局标准单元行填充率」。
一个常见项目的典型量级:成熟节点(28nm 以上)数字逻辑目标 70% 到 80%,先进节点(7nm 及以下)因为布线资源紧张和设计规则复杂,往往压到 60% 到 70%。但这不是金科玉律——第五节会讲怎么按模块调。
二、直觉的失效:拐点之后,面积反而变大
「利用率高 = 面积省」只在低利用率区间成立。原因是一个被忽视的事实:利用率定得太高,布局工具为了塞下所有单元,会把逻辑物理上摊开、拉长连线,最终 design 不得不靠加大 die 或牺牲频率来收场。拐点出现在哪里取决于设计本身,但机制是普适的。
先看时序侧。布局工具的首要约束是把所有单元放进可用位点且不重叠。利用率低时,工具可以为了让关键路径更短而把相关单元聚拢,slack 裕量充足;利用率逼近上限时,「有位子放」成了硬约束,时序优化只能在剩下的缝隙里闪转腾挪——优化引擎想换一个大驱动单元,周围没有空位,只能先做一连串单元搬迁(legalization 的连锁反应),搬迁本身又会挤占别处的空位。到达某个密度后,每一次局部优化的成本急剧上升,工具在有限的优化轮次里能收敛到的时序质量明显变差。表现就是:同样的网表和约束,85% 利用率下 WNS(最差负裕量)比 75% 下差几十皮秒,TNS(总负裕量)差出几倍。
再看一个更隐蔽的效应:时钟树。CTS 时钟树综合 要在已经放好的单元之间插入成百上千个时钟缓冲器,这些缓冲器需要空位。利用率过高的设计里,CTS 被迫把缓冲器插在远离最优位置的地方,skew(时钟偏斜)和 insertion delay 双双恶化,而这部分恶化是布局阶段定利用率时埋下的,到 CTS 报告才暴露。
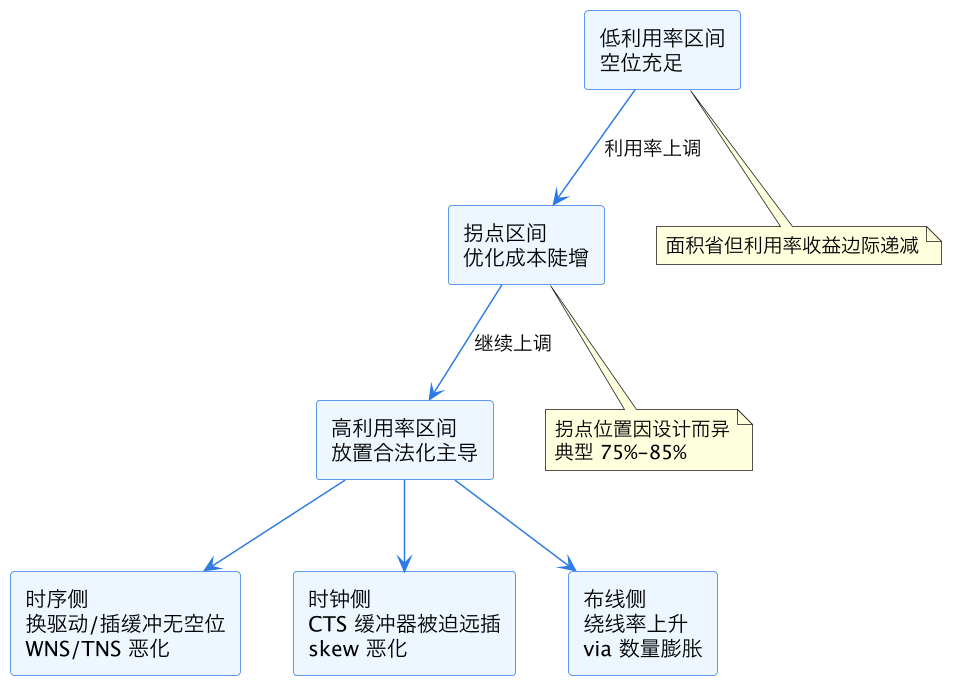
这张图的重点是「拐点」这个中间态:拐点之前提高利用率几乎不付出时序代价,拐点之后每加一个百分点都要用时序、时钟、布线三线付费。工程上设定目标利用率的全部学问,就是找到你这块设计的拐点然后把目标定在拐点左侧两三个百分点。
三、布线侧的机制:为什么烂布线反而更费面积
布线拥塞与利用率的关系不是线性的,这是「利用率拉满反而烂布线」的数学根源。
布线资源是按 gcell 网格计量的:每个 gcell 在每一金属层有固定的轨道数(track)。一个区域的布线需求大致正比于穿过该区域的线网数和每根网的长度。利用率提高时,单元密度上升带来两个乘性效应——引脚密度上升(更多线网起终点挤在同样大的区域),同时布局合法化压力让时序无关的单元被随意填缝,逻辑上相关的单元反而被隔开,平均线长变长。需求按接近平方的速度涨,供给却不变,拥塞就爆了。
拥塞之后工具的对策是绕线(detour),而绕线制造二次伤害:线长变长时序再挨一刀;via 用量膨胀,DRC 违例和串扰风险跟着上来,布线拥塞、DRC 与串扰 对这条链有完整论述;最致命的是局部 hot spot 绕不出来时,流程只能回头放大 die——当初省下的面积连本带利还回去。「85% 利用率的设计实际比 75% 的更占面积」,说的就是这笔回头账。
配套手段是 cell padding 和 soft blockage:padding 给特定单元(高驱动、时钟单元)左右预留虚拟宽度,等效于局部人为降利用率,布局拥塞与 cell padding 有详细手法;soft blockage 在宏周边、通道区软性限密度。全局定框架,局部救热点。
四、把机制落成数字:一张验收对照表
机制讲完,落成一个可以直接拿去评审的对照表。
| 利用率区间 | 时序表现 | 布线表现 | 适用场景 |
|---|---|---|---|
| 55%-65% | 裕量充足,优化空间大 | 几乎无拥塞 | 先进节点、高频数据通路、时钟密集模块 |
| 65%-75% | 轻微劣化,可控 | 局部热点可修 | 通用数字逻辑的默认带 |
| 75%-85% | 拐点区间,需逐模块评估 | 拥塞明显,绕线增多 | 成熟节点、低频控制逻辑、面积敏感项目 |
| 85% 以上 | 显著劣化,TNS 成倍恶化 | 大概率布线不收敛或放大 die | 只用于 SRAM 外围 filler 区等特殊场景 |
这张表的数值不是绝对的——一个以 2 输入门为主的规整数据通路和一个 MUX 密布的交叉开关逻辑,同样的 75% 利用率布线压力天差地别。表格给的是「先验起点」,真正的定案要靠下一节的早期信号来校准。
五、实战方法:分模块设定与早期验收信号
把前面四节落到项目动作上,是三个步骤。
第一步,分模块定目标而不是全芯片一刀切。高频数据通路和时钟域边界模块取低目标(65% 上下),时序敏感度最高,PR 时序收敛 ECO 阶段还要往里塞单元,得留弹性;大块控制逻辑、低速外设可以放到 75% 甚至更高;宏与宏之间的通道区用 soft blockage 限密度,防止工具把通道当「免费空位」填死。useful skew 与 CTS 优化 这类时钟侧技术同样吃空位储备。
第二步,用布局阶段的早期信号验收,而不是等布线挂了才回头。四个写进 checklist 的信号:布局后报告里「因 legalization 失败而未执行的优化数」,非零即警报;全局布线预估里 overflow gcell 比例超过 1% 要认真对待;平均半周线长(HPWL)相比上一版 floorplan 异常变长,说明单元被挤散了;filler cell 与密度规则 能插进多少 filler——健康的设计应能插入占总面积 15% 以上的 filler 和去耦电容,插不进说明空位预算已吃光。
第三步,给 ECO 留编制。tape-out 前必然经历若干轮 ECO,spare cell 摆放策略 的前提是布局阶段就留下可活用的空位。经验值是目标利用率里预留 3 到 5 个百分点的「ECO 余量」,这笔钱项目后期几乎总是省回来。
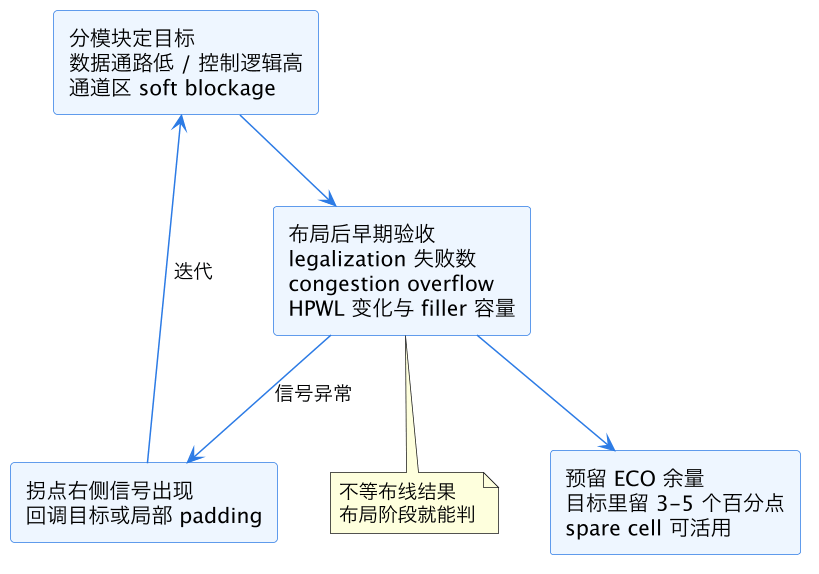
这张闭环图是全篇方法的浓缩:设定、验收、预留、回调。核心思想是把「利用率是否定高了」这个判断从布线完成后的灾难现场,提前到布局后当天的报告里。
这一篇在知识体系里的位置
本篇是 eda/ 目录下布局布线线的实战专题,向上承接 floorplan 与布局阶段数据流 的流程框架,横向与三篇拥塞相关文章互补:布局拥塞与 cell padding 讲局部密度微操,布线拥塞、DRC 与串扰 讲拥塞的下游后果,本篇讲全局旋钮本身。向下游的落点是 CTS 时钟树综合 的空位需求、PR 时序收敛 ECO 的弹性预算,以及 filler cell 与密度规则 的验收口径;与 spare cell 摆放策略 合读可以拼出完整的「空位经济学」图景。
总结
row 利用率是标准单元宽度占可用行位点的比例,它的设定本质是在「面积收益」与「时序、时钟、布线三线的优化空间」之间找拐点:拐点之前提高利用率近乎免费,拐点之后换驱动无空位、CTS 缓冲器远插、布线绕线率按近平方关系恶化,烂布线最终靠放大 die 买单反而更费面积;实战纪律是分模块差异化定目标、用 legalization 失败数、congestion overflow、HPWL 与 filler 容量四个早期信号在布局当天验收,并预留 3 到 5 个百分点的 ECO 余量。