SRAM 时序弧:memory macro 的 access time、setup/hold 约束表怎么读、对 STA 接口时序的影响
本篇是签核时序专题里针对 memory 接口的纵深。标准单元的延迟查表机制见 NLDM CCS 时序模型,
.lib文件的通用字段结构见 Liberty 库与多视图,这些弧最终被谁消费见 Signoff STA 与 PrimeTime。本篇只聚焦一件事:memory macro 的时序弧和普通标准单元有什么不一样,接口路径上最容易在哪儿栽跟头。
本文要回答的问题
- SRAM macro 的读时序弧和写时序弧分别长什么样,和普通 flip-flop 的弧差在哪?
- Liberty 里 memory 的约束表(constraint table)为什么经常带
when条件,怎么读? - access time(clk2q)对读路径的 setup 检查意味着什么,为什么它是关键路径常客?
- memory compiler 生成 macro 时,哪些选项直接改写这些弧的数值?
- 接口时序违规时,先动 macro 还是先动周围逻辑?
一、Memory macro 的时序弧家族
一个典型的单口 SRAM macro,引脚无非 CLK、地址 A、写数据 D、读数据 Q、写使能 WEB、片选 CEB。它的时序弧可以分成四类:
| 弧类型 | 例子 | 在 STA 里的角色 |
|---|---|---|
| 时钟到输出(sequential arc) | CLK → Q(clk2q,即 access time) | 读路径的起点延迟 |
| setup 约束 | A/D/WEB 相对 CLK 的 setup | 写路径终点检查 |
| hold 约束 | A/D/WEB 相对 CLK 的 hold | 写路径最小延迟检查 |
| 最小脉宽 | CLK high/low pulse width | 时钟完整性检查 |
和普通寄存器比,有两个结构性差别。第一,macro 内部不可见:STA 只把这些弧当黑盒查表,macro 内部的译码器、位线充放电、灵敏放大器都不展开,所以弧值里已经揉进了整条内部模拟路径。第二,地址和数据引脚数量多但共享时钟:一个 64K×32 的 macro 有 16 根地址线,每根都有自己的 setup/hold 表,但它们的数值通常几乎相同——因为内部是同一级译码。
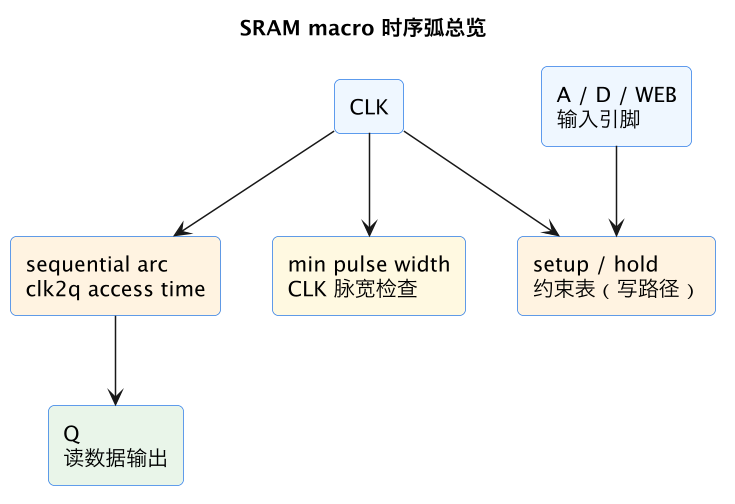
上图把四类弧画在同一个黑盒上:CLK 同时是写约束的参考边沿和读延迟的起点;A/D/WEB 只出现在约束表里;Q 只被 clk2q 弧驱动。记住这张图,后面读 Liberty 文本就是给这三类方框填数字。
二、Liberty 里的 memory 约束表逐字段读
打开 memory compiler 交付的 .lib,timing() 组里读弧和写约束是分开写的。一段典型的读弧:
pin (Q[7]) {
  timing() {
    related_pin : "CLK";
    timing_type : rising_edge;
    cell_rise (delay_template_7x7) {
      index_1 ("0.010, 0.025, 0.050, ...");   /* CLK 输入跳变 */
      index_2 ("0.001, 0.005, 0.020, ...");   /* Q 输出负载 */
      values ("0.420, 0.435, 0.460, ...");
    }
  }
}
timing_type: rising_edge 表示这是 CLK 上升沿到 Q 的 sequential 弧,values 里就是 access time——从 CLK 50% 到 Q 50% 的延迟,随 CLK 跳变和 Q 负载双索引查表。注意 memory 的 clk2q 索引范围通常比标准单元宽得多:Q 上挂的线往往长,负载从几 fF 跨到几百 fF。
写约束则是 timing_type: setup_rising / hold_rising,related_pin 指向 CLK,索引轴是输入引脚自己的跳变 × CLK 的跳变:
pin (A[3]) {
  timing() {
    related_pin : "CLK";
    timing_type : setup_rising;
    rise_constraint (constraint_template) {
      index_1 ("...");  /* A 的跳变 */
      index_2 ("...");  /* CLK 的跳变 */
      values ("0.085, 0.092, ...");
    }
    when : "WEB";        /* 只在写周期生效 */
  }
}
那个 when 是 memory 库区别于标准单元的第三个特征:同一个地址引脚,读周期里它对时序的要求和写周期完全不同(写周期里地址必须在 CLK 前稳定以便选中字线),所以库里用 when 条件把约束切成多套。STA 引擎展开弧时会根据 macro 当前的功能模式挑出生效的那组——这也是为什么同一个 macro 在 read mode 和 write mode 下报告的 slack 结构不一样。
有两个细节读库时容易漏。一是 cell_fall / cell_rise 两张表要分开看:Q 的上升和下降 access time 并不对称,下降沿通常更快(位线放电路径更强),STA 会按最坏边沿取数,但做时钟树平衡时两个值都要进报告。二是 related_pin 在多时钟 macro(双口、寄存器堆)里可能指向不同的 CLK 引脚——读口时钟和写口时钟是两条独立的弧族,接口属于不同时钟域时这些弧根本不参与 setup 检查,而是由 CDC 流程接管,不要把它们当普通违规去修。
三、Access time 为什么是接口关键路径常客
读路径的结构是:上游寄存器 → 组合逻辑(可能有)→ 地址引脚 setup;以及 CLK → access time → Q 输出走线 → 下游寄存器 setup。前者约束地址到达时间,后者约束数据到达时间。实际项目里后者更容易爆:
- access time 绝对值大。一个 16nm 高密度 32K×64 macro 在 SS/125C 角下 clk2q 能到 0.9ns~1.2ns,而同级 flip-flop 的 clk2q 只有几十 ps,差了十几倍。1GHz 设计里,这一个弧就吃掉半个周期,容量越大、位线越长,这个数字还会进一步恶化。
- Q 走线经常很长。memory 在 floorplan 里靠墙放,Q 到消费逻辑的距离远,线上的 RC 延迟和串扰增量都叠在 access time 后面,先进节点下这部分常常再贡献几十到上百 ps。
- setup 检查没有借用。Q 之后的下游触发器是硬 setup,修不动 macro 就只能在 Q 后面立刻挂接收寄存器,把接口路径压成 macro → reg 一跳。
写路径相反,问题通常出在 hold:地址/数据由本周期较早的逻辑驱动,到得太快,macro 的 hold 约束(典型几十 ps 到一百多 ps)容易被薄弱的 min 角击穿,常见修法是在 A/D/WEB 前面插延迟单元或调 short path。修 setup 的手法(换 VT、插 buffer)见 STA setup 修复手段,min/max 角拉开后的 derate 策略见 OCV/AOCV 深度 derate。
还有一个隐蔽来源是时钟到达差异。macro 的 CLK pin 电容远大于普通触发器(大 macro 能到几百 fF),时钟树综合时它经常被单独放在深的 buffer 链后面,导致 macro 时钟到达比同组寄存器晚几十到一百多 ps。这个 skew 对写路径是白送的 margin(数据更早就绪),对读路径却是雪上加霜:clk2q 从更晚的时钟沿起算,Q 到下游寄存器的有效时间进一步被压缩。看接口违规报告时,先把 launch clock path 拉出来确认 macro 时钟延迟,再决定是修数据路径还是请 CTS 把 macro 时钟提前。
四、Compiler 选项直接改写弧值
memory compiler 生成 macro 时几个开关会直接改变交付库里的弧:
| 选项 | 影响哪条弧 | 方向 |
|---|---|---|
| 输出驱动强度(output drive) | clk2q 表对负载的斜率 | 大驱动对大负载更平坦 |
| mux depth(列复用) | clk2q 绝对值、D setup | 深 mux 更省面积更慢 |
| write mask / bit write | 增加 WEM 引脚的 setup/hold | 多一组约束 |
| pipeline / latch 选项 | 把 access time 拆成多拍 | 接口时序结构整体改变 |
选型时不要只看 datasheet 上的典型 access time 一个数——那是某个特定 slew、某个负载下的点值。把 .lib 里 clk2q 表在自己实际的负载区间插值一遍,再对照时钟周期判断这个 macro 能不能放在该频率域里,是更稳的做法。另外注意 compiler 交付的是多 PVT 角的一整套库,SS 角和 TT 角的 clk2q 能差到 1.8 倍以上,接口预算必须按 signoff 最慢角做,同层的 OCV derate 还会在这个数上再叠几个百分点,留余量时把这些系数算在一起而不是拍脑袋加 10%。
五、接口时序违规时的处理顺序
接口违规报到手上,建议按这个顺序排查,能少走弯路:
- 先确认是不是假路径。双口 macro 的读写口时钟不同源时,跨口弧多半是 CDC 问题;
when条件没展开、模式设错时约束会多套或少套,先看模式再看数字。 - 看违规的构成比例。把 path report 里 clk2q、线延迟、下游 setup、clock skew 四项拆开:如果 clk2q 占大头且 macro 已是最快角选型,说明架构上就需要在 Q 后加流水级,修线是修不回来的。
- 能换 macro 不换逻辑。同容量下 compiler 往往能出高速(低 mux、大驱动)和 dense 两档,面积允许时换高速档一次性解决一类接口问题;反过来 hold 违规多则优先修周围逻辑的 min path,不要去动 macro。
- 最后才动 floorplan。把消费逻辑往 macro 的 Q 侧靠、缩短 Q 线,收益真实但牵扯布局,放到前三步都试过之后。
这一篇在知识体系里的位置
- 上游模型:查表与插值机制见 NLDM CCS 时序模型,
.lib字段总览见 Liberty 库与多视图; - 下游消费:Signoff STA 与 PrimeTime 讲这些弧如何进时序图,接口违规的修复手法见 STA setup 修复手段;
- 同层横向:时钟抖动对 setup 预算的削减见 STA 时钟不确定性与抖动,异步接口的弧断裂处理见 STA 环路打断。
总结
SRAM 时序弧就是 memory macro 的接口契约:读方向靠 clk2q(access time)一张随 CLK 跳变和输出负载双索引的查表,写方向靠 A/D/WEB 相对 CLK 的 setup/hold 约束表且常带 when 条件区分读写模式;access time 绝对值大(先进节点高密度 macro 近 1ns),是接口 setup 关键路径的头号来源,选型时必须按实际负载从 .lib 插值验证,而不能只看 datasheet 典型值。