UVM transaction recording:uvm_recorder 与 recording 属性把事务录进波形、与文本 log 互补的调试流、性能开销控制
更新时间:2026-10-03。调 UVM 环境的同学几乎都经历过这种时刻:log 里 grep 到一笔事务在某拍发出去了,想看看它对端 monitor 收到没有、中间隔了多少拍,于是打开波形,盯着一堆信号跳变在脑子里做协议解码,解了二十分钟才发现方向反了。这个痛点的根源是——文本 log 按时间线性格式记录,波形按信号跳变记录,而工程师想看的其实是「事务」这个抽象层。UVM transaction recording 就是补上这一层的机制:通过 uvm_recorder 把 driver 和 monitor 里流动的事务录进波形数据库(FSDB 等),调试器(Verdi 等)就能把事务画在时间轴上,和信号波形对齐显示。站内的 UVM 组件与 phase 讲了组件骨架,UVM monitor analysis imp 讲了事务怎么从接口被捞上来,uvm_report verbosity 控制 讲了文本 log 那一侧的管理。这一篇把另一半——事务怎么进波形、进了波形怎么用来调试、以及代价怎么控制——讲透。
本文要回答的问题
- UVM transaction recording 到底是什么,uvm_recorder 和 recording 属性各自扮演什么角色?
- 事务是怎么被录进波形数据库的,begin_tr 和 end_tr 之间发生了什么?
- 需要手工录制时怎么写,record 字段自动化宏和手工 add 有什么分工?
- 波形事务流和文本 log 在调试里怎么分工,什么样的 bug 用哪条路快?
- recording 的性能开销花在哪里,回归场景怎么把它压到可接受?
一、机制总览:uvm_recorder 是事务流和波形库之间的桥
先把角色钉死。UVM 里参与 transaction recording 的有三方:事务生产者(driver 的 seq_item_port、monitor 的 analysis port 路径上的 begin_tr 和 end_tr 调用)、uvm_recorder(每个 component 内嵌的录制器句柄,负责把事务属性和起止时间翻译成波形厂商的 API 调用)、波形数据库(仿真器落盘的 FSDB 或同类格式,Verdi 等调试器事后打开)。你在组件里几乎不直接碰 uvm_recorder——绝大多数录制动作由 UVM 库在 driver 和 monitor 的标准流程里代劳,你要做的是两件事:打开开关,以及在事务类里声明哪些字段值得录。
开关分两路。一路是运行时配置:uvm_config_db 里给组件设置 recording_detail 属性(取值 UVM_OFF、UVM_LOW、UVM_MEDIUM、UVM_HIGH、UVM_FULL,或者用 plusargs 如 +UVM_RECORDING 视仿真器而定),component 的 is_recording_enabled 据此决定录不录。另一路是编译与事务类侧的准备:字段要进波形,要么用 uvm_field_* 宏(宏展开里含 record 逻辑),要么在 do_record 回调里手工写。两路都通了,仿真跑起来后事务才有「波形形态」。
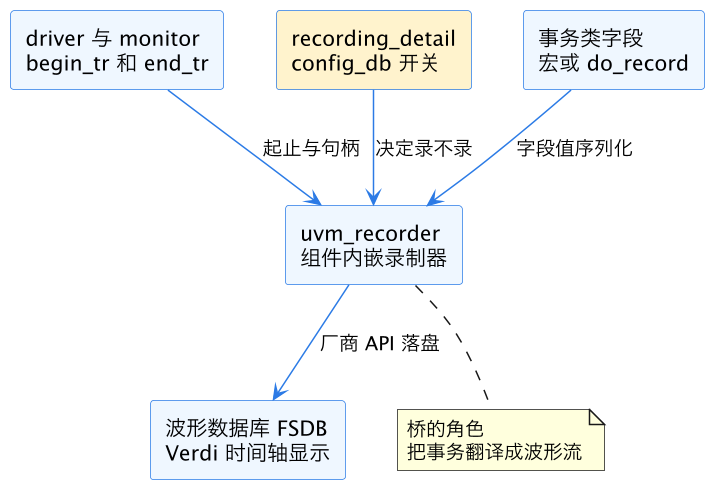
上图是整条链路的骨架:录制器居中,左边接生产者和开关,右边接波形库。理解了这个骨架,后面每一节都只是在这条链路的某一段上加细节。还要强调一点:transaction recording 是仿真期行为,录进去的内容随当次仿真的波形库落盘,不像 coverage 那样跨 test 合并——它是调试资产,不是签核资产。
二、录制时序:begin_tr 开流、end_tr 收尾、中间录属性
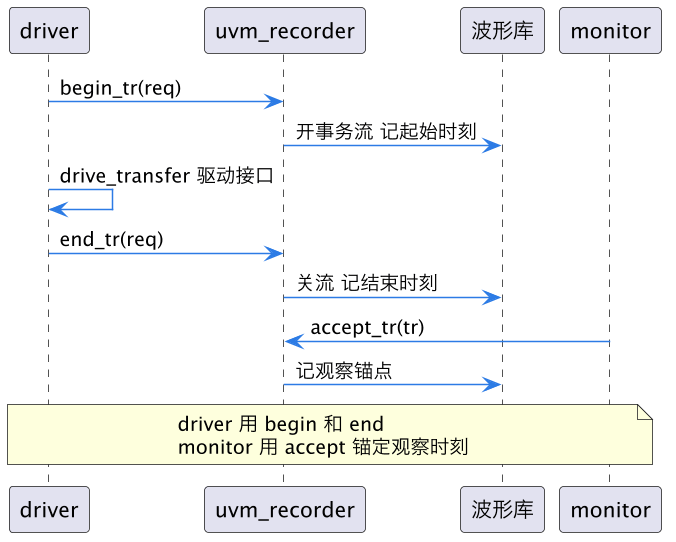
一次完整的事务录制由三个动作构成:begin_tr(tr) 在波形库里开一条事务流并记下起始时刻,中间按需 record 事务字段,end_tr(tr) 关闭这条流并记下结束时刻。调试器在时间轴上把这条流画成一个带持续时间的色块,色块的左沿是 begin 时刻、右沿是 end 时刻,点开能看到录下的字段值。这就是为什么长事务(比如一笔 DMA 传输跨几百拍)在波形里能一眼看出「占了哪段时间」,而文本 log 里你只能看到两行时间戳自己心算差值。
// driver 侧:UVM 标准流程内部大致长这样(库代劳)
seq_item_port.get_next_item(req);
tr_handle = begin_tr(req);          // 开流
drive_transfer(req);                // 真正驱动接口
end_tr(req);                        // 收尾
seq_item_port.item_done();

// 事务类里:声明哪些字段进波形
class apb_txn extends uvm_sequence_item;
  rand bit [31:0] addr;
  rand bit [31:0] data;
  rand bit        write;
  `uvm_object_utils_begin(apb_txn)
    `uvm_field_int(addr,  UVM_ALL_ON)   // 宏内含 record 逻辑
    `uvm_field_int(data,  UVM_ALL_ON)
    `uvm_field_int(write, UVM_ALL_ON)
  `uvm_object_utils_end
endclass
monitor 侧的对称流程是:从接口上还原出事务后调 accept_tr(tr)(monitor 用 accept 而非 begin,因为它不是事务的发起方,只是确认「我在这个时间点观察到一笔完整事务」),然后 end_tr 收尾。accept 和 begin 在波形里的语义略有区别:begin 表示「我开始主动发起」,accept 表示「我在此刻确认收到」,Verdi 里两者画出的时间锚点不同,调试乱序协议时这个区别有用。
除了单事务的起止,recording 还能表达事务之间的关系。begin_child_tr 用来录子事务——比如一笔 bursting 写被拆成四个 beat,父事务色块里嵌四个子色块,层次关系在调试器里可以折叠展开;add_relation 用来给两条流上的事务画关联线——比如 request 事务和 response 事务分属 driver 流和 monitor 流,一条关系线把配对关系直接画出来,调乱序响应协议时不用自己对 ID。这两个 API 用的人少,但在 AXI 这类多 outstanding 协议上收益极大,值得在公共 driver 和 monitor 基类里统一加上。
这张时序图回答「一笔事务在波形里的色块是怎么来的」:driver 的 begin 和 end 决定色块宽度,monitor 的 accept 打上观察锚点。有一个高频翻车点要记牢:begin_tr 之后忘了 end_tr(比如中途 raise objection 失败跳出、或异常路径直接 return),波形库里会留下一条永远不关闭的流,调试器里表现为一根拖到仿真结束的巨长色块,把同接口其他事务全压在底下。纪律:begin 和 end 必须成对出现在所有退出路径上,拿不准就用 UVM 库代劳的标准流程,别手写裸调用。
三、手工录制:do_record 与字段属性
字段宏能覆盖八成需求,剩下两成要靠 do_record 手工录。典型场景有三种:字段是动态数组或队列,宏录出来的内容不可读,你想按元素逐个录成子字段;字段需要换算后展示(比如把 32 位地址拆成「通道号 + 偏移」两列录,调试时一眼看出落在哪个从设备);要录的不是事务成员而是派生量(比如地址对齐标志、本次传输的 beat 数估算)。
function void apb_txn::do_record(uvm_recorder recorder);
  super.do_record(recorder);
  `uvm_record_field("addr", addr)
  `uvm_record_field("data", data)
  // 派生量手工录:调试时比原始位段直观
  `uvm_record_field("slave_id", addr[31:28])
  foreach (payload[i])
    `uvm_record_field($sformatf("payload_%0d", i), payload[i])
endfunction手工录制要守两条纪律。第一条,do_record 里不许有随机性和副作用——它可能被调用多次(不同流、不同时刻),里面做累加或者改状态,后果是同一事务在不同流里录出不同值,追查起来极其痛苦。第二条,字段数量要有节制:每多录一个字段,波形库里多一笔序列化数据,一个高频接口的 monitor 录二十个字段和录五个字段,长回归下来的波形文件体积能差出数倍。取舍原则:录「调试时第一眼要看的」字段,深字段靠抓到嫌疑事务后重跑加 verbosity 补,uvm_report verbosity 控制 讲的就是这条互补路径。和字段自动化宏相关的取舍,uvm_field 宏的代价 有专门讨论。
| 录制方式 | 适用字段 | 代价 | 可读性 |
|---|---|---|---|
uvm_field_* 宏 | 标量、位段、字符串 | 低(宏统一处理) | 默认格式 |
| do_record 手工 | 数组、派生量、需换算字段 | 中(按调用次数线性) | 自定义格式 |
| 不录 重跑补 verbosity | 深字段、低频字段 | 零(平时)加重跑成本 | log 文本 |
四、调试工作流:波形事务流和文本 log 怎么分工
transaction recording 最大的价值不在「能看」,而在改变了调试的分诊路径。没有它时,debug 一个传输错误的典型路径是:grep log 找到出错事务的时间戳,打开波形跳到该时刻,对着几十个信号人工做协议解码,解码错了再跳。有了它之后路径变成:grep log 找到出错事务的 ID 和时刻,波形跳到该时刻,直接在时间轴上看那条事务色块,字段值点开就有,上下游两条流(driver 流出、monitor 流入)并排对齐,哪一环丢了、延迟了多少拍一目了然。协议解码这一步从人脑挪到了 testbench——本来 monitor 就在做解码,recording 只是把解码结果顺手存下来。
两条通路的分工经验法则:定位「哪笔事务」用 log,看清「这笔事务在现场」用波形。log 强在可搜索、可统计、可跨 test diff(验证环境调试方法论 讲的分诊流程以 log 为入口);波形事务流强在时间对齐和现场还原,特别是三类 bug:时序类(事务发出去了但对端很久才响应,波形上两条色块之间的空白直接量出延迟拍数)、乱序类(多笔 outstanding 事务的完成顺序,色块的重叠关系一眼可见)、丢失类(driver 侧有色块、monitor 侧没有,丢在哪一跳对着接口信号看即可)。scoreboard 报 mismatch 时的对齐分析也是同一套路,UVM scoreboard trace 对齐 讲的是这条线的另一半。
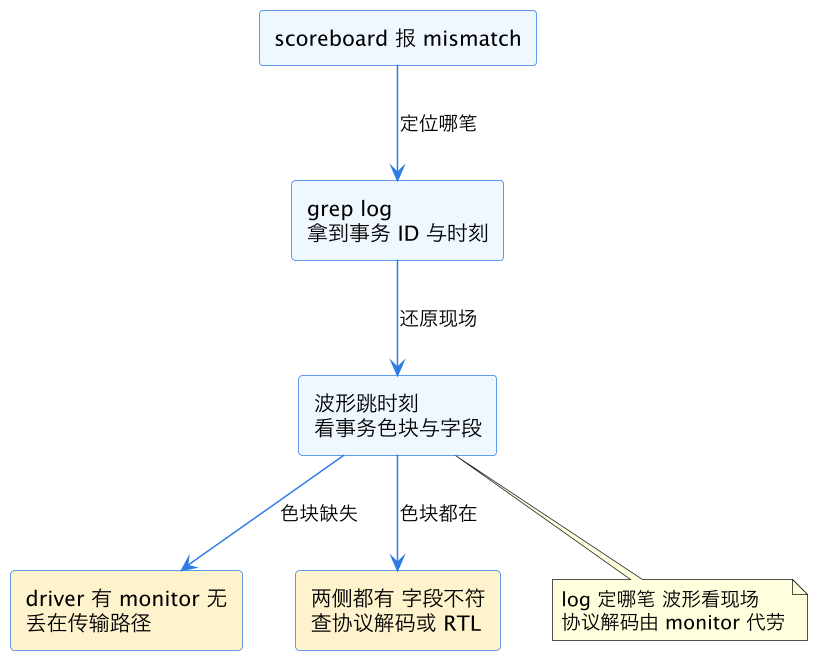
这张图是日常分诊的决策树。注意它没有替代信号级波形——r1 分支「丢在传输路径」之后,还是要落到接口信号上去看握手。recording 的价值是把「从报错到嫌疑接口」这一段从几十分钟压到几分钟。
五、性能开销:钱花在哪、怎么省
transaction recording 不是免费的,开销花在三个地方。第一是调用开销:每笔记事务的 begin、record、end 都是若干次 PLI 或 DPI 调用进波形库,一个高频 monitor 每秒仿真时间录几万笔,调用本身就能吃掉仿真吞吐的百分之十到二十。第二是序列化开销:字段越多、数组越大,每个字段的格式化和写盘越贵。第三是波形文件体积:长回归录全量事务,FSDB 膨胀数倍,磁盘和调试器打开速度都受害。三部分叠加,粗放地「全环境 UVM_FULL 开录」跑 nightly 回归,仿真慢一半、波形盘爆掉都不是传说。
控制手段按粒度从粗到细排成四级。环境级:nightly 回归默认 UVM_OFF 或 UVM_LOW,只在 debug 重跑时开——这是最常用也最有效的一招,失败 test 自动带 +UVM_RECORDING 重跑一次的流水线值得每个项目搭。组件级:recording_detail 按组件路径配置,只给嫌疑接口的 agent 开 HIGH,其余 OFF,用 config_db 的通配作用域一行搞定,uvm_config_db 通配作用域 讲了配置怎么精确打到目标组件。字段级:上一节的取舍,少录深字段。时间级:只在关心的时间窗内开关(比如只在某笔大 DMA 传输期间),用 run phase 里动态改 recording_detail 实现,用得少但救急有效。
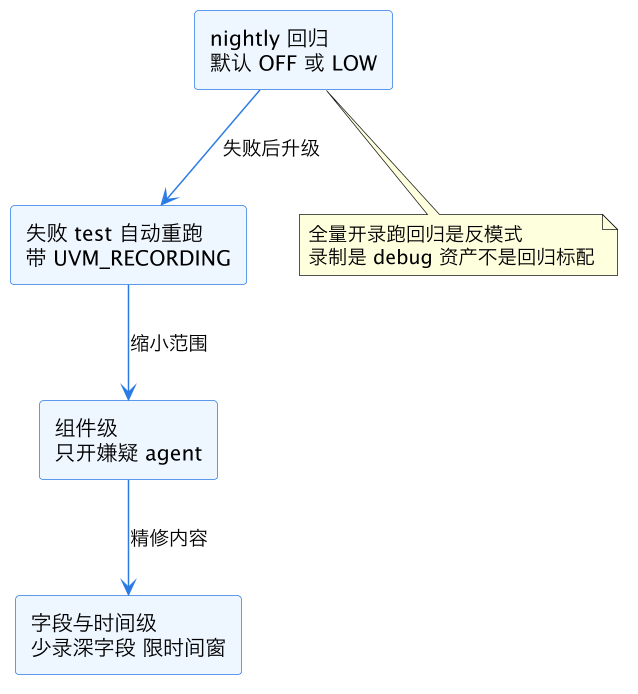
给一个量级的直观感受:某 APB 校验环境的实测里,monitor 每秒仿真时间广播约两万笔事务,UVM_LOW 只录起止和三个核心字段时仿真吞吐下降约百分之八;同一接口开 UVM_FULL 全字段录制,吞吐下降接近百分之四十,波形文件从 2GB 涨到 11GB。这个差距足以让 nightly 回归从六小时变成八小时以上,排队资源全部被打乱。所以「开销控制」不是优化选项,是回归流程的准入条件。
还有一条环境约束:跑仿真加速和硬件仿真(emulator)时,transaction recording 的可用性和开销模型完全不同,多数 emulator 流程对 PLI 录制支持有限或代价极高,纪律是仿真侧该录录、emulation 侧关掉,靠 testbench 内部的断言和触发逻辑替代现场捕捉,emulation prototyping simulation 选型 讲了三种平台的调试手段差异。下表把开销来源和手段对一遍:
| 开销来源 | 量级 | 首选手段 |
|---|---|---|
| begin 和 end 调用 | 每笔固定 | 回归默认 OFF 失败重跑开 |
| 字段序列化 | 随字段数线性 | 只录第一眼字段 深字段不录 |
| 波形文件体积 | 随时长和频率 | 组件级与时间窗级开关 |
| 调试器打开变慢 | 体积的下游效应 | 分接口分 test 落盘 |
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 调试线的一篇 S 层深文,主关键词 UVM transaction recording。向上承接 UVM 组件与 phase 的组件骨架与 UVM sequence driver scoreboard 的事务流链路,把「事务离开组件之后还能留下什么痕迹」这一环补齐。横向与文本通路的三篇互为镜像:uvm_report verbosity 控制(log 详略)、uvm report server 定制(log 落盘与格式)、验证环境调试方法论(分诊总流程);录制配置依赖 uvm_config_db 通配作用域,字段取舍呼应 uvm_field 宏的代价。向下,录出的波形现场喂给 UVM scoreboard trace 对齐 的失配分析和 后硅 bringup 调试 前的仿真侧预演。
总结
UVM transaction recording 是通过 uvm_recorder 和 recording_detail 配置把 driver 和 monitor 里流动的事务录进波形数据库的机制:begin_tr 开流、end_tr 收尾、字段靠宏或 do_record 录属性,调试器把时间轴上的事务色块和信号波形对齐展示,让协议解码从人脑挪回 testbench;它与文本 log 的分工是「log 定哪笔、波形看现场」,失配分诊从几十分钟压到几分钟;代价是每笔固定调用开销加字段序列化开销加波形体积,控制纪律只有一条主线——回归默认关掉、失败自动带录制重跑、再按组件和字段逐级收窄,录制是调试资产不是回归标配,全量开录跑 nightly 是反模式。