MoD 混合深度推理:按 token 动态分配计算深度如何省 FLOPs 降延迟
更新时间:2026-10-05。站内讲推理省算力的路线已经有好几条:早退与层跳过推理 讲「整条序列提前离开网络」,MoE 细粒度专家设计 讲「每个 token 只激活少数专家」。这两条路线一个按样本切、一个按参数切,而本篇主角 MoD(Mixture-of-Depths,混合深度)走的是第三条路:在同一个 batch 内、同一层上,按 token 决定谁值得做一次完整的 attention 加 FFN 计算,剩下的直接从残差旁路滑过去。它出自 DeepMind 2024 年的论文《Mixture-of-Depths: Dynamically allocating compute in transformer-based language models》,思路朴素得让人意外——「不是每个 token 都值得想那么久」——但落到推理系统上,它牵动的 FLOPs 账、KV cache 账和 kernel 调度账都不简单。读懂这一篇,你就拿到了理解「动态计算深度」这一整个家族的钥匙。
本文要回答的问题
- MoD 的路由机制到底是什么:router 怎么打分、top-k 怎么选、被选中和没被选中的 token 各走什么路径?
- 它和早退(early exit)、MoE 的本质区别在哪,三条省算力路线怎么选?
- 容量(capacity)定小了会怎样,FLOPs 节省和精度损失之间的交换曲线长什么样?
- 推理侧落地有哪些硬约束:KV cache 怎么办、batch 内 token 数不齐怎么办、因果解码怎么做 top-k?
- 对推理延迟和吞吐的真实影响是多少,什么场景值得上 MoD?
一、问题的起点:稠密 Transformer 对每个 token 一视同仁
标准稠密 Transformer 的计算分配方式极其「平均主义」:一个 batch 里有 512 个 token,第 i 层就对 512 个 token 全部做一遍 attention 和 FFN,无一例外。但稍微想想就知道这不合理——一句话里「的」「是」「,」这类功能 token,和决定句义走向的关键词,对下一层表征的贡献完全不是一个量级;一段代码里的括号缩进,和核心变量名,需要的「思考深度」也不该一样。人类阅读时会略读和精读,稠密模型却把每个 token 都精读了一遍。
这个浪费有多大?原论文给的观察是:在语言建模任务上,相当比例的 token 即使跳过很多层的计算,对最终 loss 的影响也在噪声量级。换句话说,稠密模型的 FLOPs 里有可观的一部分花在了「不值得算」的 token 身上。这正是所有动态计算路线的共同动机,分歧只在「按什么粒度砍」。

上图把 MoD 的核心动作画成了一句话:把「哪些 token 值得算」从隐式(学在权重里)变成显式(每层一次路由决策),用路由开销换掉大部分的计算开销。接下来拆开看这个路由怎么做。
二、路由机制:每层一个 router,top-k 选中的走全路,其余的走旁路
MoD 的结构改动非常小,小到可以在任何现有 Transformer 层上「外挂」:在每一层(或每隔一层)的输入处加一个轻量 router——通常就是一个线性投影,把每个 token 的隐藏向量映射成一个标量分数。然后对这一层参与路由的所有 token 按分数排序,取 top-k(k 是预设的容量 capacity,比如总 token 数的 12.5%),被选中的 token 正常过这一层的 attention 和 FFN,没被选中的 token 什么都不算,隐藏状态原封不动经残差连接传到下一层。
注意这里和 MoE 的一个关键区别:MoD 不是「选哪个专家算」,而是「算不算」。所以它的输出合并也不需要加权和——被选中的 token 得到更新后的表示,没被选中的 token 保持原样,两条路径在序列维度上重新拼回完整 batch,进入下一层。
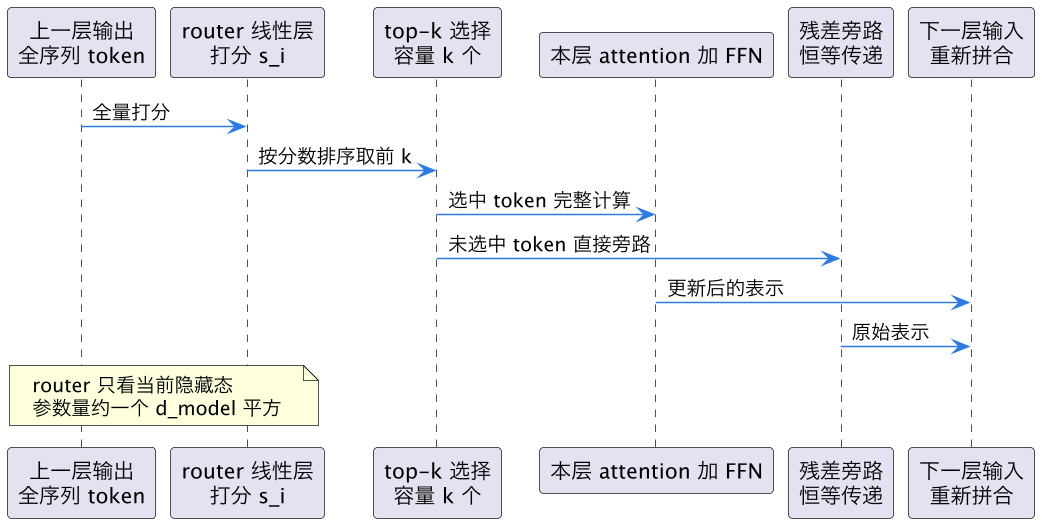
这个时序图里藏着 MoD 最重要的工程性质:路由决策只看当前 token 自己的隐藏状态,不需要看未来。这意味着它是因果安全的——自回归解码时,当前 token 是否被选中不依赖还没生成的 token,不会出现「训练时能 top-k、推理时选不齐」的断裂。原论文还讨论了两种路由变体:token-choice(每个 token 自己决定走不走,类似上面的描述)和 expert-choice 风格的容量控制;推理友好的恰恰是让每层固定处理恰好 k 个 token 的形式,因为k 固定意味着每层的计算量是静态可知的,这对 kernel 调度和显存规划是天大的好消息,下一节展开。
router 本身的开销可以忽略:一个 d_model 维到 1 维的投影,相对一层 attention 加 FFN 的 FLOPs 不到千分之一。真正的代价在训练——router 的分数不可微(top-k 是硬选择),论文用 straight-through 估计加辅助损失让分数能收到梯度,这是训练侧的话题,推理侧只需要知道:router 是训练时学好的,推理时它就是一个便宜的打分器。
三、和早退、MoE 的边界:三条路线砍的是不同的维度
动态省算力这个大家族里,MoD 经常被拿来和早退、MoE 混为一谈,三者其实砍在不同维度上,组合使用也互不冲突。先用一张表把边界钉死。
| 维度 | 早退 / 层跳过 | MoE 稀疏专家 | MoD 混合深度 |
|---|---|---|---|
| 决策粒度 | 整条序列(或整样本) | 每个 token 每一层 | 每个 token 每一层 |
| 砍的是什么 | 层数:后面几层不跑了 | FFN 宽度:只激活少数专家 | 层内参与 token 数:只有 top-k 算 |
| 决策问法 | 这个样本够简单了吗 | 这个 token 该找哪个专家 | 这个 token 值得在这一层算吗 |
| 每步计算量 | 动态(早退位置不固定) | 静态(激活专家数固定) | 静态(容量 k 固定) |
| KV cache 影响 | 无(整层跳过则无该层 KV) | 无(attention 照常全量) | 有(未选中 token 无该层 KV) |
| 推理调度友好度 | 差(batch 内早退点不齐) | 中(专家均衡是老大难) | 好(每层 token 数恒定) |
| 与其他路线组合 | 与 MoE 正交 | 与早退正交 | 可与 MoE 叠加(MoDE) |
三个值得展开的点。第一,MoD 和 MoE 是正交的:MoE 稀疏的是 FFN 的参数维度(每个 token 用哪几个专家),MoD 稀疏的是 token 维度(哪些 token 进 FFN 和 attention),论文里甚至给出了两者叠加的 MoDE 变体——先按 token 路由砍一遍,再在选中的 token 上按专家路由砍一遍,FLOPs 节省可以叠乘。站内 MoE 细粒度专家设计 讲的专家均衡问题在 MoD 这里不存在,因为 MoD 的容量是硬性 top-k,天然均衡。
第二,MoD 比早退更细也更稳。早退的决策单位是整个样本(或整个序列位置集体退出),一个 batch 里不同样本在不同层退出,kernel 侧就要处理形状不齐的批;MoD 每层都精确处理 k 个 token,形状恒定,只是每个 step「谁在这 k 个里」在变。对 GPU 来说,恒定形状意味着 GEMM 尺寸恒定、tile 划分可以预编译、kernel 选择不用每步重来,这是 MoD 相对早退最大的系统工程优势。
第三,KV cache 是 MoD 特有的坑。没被某层选中的 token,在这一层不产生新的 K、V;后续层的 attention 如果还想看到它,看到的是「最后一次被选中时」写入的 K、V。这实际上让 KV cache 也变成了稀疏的——每个 token 的 KV 只在它被路由选中的那些层存在。这带来一个意外的红利:KV cache 的显存占用也跟着容量系数一起缩,在 KV cache 推理显存 讲过的显存账本里,MoD 模型的 cache 项可以按容量比例打折,对长上下文场景是双重收益。
四、FLOPs 与延迟的账:容量系数是唯一旋钮
MoD 的 FLOPs 账非常好算。设容量系数 c = k / N(N 是每层参与路由的 token 数),那么被路由层的计算量变为原来的 c;如果每隔一层做路由(论文常用配置),总 FLOPs 大约是稠密模型的 (1 + c) / 2。取 c = 12.5%、半数层路由,总 FLOPs 约为稠密的 56%——论文的招牌结果是:相同 FLOPs 预算下 MoD 模型追平甚至超过稠密基线,或者说相同精度下推理 FLOPs 省 40% 以上,而每步前向的实际耗时(wall-clock)也同步下降,因为省的恰好是 GEMM 这种实打实的矩阵乘。
延迟侧的收益比 FLOPs 侧还要好一点,原因是旁路 token 不只是省了矩阵乘,还省了这一层的 KV 写入和 attention 参与——decode 阶段每步只生成一个 token,但 prefill 阶段(处理 prompt)是成百上千 token 一起过每一层,MoD 在 prefill 上的加速是直接的:一层只算 12.5% 的 token,GEMM 的 M 维(token 维)缩到八分之一,这一段的时间就近似缩到八分之一。decode 阶段每步只有一个新 token 要路由,单 token 场景下 MoD 的决策退化为「这个 token 在这一层算还是不算」,省的是整层的 attention 加 FFN 或者一分不省——所以 MoD 的主要延迟红利在 prefill 和长生成中「回看历史」的部分,纯单 token decode 的收益要看 KV cache 缩水带来的显存带宽节省。

容量系数怎么定?这是 MoD 唯一的精度-效率旋钮,论文的扫描实验给出的经验是:c 从 100%(稠密)降到 25% 几乎不掉点,降到 12.5% 开始有可感知损失,低于 6% 掉得明显。直觉解释是:一个序列里真正「需要深层思考」的 token 占比大概就在一到两成,容量给到这个水位就接住了大部分关键计算。工程上定容量还有一层考虑——c 最好取硬件友好的分数(1/8、1/4),让 GEMM 的 M 维保持 tile 对齐,否则 12.5% 省下来的 FLOPs 会被 padding 浪费掉一部分。
把账收成一张表,按 7B 级模型、隔层路由、c=12.5% 的典型配置估算:
| 指标 | 稠密基线 | MoD(c=12.5% 隔层) | 变化 |
|---|---|---|---|
| 每 token 前向 FLOPs | 1.0x | 约 0.56x | 省 44% |
| prefill 每层 GEMM 耗时 | 1.0x | 路由层约 0.125x | 显著下降 |
| KV cache 显存 | 1.0x | 路由层约 0.125x | 长上下文大利好 |
| router 额外开销 | 无 | 低于 0.1% | 可忽略 |
| 精度(等 FLOPs 对比) | 基线 | 追平或略优 | 论文实测 |
| kernel 调度复杂度 | 低 | 低(形状恒定) | 基本持平 |
五、推理落地的硬约束与适用场景
账算得漂亮,落地时还有几个坑要心里有数。
第一个是 gather 加 scatter 的开销。每层路由后,要把 top-k 的 token 从 batch 里「挑出来」送进 GEMM,算完再「撒回去」。这个 gather/scatter 在序列维度上做,本质是显存里的一次重排。N 大、隐藏维度大的时候,这次重排的显存带宽开销不能忽略——如果实现不好,省下的 GEMM 时间被重排吃掉一截。工程对策是把 gather 融合进 attention 的索引(attention 本来就按索引取 KV,顺便按索引取 Q 几乎免费),scatter 融合进残差加的 kernel,避免单独一轮全量读写。
第二个是 训练-推理一致性。MoD 模型必须用 MoD 结构从头训练(或至少在相当长的训练段里带着 router 练),把一个训好的稠密模型硬套路由基本是废的——没被训练跳过计算的 token,突然不让它过某些层,表征立刻崩。这和 投机解码推理 那种「不动原模型、外挂小模型」的路线完全不同,MoD 是一个训练侧决策,推理框架只需要支持「按容量截断加索引重排」两个原语。
第三个是 batch 维度的交互。prefill 时多个请求的 prompt 拼在一个 batch 里,top-k 是在「整个路由集合」上选的——如果按请求各自选,容量就对不齐。主流做法是把同一 batch 内所有路由 token 拉平一起选,k = c 乘以总 token 数,这样长短不一的请求共享一个容量池:长 prompt 里的功能词会把容量让给别的请求里的关键词,这反而是更符合直觉的资源分配。
什么场景值得上?一句话:算力受限、且能接受从头训练(或用已发布的 MoD 权重)的场景。具体说,端侧和边缘推理(每焦耳算力都要省)、高并发 serving(prefill 吞吐直接决定 TTFT 和整体容量)、长上下文应用(KV cache 双重缩水)是三个最对口的战场。反过来,如果你只能微调现有稠密模型、或者模型规模小到 router 噪声都压不住,MoD 就不是你的菜——那种情况早退或量化更现实。

这一篇在知识体系里的位置
本篇是推理优化家族里「动态计算深度」一支的奠基篇。同族的对照阅读:早退与层跳过推理 是按样本粒度砍层数的兄弟路线,MoE 细粒度专家设计 是按参数维度砍 FFN 的正交路线(两者可与 MoD 叠加成 MoDE),mixture-of-experts 路由 讲的路由器训练技巧(负载均衡、辅助损失)在 MoD 的 router 上同样适用。省算力的其他支柱:投机解码推理 砍的是串行步数、KV cache 推理显存 和 KV cache 量化 INT4 砍的是显存与带宽,与 MoD 的「砍参与 token 数」三条腿互补。阅读顺序建议:先搞懂 MoE 路由的打分加 top-k 范式,再看本篇理解「算不算」与「找谁算」的差别,最后回到早退篇对比三种粒度的工程取舍。
总结
MoD 混合深度推理在 Transformer 每一层加一个极轻的 router,按 token 隐藏态打分取 top-k(容量系数 c 常取 12.5%),被选中的 token 走完整 attention 加 FFN、其余经残差旁路直达下一层,用每层恒定形状的稀疏计算换掉稠密模型「人人有份」的浪费:等 FLOPs 下精度追平稠密基线、等精度下推理 FLOPs 省四成以上,prefill 耗时与 KV cache 显存随容量系数同步缩水,且因果安全、kernel 形状恒定、可与 MoE 正交叠加——代价是必须带着路由从头训练,以及每层一次 gather/scatter 重排开销,适合高并发 serving、长上下文和端侧算力受限三类场景。