软硬件划分:性能、灵活性、成本、功耗的四维判据与决策流程
做 SoC 或嵌入式系统设计,迟早会撞上同一个问题:这个功能,是画成数字逻辑交给硬件跑,还是写成代码交给处理器跑?这个取舍就是软硬件划分(Hardware/Software Partitioning)。它是模块划分的原则在「用什么形态实现」这个轴向上的延伸,也是 FPGA 与 CPU/GPU 的本质差异落到具体工程决策上的样子。划得好,芯片又快又省电还能赶进度;划得差,要么硬件面积爆炸、要么软件跑不动,流片之后再想改就晚了。
本文要回答的问题
- 软硬件划分到底在分什么?同一件功能,硬件实现和软件实现差在哪?
- 判断一个功能「该给硬件做」的四个维度是什么,各自的判据怎么量化?
- 拿到一个新需求,按什么流程一步步收敛出划分结论?
- 用一个真实案例(UART 波特率产生器)走一遍:硬件计数器方案和软件定时器方案,谁赢、赢在哪?
一、软硬件划分到底在分什么
一个系统功能,比如「算一次 CRC 校验」「产生一个 115200 波特的位时钟」「响应一次按键中断」,本质上都是一组输入到输出的映射。硬件实现的意思是:用触发器、计数器、状态机把这些映射固化成电路,每个时钟周期电路自己往前走,不占处理器一条指令。软件实现的意思是:处理器按程序计数器一条一条取指执行,用通用的算逻单元去模拟出同样的映射。
两条路的差别可以用一句话概括:硬件是「为这一个功能专门造一台机器」,软件是「用一台通用机器去扮演这个功能」。专用机器快、省、但造完就定型;通用机器慢一些、费一些,但换个程序就换个角色。下面这张三栏对比卡把两种纯路线和工程上最常见的混合路线放在一起看。
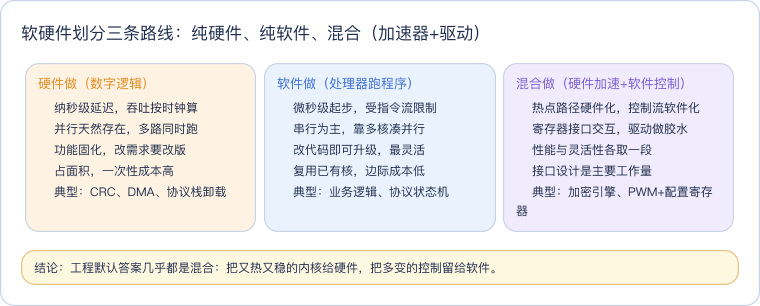
读这张卡抓住一条主线:三栏不是三个互斥的阵营,而是同一条光谱上的三个采样点。左边硬件栏的关键词是「快但定死」,右边软件栏是「慢但好改」,中间混合栏是绝大多数真实芯片的落点——硬件负责数据通路里那段最热、最稳定的部分,软件负责控制面里最爱变的部分。后面三节就是讲怎么判断「热不热、稳不稳」。
为了建立直觉,先把常见功能按形态对号入座一遍:
| 系统功能 | 常见实现形态 | 划分理由(一句话) |
|---|---|---|
| CRC / 校验和 | 硬件 | 位流规整、每包都算、协议冻结 |
| DMA 数据搬运 | 硬件 | CPU 逐字搬是纯粹的指令浪费 |
| AES / RSA 加解密 | 硬件加速器 + 软件调度 | 内核运算热且稳定,密钥管理多变 |
| 网络协议栈 | 软件为主,校验卸载给硬件 | 状态机复杂多变,逐包校验热 |
| 按键消抖 / LED 呼吸 | 皆可,看引脚与余量 | 频率极低,谁闲谁做 |
| 业务状态机 / 配置管理 | 软件 | 分支多、需求常年在改 |
这张表不需要背,它的作用是校准感觉:落在左侧形态的(规整、高频、稳定)几乎总是硬件,落在右侧的几乎总是软件,中间那行「皆可」正是下一节判据要处理的灰区。
二、四维判据:性能、灵活性、成本、功耗
划分决策可以拆成四个维度逐个打分。每个维度都问一个具体问题,答完四个问题,结论基本自己浮出来。
性能维度:这个功能每秒要做多少次? 这是最硬的判据。软件在通用核上一次有意义的操作(比如一次 32 位运算加一次存储)量级是几条到几十条指令,即便 1 GHz 主频,单核每秒能完成的「功能点」也就在千万到亿级。一个功能如果调用频率达到每秒百万次以上,或者对单次延迟有纳秒级要求(比如总线应答),软件方案基本出局。反过来,一秒几次的温湿度读取,给软件做都嫌浪费。
灵活性维度:这个需求未来三年会改几次? 协议还在草案阶段、算法参数要现场调、客户各要一个变体——这些信号都指向软件。硬件一旦综合成门级网表(流程见 RTL 到门级:综合发生了什么),任何修改都意味着重新验证甚至重新流片;软件改一行代码重新烧录就行。
成本维度:量多大? 这里有个反直觉的点:硬件的「贵」是一次性的(设计、验证、掩膜),软件的「贵」是持续的(每颗芯片都要一颗足够强的核和足够的内存)。年出货量百万级的产品,摊薄后硬件化往往更便宜;几千套的小批量工业设备,多写点软件比多开一块硅划算得多。
功耗维度:能量预算卡多死? 专用电路完成同样的计算,能耗通常比通用处理器低一到两个数量级——因为省掉了取指、译码和通用数据通路的开销。电池供电、无风扇散热的场景,功耗维度经常一票否决软件方案。
把四个维度整理成一张判据矩阵,实际评审时可以直接照着逐行过:
| 判据 | 偏向硬件做的信号 | 偏向软件做的信号 |
|---|---|---|
| 调用频率 | 每秒百万次以上,或纳秒级延迟要求 | 每秒千次以下,毫秒级可接受 |
| 数据形态 | 规整的位/字节流,可并行、可流水 | 复杂分支、指针跳转、不规则控制流 |
| 需求稳定性 | 标准已冻结(如 CRC32、AES) | 协议草案期、参数要现场调 |
| 出货量 | 百万级以上,摊薄一次性成本 | 小批量,边际成本敏感 |
| 功耗预算 | 电池/无风扇,能耗卡死 | 市电供电,散热充裕 |
| 人力与进度 | 有成熟 IP 或可参考设计 | 硬件团队排期满,软件有富余 |
这张表的用法不是数勾,而是看有没有「硬约束行」——比如调用频率那一行如果落在硬件侧且差距悬殊,后面几行就不用吵了。只有当各行信号互相打架(比如频率偏高但需求不稳),才需要进入下一节的流程做权衡。
三、一张可照走的决策流程
把四维判据串成决策流程,核心思路是先用硬约束筛掉不可能的,再在剩下的空间里按灵活性需求排序。下面这张图按节点角色上了色:蓝色是输入需求,红色是关键判定,绿色是「软件做」的结论分支,橙色是「硬件做」的结论分支,紫色是混合划分的收尾动作。读图时从顶部进入,每个红色菱形只回答一个是非题,任何一步拿到确定答案就可以直接出图。
这张图有三个值得停留的地方。第一,第一个判定(频率/延迟)是唯一的一票否决项,放在最前面,因为它纯粹由物理决定、没得商量。第二,「需求稳不稳定」这个判定看似走向「软件做」,实际作用是决定要不要为未来的变体留接口——稳定的低频功能给软件做就完了,不稳定的低频功能做软件时也要把接口抽象好。第三,无论走到橙色还是紫色终点,最后都要落到「定义软硬件接口」这一步:寄存器映射怎么排、中断怎么报、要不要配 DMA 通道。接口设计的好坏,往往比划分本身更影响项目的最终成败,这也是低延迟系统里反复强调的边界设计思想(可参考低延迟设计模式里对边界与队列的处理)。
四、案例推演:UART 波特率产生器
理论说完,拿一个几乎每个 SoC 都有的真实模块走一遍:UART 的波特率产生器。任务很明确——从系统时钟分频出 16 倍于波特率的采样时钟,比如 50 MHz 时钟下要产生 115200×16 ≈ 1.8432 MHz 的使能脉冲。
方案 A:硬件计数器。 用计数器与移位寄存器里的基本件:一个可加载的分频计数器,数到终端值就输出一个时钟使能脉冲并自动重载。分频系数写在配置寄存器里,软件想换波特率只写一个寄存器。电路一旦综合好,产生脉冲这件事零处理器开销,抖动为零,CPU 睡眠时它照常工作。
方案 B:软件定时器中断。 用通用定时器每 542 ns 左右中断一次,在中断服务程序里翻转 GPIO 或驱动发送状态机。粗看可行,算一笔账就露馅:每秒 184 万次中断,每次中断的进出开销按 50 条指令、50 ns 估,单这一项就吃掉 9% 以上的 CPU;更致命的是中断延迟有抖动——高优先级中断一打岔,位时钟边沿就漂移,UART 采样点跟着跑偏,误码率上升。
按四维判据打分:
| 维度 | 硬件计数器 | 软件定时器中断 | 胜出 |
|---|---|---|---|
| 性能 | 每 542 ns 一个脉冲,零抖动 | 同样频率下 9% CPU 占用,抖动随负载 | 硬件 |
| 灵活性 | 改波特率写寄存器,同样灵活 | 改中断周期常数,略灵活但无实质优势 | 平 |
| 成本 | 几十门电路,面积可忽略 | 占用一颗定时器外设加 CPU 时间 | 硬件 |
| 功耗 | 纳安级漏电流增量 | CPU 无法深睡,毫安级差距 | 硬件 |
四维全部倒向硬件,这就是教科书级的「该给硬件做」:功能频率高、形态规整(纯计数)、需求极稳定(UART 协议几十年没变过)、硬件成本又极低。现实里的所有 UART 外设也确实是这么做的。这个案例的反面教材价值在于:凡是「周期性、高频次、时序敏感」的功能,软件方案都会在抖动和占用率上双重失血,这类信号在需求评审时就该直接触发硬件化。
反过来,如果任务换成「收到一帧数据后解析 Modbus 协议并更新业务状态」,判据就全部反转:调用频率低(帧间隔毫秒级)、控制流复杂(CRC 校验、地址匹配、功能码分发)、协议可能随客户改——这是标准的软件领地,硬件只负责把字节可靠地搬进缓冲区、发一个中断,剩下的交给固件。一个 UART 子系统内部,就这样同时住着两种划分的结论。
五、常见误区与一条实用口诀
划分讨论里反复出现的误区有三个。一是「硬件一定快」——硬件化的是数据通路,如果功能本身瓶颈在访存或外设响应,电路再快也等在那里,先把瓶颈画像画准再谈划分。二是「先软件后硬件,不行再改」——软件原型验证功能没问题,但「跑不动再硬化」的前提是接口一早按可硬化设计好,否则软件里随手写的全局变量和回调链,硬化时要连锅端重写。三是「划分是一次性决定」——其实它跟着产品生命周期走:初代产品赶进度多用软件,量起来之后把热点逐步硬化降本降功耗,很多芯片的二三代版本干的就是这件事。
一句话口诀收束全篇:热点、规整、稳定的功能给硬件,复杂、多变、低频的功能给软件,拿不准就先定义好寄存器接口,把决定权留给下一代。
这一篇在知识体系里的位置
本篇属于芯片设计入门线,讲「一个功能用什么形态实现」的决策方法。向上承接模块划分的原则(先把系统切成模块,再决定每个模块的形态),横向关联 FPGA 与 CPU/GPU 的差异(两种计算形态的物理基础)与 RTL 到门级的综合流程(硬件实现落地的路径);文中用到的计数器电路见计数器与移位寄存器,接口与边界的低延迟设计思想可延伸到低延迟设计模式。
一句话总结
软硬件划分就是给每个功能判四个维度——调用频率高不高、需求稳不稳、量大不大、功耗紧不紧;高频规整稳定的功能(如 UART 波特率计数器)交给硬件又快又省,复杂多变的控制流留给软件保持灵活,而工程上的默认答案是混合划分:硬件做热点数据通路,软件做控制面,中间用一组定义清楚的寄存器接口缝起来。