层次化 STA 接口时序:ETM、ILM 与接口预算的取舍全解
在 E1 黄金 STA 里我们说过,PrimeTime/Tempus 是全芯片时序的最终裁判;但「全芯片 flatten 跑一遍」在 5 亿门以上的 SoC 上已经是个伪命题——内存吃不住、运行时间按天计、任何一个 block 改版都要全量回归。工程界的答案是层次化签核:每个 block 单独签干净,再给顶层提供一份「接口视角的替身」,顶层只拿着这些替身做集成时序检查。替身怎么做,就是层次化 STA 接口时序要回答的问题。业界有三条主流路线——ETM(Extracted Timing Model)、ILM(Interface Logic Model)和接口预算(interface budget),三者在精度、运行效率、维护成本上的取舍完全不同,选错了轻则顶层回归慢一倍,重则接口路径漏签在硅片上爆雷。本篇把三条路线讲透,给出可落地的选型框架;配合 GBA/PBA 分析模式 和 MMMC 多角签核 阅读,可以拼出完整的层次化签核图景。
本文要回答的问题
- 为什么 flatten STA 在大设计上跑不动?层次化签核把问题拆成了哪两半?
- ETM 到底提取了什么?它对哪些路径是精确的、对哪些是「黑盒近似」?
- ILM 比 ETM 准在哪里、贵在哪里?边界寄存器删不删的判定标准是什么?
- 接口预算这条「不算模型」的路线什么时候反而最实用?
- 三条路线怎么组合?选型决策看哪几个硬指标?
一、为什么必须层次化:flatten STA 的三座大山
一个 5 亿门的 SoC,flatten 之后 timing graph 节点数在十亿量级,单机内存直接破 TB 门槛;即便用分布式 STA 切开跑,一次全角全模式回归也要以天计。更致命的是迭代节奏:block 团队每天改 RTL、重跑 P&R,顶层不可能跟着天天全量回归——等顶层跑完,block 早就又变了。
层次化签核把这个大问题拆成两半:
- block 内部:block 团队用完整的约束、完整的 SPEF,把 block 内部所有 reg-to-reg 路径签到干净,这是他们的责任田;
- block 接口:block 对外只暴露「从输入端口到第一级寄存器」和「从最后一级寄存器到输出端口」这两段接口路径的时序特性,顶层拿这份抽象做跨 block 路径检查。
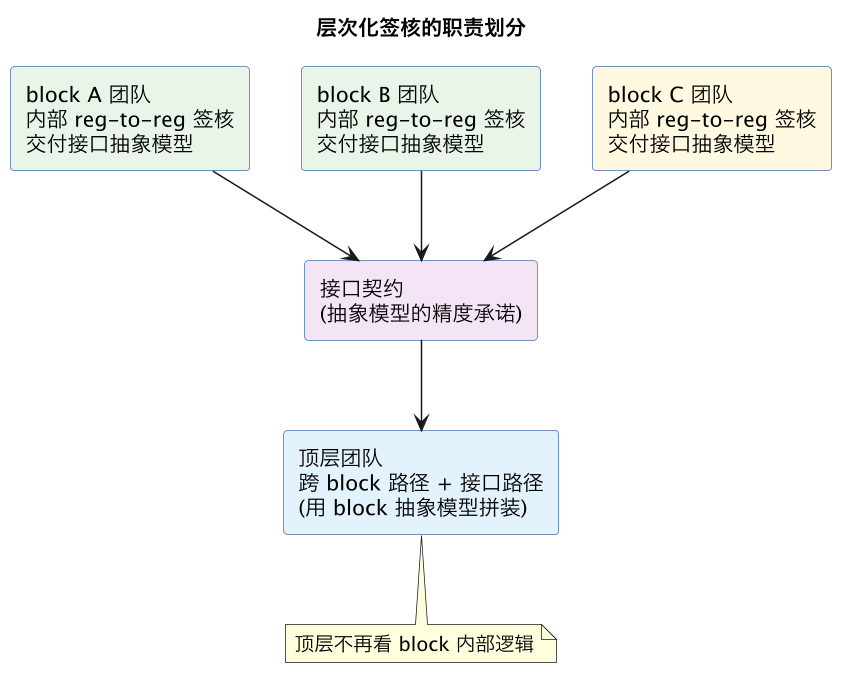
这张图的核心是中间那份「接口契约」:block 交付的抽象模型本质是一份精度承诺——它保证顶层用它算出的接口路径延迟与真实 flatten 结果的偏差在某个范围内。三种路线的区别,就是这份承诺的兑现方式和代价不同。拆分的代价是接口路径成了block 与顶层的「三不管地带」:block 只知道自己内部半段,顶层只看到抽象出来的另半段,两半拼起来是否等于真实延迟,完全取决于抽象方法保真度。
二、ETM:把 block 压成一张「端口真值表」
ETM(Extracted Timing Model,PrimeTime 里用 extract_model 生成,输出通常是 .lib/.db 格式的库单元)的思路最激进:把整个 block 当成一个超大号标准单元,只保留端口与端口、端口与内部寄存器时钟之间的时序弧(timing arc),内部逻辑全部扔掉。
生成过程是:STA 工具遍历所有接口路径,把每条「输入端口 → 寄存器 D 端」「寄存器 Q 端/时钟 → 输出端口」路径的延迟信息(含 slew 依赖、负载依赖的 NLDM 查表结构)压进模型。对顶层来说,这个 block 就是一个黑盒单元:给输入端口一个 arrival time 和 transition,查表算出到输出端口的延迟增量。
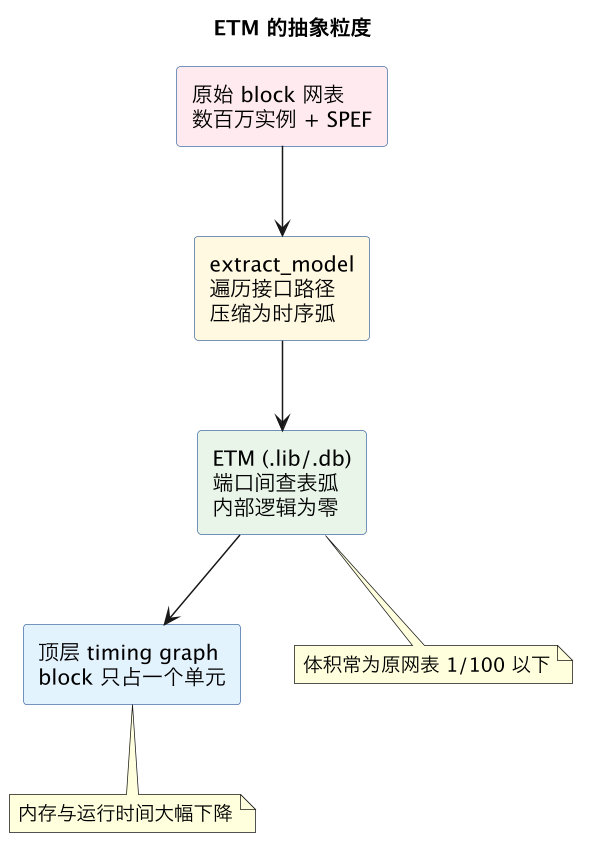
ETM 的优点几乎全在效率上:模型体积通常是原网表的百分之一以下,顶层内存和运行时间随之断崖式下降;而且它是标准 Liberty 格式,任何 STA 工具都能直接 link,不挑环境。对 IO-heavy、接口路径数量可控的 block(比如 DDR PHY 的外围 wrapper),ETM 是性价比之王。
但 ETM 的精度短板是结构性的,必须一条条数清楚:
- 上下文信息被冻结:生成 ETM 时的 SPEF 角、串扰环境(aggressor 开关状态)、时钟树延迟都被压进了表值里。顶层实际环境里接口 net 的负载变了、aggressor 翻转窗口变了,ETM 不会跟着变——它记得的是生成那一刻的世界;
- CRPR 被吃掉:公共时钟路径补偿(CRPR,详见 时钟重汇聚补偿)依赖时钟网络的拓扑共享信息,ETM 把内部时钟树抹掉之后,顶层无法知道 block 内外时钟路径的真实公共段,只能用保守的 derate 补偿,接口路径悲观度被放大;
- 跨 block 的 PBA 无从谈起:GBA/PBA 里讲过,PBA 需要完整路径的图拓扑做重算,ETM 把路径折成一段弧,跨 block 关键路径只能停在 GBA 精度,靠 derate 补窟窿;
- 模式爆炸:多模式设计里 ETM 是「一生成一模式」,十个 mode-corner 组合就要十份 ETM,block 每改一版全部重生成,版本管理成本随 scenario 数线性上涨。
工程纪律上,ETM 适用判定是:接口路径简单(输入到一级寄存器路径短)、串扰环境稳定、顶层只做 GBA 集成检查的 block。先进节点带 SI 签核的顶层,用 ETM 必须配额外的接口 derate 预算(常见做法是接口路径加 5%-10% 的悲观余量),否则耦合电容上下文丢失会系统性偏乐观。
三、ILM:只删中间,留下完整的接口壳
ILM(Interface Logic Model)走的是另一条路:不抽象成真值表,而是物理地删除网表——把所有「既不在接口路径上、又不影响接口时序」的内部逻辑实例从网表和 SPEF 里剔掉,只保留:
- 输入端口到第一级寄存器、最后一级寄存器到输出端口的完整逻辑锥;
- 这些接口寄存器的时钟树(保证 CRPR 可以真实计算);
- 接口 net 的 SPEF 寄生(含耦合电容,aggressor 若在删除区则按地处理或保留端口)。
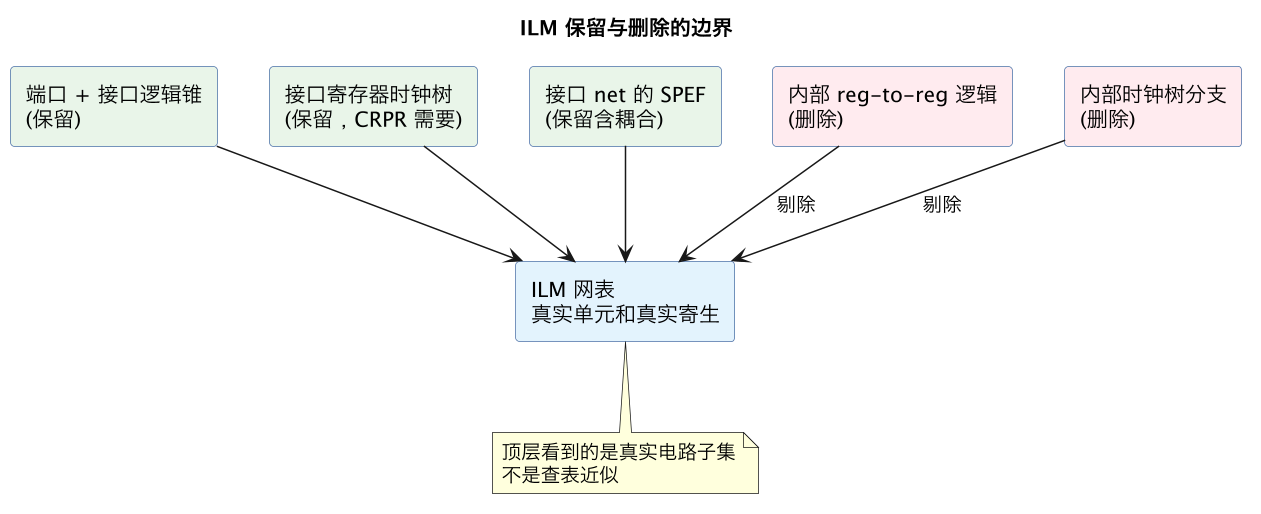
ILM 与 ETM 的本质差异一句话说清:ILM 里流的是真数据,ETM 里流的是冻住的查表值。由此带来一连串精度优势:
- 接口 net 的负载就是顶层真实负载,延迟随上下文实时计算,不存在「冻结世界」问题;
- 时钟树保留,顶层时钟与 block 时钟的公共段真实可见,CRPR 补偿精确,接口路径悲观度和 flatten 基本一致;
- 网表拓扑完整,跨 block 的 PBA 重算可以穿透 ILM 边界,关键路径能做路径级签核;
- 带 SI 分析时,保留的耦合信息让串扰增量延迟照常计算(边界 aggressor 精度略有损失,但远好于 ETM 的全丢)。
代价也实实在在:ILM 网表通常是原 block 的 10%-30%(接口逻辑锥多大决定下限),顶层内存和运行时间比 ETM 方案高一个量级;生成 ILM 需要同时处理网表与 SPEF 的同步删减(write_ilm 类命令会自动对齐,但 SPEF 裁剪失败是常见 bug 源);而且 ILM 仍然是分模式的,scenario 多了照样版本爆炸。
还有一个容易被忽略的坑:接口寄存器删除判据。ILM 工具默认保留「与端口有时序连接」的寄存器,但有些寄存器通过约束(case analysis、false path)被断开了与端口的时序关系,却在物理实现里仍影响接口 net 的布线寄生——删掉它们 SPEF 裁剪可能失真。工程上的对策是生成 ILM 后跑一次「ILM vs flatten」的接口路径对拍:抽 1000 条接口路径,延迟偏差超过阈值的反查删除边界,这个对拍必须进回归门禁。
四、接口预算:不算模型,用约束把问题切开
第三条路线最「原始」:根本不生成任何时序模型,而是在设计早期给每个 block 的每个接口分配时间预算——比如某条跨 block 路径总预算 1.2ns,block A 侧分到 0.5ns、block B 侧分到 0.5ns、顶层走线留 0.2ns。block 用 set_input_delay / set_output_delay 把预算写成端口约束,各自签核时只保证自己那半段不破预算;顶层只检查「所有 block 交付的预算之和」是否满足全局路径。
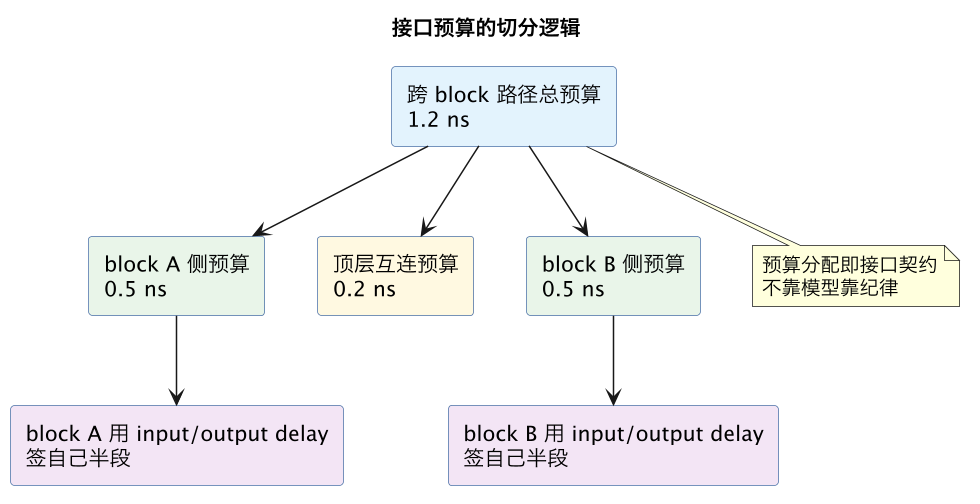
预算路线的优点是零模型成本:不需要生成、版本管理、对拍任何抽象模型,block 完全独立并行开发,顶层设计冻结前就能开工。它的缺点和优点同源——预算分配是拍脑袋的艺术:分松了,各 block 都轻松过关但顶层集成时发现总路径超了;分紧了,某个 block 为了半段 0.5ns 的预算过度优化,面积功耗全赔进去。而且预算天生是 GBA 粒度、无 CRPR、无串扰上下文的,精度上限最低。
所以预算路线的真实定位是实现期的脚手架,签核期的辅助:P&R 收敛阶段用预算快速迭代;进入签核后切换到 ETM 或 ILM 做真集成检查,预算退化为「合理性监控」——如果某个 block 实际接口延迟相比预算偏差超过 20%,说明预算分配本身有问题,需要重新切分而不是硬签。
五、三条路线的对比与选型
把三种方法放在一张表里看:
| 维度 | ETM | ILM | 接口预算 |
|---|---|---|---|
| 抽象本质 | 端口间查表弧(黑盒) | 接口逻辑子网表(灰盒) | 端口约束(无模型) |
| 模型体积 | 原 block 的 1% 以下 | 10%-30% | 零 |
| 顶层运行开销 | 最低 | 中 | 无(不跑集成) |
| 上下文敏感性 | 冻结在生成时刻 | 实时计算 | 无 |
| CRPR 精度 | 差(靠 derate 补) | 与 flatten 一致 | 无 |
| PBA 穿透能力 | 无 | 有 | 无 |
| SI/串扰支持 | 弱(需额外预算) | 较好 | 无 |
| 适用阶段 | 签核集成(接口简单的 block) | 签核集成(关键 block) | 实现期 / 早期规划 |
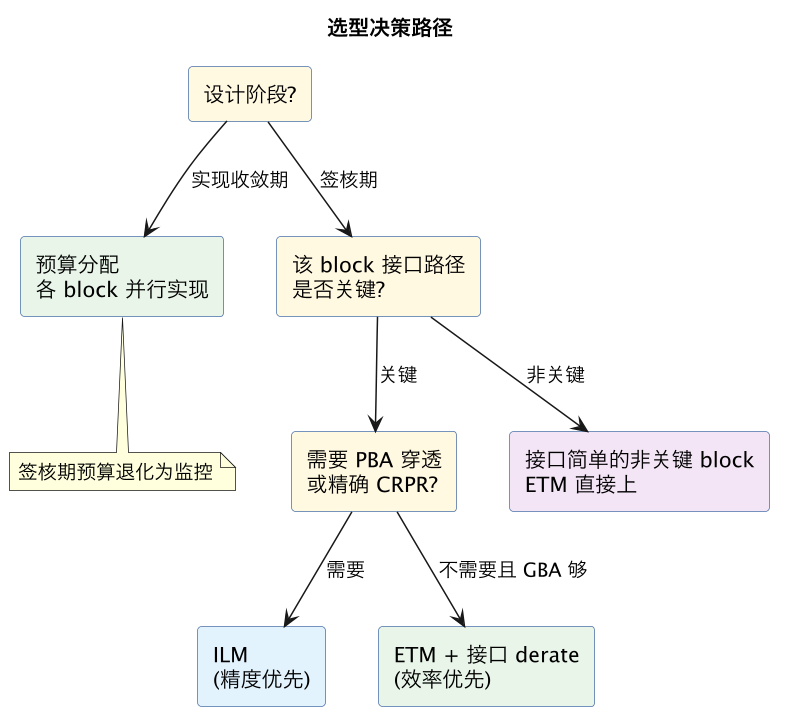
真实项目里三条路线几乎总是混用:CPU 核心、NoC 这类接口时序关键、CRPR 敏感的 block 上 ILM;外围 IP wrapper、接口路径就几级的 block 上 ETM;整个项目早期用预算推进,签核前全部切换到模型路线。决策的硬指标就三个:接口路径是否出现在顶层 top 关键路径里(在,就 ILM)、是否需要跨 block PBA 签核(要,就 ILM)、顶层内存预算还剩多少(紧张,就往 ETM 倾斜)。
两种模型可以共存于同一个顶层 run:PrimeTime/Tempus 都支持部分 block link ETM、部分 link ILM 的混合装配,注意统一 scenario 集——ETM 按模式生成的,混合装配时 mode 映射表是人为维护的,错配一个 mode 整条接口路径静默签错。
六、典型翻车点
| 事故 | 根因 | 拦截动作 |
|---|---|---|
| 硅上接口路径 setup 失效 | ETM 冻结的串扰上下文与真实不符 | 关键接口用 ILM 或加 SI derate 预算 |
| 接口路径悲观度爆炸 | ETM 吃掉 CRPR 又叠多层 derate | 换 ILM,让 CRPR 真实计算 |
| 顶层关键路径无法 PBA | 路径穿过 ETM 边界 | 关键 block 改 ILM 或该路径转预算加严 |
| ILM 对拍偏差大 | 接口寄存器删除判据漏了寄生影响 | ILM vs flatten 对拍进回归门禁 |
| mode 错配签错接口 | 混合装配时 ETM mode 映射表手工维护出错 | mode 映射表脚本化生成 + 抽样比对 |
| 预算全绿顶层却违规 | 预算切分不合理,各 block 余量错配 | 签核前切换模型路线做真集成检查 |
| block 改版顶层忘回归 | ETM/ILM 版本与 block 网表版本脱节 | 模型版本号与网表 commit 绑定进 CI |
这一篇在知识体系里的位置
- 签核主干:E1 黄金 STA:PrimeTime/Tempus——层次化签核是它的规模化延伸,模型生成与混合装配都在这两个工具里完成。
- 分析模式:GBA 与 PBA 分析模式——ETM/ILM 选型的一个硬判据就是要不要跨 block PBA。
- 多角管理:MMMC 高级 STA——ETM/ILM 都按 scenario 生成,scenario 爆炸直接决定模型的版本管理成本。
- 时钟精度:CRPR 时钟重汇聚补偿——ETM 最大的精度损失点正是 CRPR,ILM 保留时钟树就是为了它。
总结
层次化 STA 接口时序的三条路线本质是三种「精度换效率」的合同:ETM 把 block 压成端口查表黑盒,体积最小、速度最快,但冻结了上下文、吃掉了 CRPR 和 PBA,只配给接口简单的非关键 block;ILM 删掉内部逻辑留下带真实时钟树和寄生的接口壳,精度与 flatten 基本一致、代价是十倍级的模型体积,关键 block 的签核只此一家;接口预算不建任何模型、靠 input/output delay 约束切蛋糕,是实现期并行开发的脚手架,签核前必须切换到模型路线。选型只认三个硬指标——接口路径是否关键、要不要跨 block PBA、顶层内存还剩多少,再配上 ILM vs flatten 对拍和模型版本绑定 CI 两条纪律,层次化签核才不会在接口这条「三不管地带」上翻船。