重定时综合:寄存器跨逻辑搬移的时序收益、实现机制与验证等价性风险
更新时间:2026-10-02。逻辑综合阶段,当时序还差最后几十皮秒,最常见的动作是换 VT、加大驱动、重构逻辑——这些都动组合逻辑。但还有一类优化完全不动逻辑,只把寄存器「挪个位置」:把一级触发器从组合云的左岸搬到右岸,让两边路径的延迟重新均摊。这就是重定时综合(retiming)。本站 逻辑综合与 Design Compiler 讲过综合主流程,综合约束 SDC 写法 讲过时序目标怎么喂给工具,锁存器借时与 STA 从分析角度讲过「跨周期借用时间」的概念。这一篇换一个视角:不等分析阶段借时,而是在综合阶段直接把寄存器物理地搬过去,同时把这件事对形式验证(LEC)造成的麻烦讲透——retiming 是用最小的面积代价换时序,但代价转移到了验证侧,这笔账不算清楚迟早要在 LEC 不等价调试 里还回来。
本文要回答的问题
- retiming 搬移寄存器为什么不影响电路功能,它依赖的数学前提是什么?
- 前向搬移与后向搬移各自怎么进行,工具是怎么算出最优寄存器位置的?
- retiming 能省多少时序,又有哪些场景下它无能为力甚至帮倒忙?
- 面积、功耗、初始化(reset)语义在搬移后会发生什么变化?
- retiming 为什么让 LEC 变难,工具链和流程上如何把等价性风险关住?
- 工程上什么设计适合开 retiming,什么时候应该坚决关掉?
一、retiming 到底在做什么:把寄存器当「可移动的砝码」
先看问题本身。一条寄存器到寄存器的路径,组合逻辑延迟很少是均匀分布的:典型场景是乘法器后面跟一段浅逻辑,前一级到寄存器 900ps,寄存器到后一级只有 100ps,时钟周期 1000ps——前一段顶满,后一段空转 90% 的时间。时序优化的常规武器是改前一段:并行化、流水线化、换更快单元。但还有一个零逻辑代价的选项:把中间那个寄存器往组合云里搬一格,让 900ps 变成 500ps、100ps 变成 500ps,两段都收敛。逻辑一个门没动,功能一拍不差,只是「在第几拍采样」的位置变了。
这就是重定时综合的核心直觉:寄存器不是逻辑的边界,而是时间轴上的刻度;刻度可以移动,只要全图移动保持一致。用图论语言说,把电路建成有向图——节点是组合门,边是连接关系,每条边带一个非负整数权重表示上面串了几个寄存器。retiming 就是给每个节点找一个整数标号 r(v),把每条边 (u,v) 的权重从 w 改成 w + r(v) − r(u),要求改完所有权重仍为非负(不能搬出负数个寄存器),并且关键路径上的总权重变化满足时序目标。功能不变性的保证来自一个漂亮的事实:任何节点的出边加 k 个寄存器、入边减 k 个寄存器,对外部的输入输出延迟关系完全等价——数据晚到几拍、但内部运算次序不变,只要输入输出边界的寄存器数总量不变,黑盒行为一致。
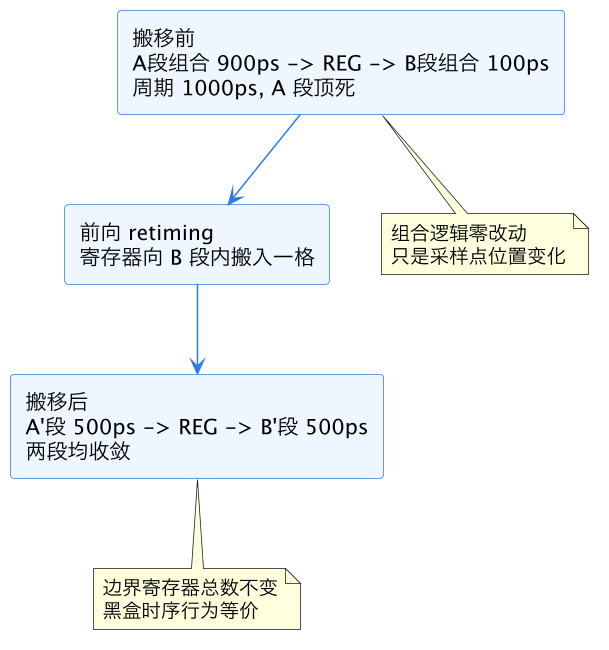
上图是最小例子。读图时注意「组合逻辑零改动」这个注记:retiming 的全部收益来自时间资源的再分配,不创造任何新的时间——900 加 100 总共就是 1000ps 的组合延迟加一级寄存器开销,搬移只是把均摊做平。这意味着 retiming 有一个天然的能力上限,下面第四节会算这笔账。
还有一个和借时概念的对照值得记住:latch 借时是在分析阶段承认时间可以跨级流动,触发器做不到这一点(硬沿采样);retiming 是在实现阶段直接把触发器搬到时间盈余的位置。两者解决的是同一个矛盾——组合延迟分布不均——只是一个靠容忍、一个靠挪动。在纯触发器设计里,retiming 是唯一不需要改时钟架构的均摊手段。
二、搬移的两个方向与工具求解:Leiserson-Saxe 框架
工程上把搬移分两个方向。前向 retiming(forward)把一个寄存器从某个门的所有输入侧推到输出侧:原来输出侧有一个寄存器、输入侧没有,搬完变成输入侧各有一个(fanout 复制)。后向 retiming(backward)反过来,把输出侧的多个寄存器收回输入侧合并成一个。注意复制与合并的含义:穿过一个扇出点向前搬,寄存器数量会乘以扇出数;穿过扇入点向后搬,多个寄存器可以合并。所以 retiming 不是「寄存器守恒」的操作,它的面积账要单独算。
工具侧的经典算法是 Leiserson-Saxe 框架:给定目标周期 T,把「每条权重 ≥ 某值的路径上组合延迟不超过 T」翻译成一组差分约束(difference constraints),然后用 Bellman-Ford 类算法求一组可行的节点标号 r(v)。可行就输出搬移方案,不可行就证明该周期达不到。这套算法的美妙处在于它是全局最优的——不是启发式地一个寄存器一个寄存器试,而是整图一次性解出来。实际综合工具(Design Compiler 的 optimize_registers、Genus 的 retiming 引擎、Fusion Compiler 里的对应开关)在此基础上叠加了面积惩罚、功耗惩罚、不动点约束(don't touch 的寄存器、跨层次的边界、带复杂 reset 的寄存器)等工程限制,实际产出是「全局最优解在工程约束集内的投影」。
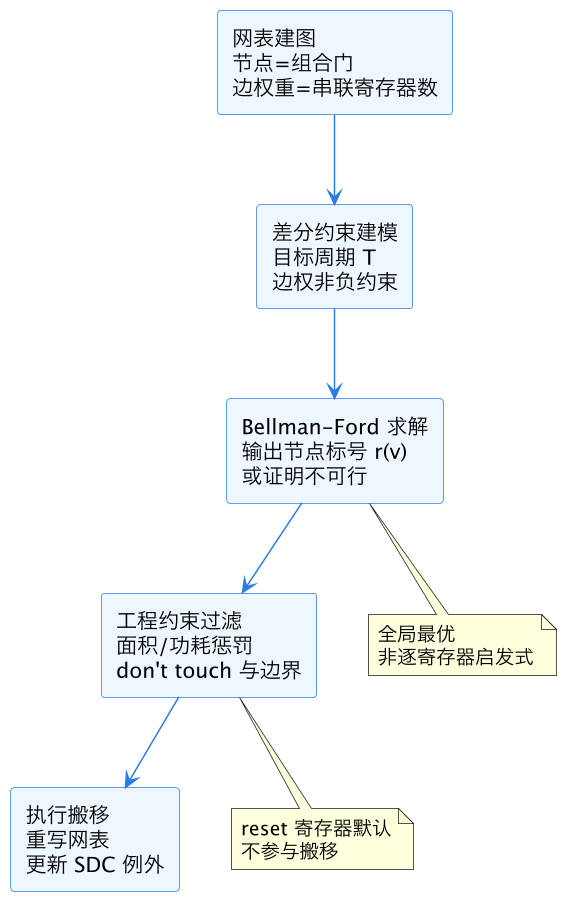
这张图的重点在「工程约束过滤」这一环。教科书算法假设所有寄存器都可以自由搬,真实网表里有一大片寄存器动不得:带异步复位/置位的(搬移会改变上电后前几拍的行为)、跨时钟域的、被 set_dont_touch 保护的、属于测试结构(scan 链顺序会乱)、以及层次边界上的接口寄存器。工具默认对这些一律保守,这也是为什么很多设计开了 retiming 开关却看不到任何搬移发生——不是算法没找到解,是工程约束把解空间筛空了。想让 retiming 真正干活,设计侧的配合是:能用同步复位就不用异步复位、接口寄存器明确标注、RTL 里避免奇怪的初始化依赖。综合阶段的整体语境见 数据流 S2 综合交接。
三、时序收益:能省多少,账怎么算
retiming 的收益有一个理论上限:最优搬移后的最小周期,不小于「全图总组合延迟 ÷ (路径上寄存器数 + 1)」在所有割集上的最大值。也就是说,如果一级流水线里组合总量是 3000ps、只有 2 个寄存器可用作刻度,那么最好的均摊也就是 3 段各 1000ps,retiming 变不出第 3 个寄存器。想突破这个上限必须加流水线级数(那是另一项优化,常与 retiming 联用:先加级再搬平)。
实际收益取决于「延迟分布的不均程度」。经验数字:手动精心平衡的流水线(比如写得很规整的乘加树),retiming 几乎捞不到东西,5% 以内;RTL 按功能模块自然分段、延迟分布悬殊的设计(典型是「一大块组合后面挂一小段尾巴」),retiming 常能挤出 10% 到 20% 的周期改善。一个公开的典型场景是算术单元:乘法器的部分积压缩树延迟大头在中段,RTL 作者把寄存器放在模块边界上,retiming 把寄存器沉入压缩树内部的最深处,收益立竿见影。
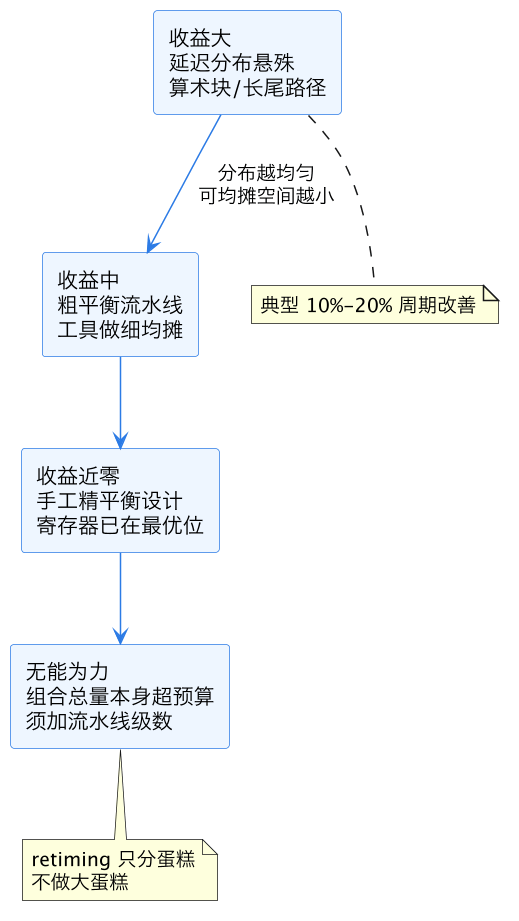
这张图是收益预期的速查:开 retiming 之前先问自己「我的关键路径两侧是不是一长一短」。如果答案是否,retiming 只会白烧运行时间和验证成本。还有一个反直觉点:retiming 对 hold 时间的影响不总是正面的。寄存器搬走之后,原本很长的前段可能变短,短路径的 min delay 检查可能新冒出 hold 违例。好在 hold 修复手段成熟(插 delay cell),STA hold 修复与缓冲器插入 讲的那套流程在 retiming 之后照跑,但要把它计入收敛周期的预期里——retiming 不是一次开关就完事,后面通常跟着一轮 hold 修复再确认。
四、副作用清单:面积、功耗与初始化语义
时序收益不是白来的,retiming 的代价分三笔。
第一笔是面积。穿过扇出点前向搬移会复制寄存器:一个寄存器推过 8 扇出的节点变成 8 个。极端案例里 retiming 可以把寄存器数量翻倍以上。实际工具都有面积惩罚系数(搬一步新增的寄存器代价超过阈值就不搬),但惩罚系数是全局的,局部仍可能出现寄存器暴涨。回归后要看的报告项是 sequential cell count 的变化率,业内常见的接受阈值是 5% 到 10% 以内。
第二笔是功耗。寄存器是时钟树上最重的负载之一,数量翻倍意味着时钟网络功耗显著上升;而且搬移后的寄存器可能落在数据翻转更频繁的位置(比如搬进了乘法器中间,那里 glitch 传播旺盛),数据端动态功耗也会涨。反过来,如果 retiming 省下的时序裕量允许降电压或换高 VT 单元,总功耗账可能是正的——这就是为什么 retiming 决策要在 clock gating 功耗效率 的框架里整体评估,不能只看时序报告。
第三笔最容易被忽视也最危险:初始化语义。带异步复位的寄存器被搬移后,复位释放后前几拍的功能行为可能变化——教科书 retiming 保证的是「稳态输入输出关系一致」,不保证「上电后逐拍一致」。算法文献里的处理是引入「初始状态计算」:为搬移后的每个寄存器反推出一个等效初始值,但组合逻辑反推初始值不是总能做到(反推遇到汇聚点可能无解)。工程实践的底线因此非常简单粗暴:带 reset 的寄存器默认不搬,工具默认如此,不要图时序收益去解开这个限制,除非你对相关逻辑做过专门的等价性论证。
| 维度 | 搬移后变化 | 工程对策 |
|---|---|---|
| 寄存器数量 | 扇出处复制,可翻倍 | 面积惩罚系数 + 数量变化率阈值 5%-10% |
| 时钟功耗 | 寄存器负载增加 | 结合 clock gating 与 VT 重平衡总账 |
| 数据功耗 | 取决于落点翻转率 | 搬移后跑 SAIF 回流功耗对比 |
| 初始化 | reset 语义可能漂移 | reset 寄存器默认冻结不搬 |
| scan 链 | 顺序与数量变化 | retiming 后重接 scan,见 DFT scan 与 ATPG |
这张表建议作为 retiming 评审的 checklist:每开一次 retiming,五行逐项过一遍,任何一行没有答案就先不要合入网表基线。
五、验证等价性风险:LEC 为什么被 retiming 卡住
现在讲本篇标题的另一半。功能等价性检查(LEC,Logical Equivalence Checking)的主流实现是基于组合比对:把 Golden(RTL)和 Revised(网表)的寄存器一一配对,把电路切成「寄存器到寄存器」的组合锥(logic cone),逐对证明两个锥布尔等价。这套方法的前提恰恰是 retiming 破坏掉的东西——寄存器一一对应。搬移之后,Golden 里的寄存器 A 在 Revised 里可能分裂成 B1、B2 落在不同逻辑深度,Golden 的一个组合锥在 Revised 里横跨了两级流水。配对表对不上,组合比对器直接报 non-equivalent 或干脆 abort。LEC 基础见 形式验证 LEC 与 Formality。
工业界有三条应对路线。第一条是增量 LEC 加 retiming 感知:主流 LEC 工具(Formality、Conformal)都有 retiming 专用的求解模式,允许在寄存器对应不上时做「时序化的等价证明」——本质是把比对从纯布尔升级到带有时帧展开(time-frame expansion)的序列等价(sequential equivalence)。这条路可行但代价大:证明深度随搬移拍数增长,复杂设计里运行时间从小时级窜到天级,还经常留下一堆 unverified 点。
第二条是工具链内闭环:综合工具在搬移的同时输出一份搬移记录(比如 Formality 的 SVF,setup verification for Formality 的 guide 文件),LEC 工具读这份记录直接重建寄存器对应关系,把序列等价问题降级回组合等价。这是当前最主流的做法,但它的软肋是「记录即信任」:LEC 实际验证的是「综合工具声称它做的搬移」而不是「网表里真实存在的搬移」,记录文件和网表不一致(比如手工 ECO 过)时防线就破了。
第三条是保守设计纪律:对 retiming 施加范围限制,只允许在工具能自动证明等价的子集上搬——比如禁止跨层次搬、禁止搬状态机寄存器、只允许在算术 datapath 上开。用约束把验证风险关进笼子里,牺牲一部分时序收益换验证确定性。
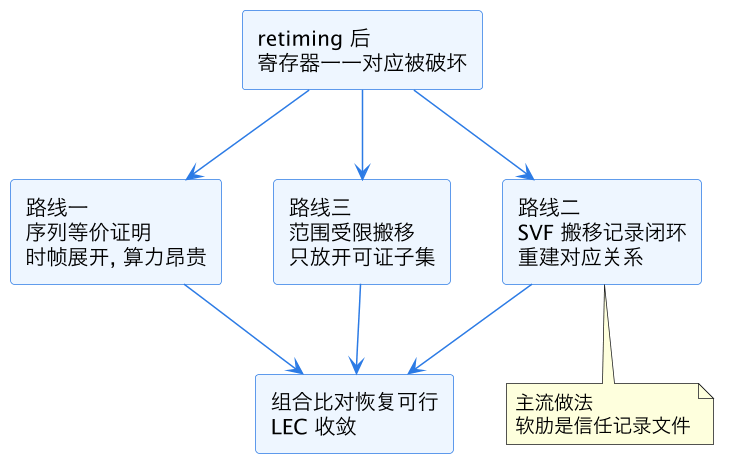
读这张图要建立一个认知:三条路线不是互斥的,成熟流程通常是「路线三划范围 + 路线二走闭环 + 路线一对付漏网之鱼」的组合。还有一条流程纪律值得单独强调:retiming 之后的 LEC 失败,调试入口和常规 LEC 失败不一样——不要一上来就追逻辑锥差异,先核对 SVF/guide 文件是否完整覆盖了综合运行、LEC 不等价调试 里的通用分层定位法(先定位到模块、再定位到寄存器组)要把「搬移记录缺失」列为第一嫌疑。统计意义上,retiming 引入的 LEC 问题里一大半不是真的功能错误,而是验证基础设施没跟上。
六、工程决策:什么时候开,什么时候关
把前五节收拢成可执行的决策。适合开 retiming 的信号:关键路径呈「长段加短尾巴」形态;设计是 datapath 密集型(算术、DSP、编解码);寄存器以无 reset 或同步 reset 为主;综合与 LEC 工具链的 guide 闭环已在项目里跑通过;时序缺口在 20% 以内,且常规 sizing/重构已吃过一轮。坚决关掉的信号:控制逻辑和状态机为主的设计(搬移收益近零,验证成本照付);大量异步复位逻辑的老 IP 集成;项目处于 ECO 频繁期(每次 ECO 后 guide 记录都可能失效,验证债利滚利);以及团队没有 retiming 后 LEC 调试经验、量产节点又临近的情况——这时候那十几皮秒应该去 STA setup 修复之 VT swap 与 sizing 里找,而不是开一个新风险源。
落地顺序推荐三步走:第一步,在一个非关键子模块上试点,走通「综合开 retiming → SVF 导出 → LEC 闭环」全链路,记录寄存器数量变化、功耗变化、LEC 运行时间三个基线数字;第二步,把试点数据换算成项目级预期,定下哪些模块开、哪些关的白名单,写进综合约束模板;第三步,把「retiming 后五项 checklist」(第四节那张表)固化进网表入库评审。retiming 是少有的「工具能力远超团队使用成熟度」的特性,差距不在算法在纪律——综合 QoR 报告解读 里讲的 QoR 追踪习惯,对 retiming 要加倍执行,因为它动了验证的根基。
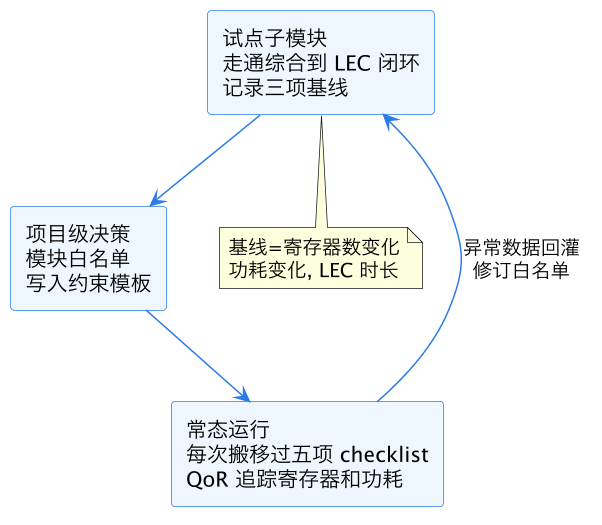
这张闭环图强调「异常数据回灌」:任何一次 retiming 后出现 LEC 超时或寄存器暴涨,结论都要回到白名单修订上,而不是当场人工摆平就翻篇。方法学的复利来自纪律的积累,不来自单次救火的英雄主义。
这一篇在知识体系里的位置
本篇是 eda/ 目录下逻辑综合线的一篇标准深文,向上承接 逻辑综合与 Design Compiler 的主流程与 综合约束 SDC 写法 的目标设定,横向与时序分析侧的 锁存器借时与 STA、修复侧的 STA setup 修复之 VT swap 与 sizing 和 STA hold 修复与缓冲器插入 构成「均摊时间」主题的三个视角;验证侧主线接 形式验证 LEC 与 Formality 与 LEC 不等价调试,功耗侧延伸到 clock gating 功耗效率,交接与 QoR 管理见 数据流 S2 综合交接 与 综合 QoR 报告解读,DFT 影响见 DFT scan 与 ATPG。
总结
重定时综合把寄存器当作时间轴上可移动的刻度,用 Leiserson-Saxe 图论算法在整图范围内求解最优搬移,让不均摊的组合延迟重新均分,对延迟分布悬殊的 datapath 设计常能挤出 10% 到 20% 的周期改善而不动一个逻辑门;但它的收益有硬上限(只分蛋糕不做大蛋糕),代价是寄存器数量与功耗的上涨、reset 初始化语义的隐患,以及最核心的一笔——破坏了 LEC 赖以工作的寄存器一一对应,必须用「范围白名单加 SVF 记录闭环加序列等价兜底」的组合纪律把验证风险关住,否则省下的时序迟早要在等价性调试里连本带利还回去。