工艺文件版本管理:foundry PDK、techfile 与规则 deck 的版本对齐纪律、多项目版本矩阵与升级回归策略
更新时间:2026-10-05。工艺文件版本管理是每个芯片团队迟早要交学费的地方:foundry 一个季度推一版 PDK,techfile 和 DRC/LVS 规则 deck 各自独立演进,寄生参数提取模型(见 StarRC techfile 与 ITF/TLU+)和时序库(见 lib 与 db 编译检查流程)又都挂在 PDK 版本上——三套文件、三条发布节奏、N 个并行项目,任何一个维度没对齐,轻则 DRC 假违例刷屏,重则流片回来发现签核口径和 foundry 验收口径不是同一份。这一篇把工艺文件版本管理讲透:版本到底由哪几层构成、多项目并行时版本矩阵怎么维护、升级一次 PDK 要回归什么、以及哪些升级窗口千万不能碰。读之前建议先有 PDK 版本基线数据流 的基础。
本文要回答的问题
- 工艺文件的「版本」到底是哪几层文件的版本,为什么 PDK 版本号不能代表一切?
- foundry 推送新版 PDK 时,正在跑的项目该不该跟、什么时候跟?
- 多项目并行时版本矩阵怎么建,哪些组合是合法的、哪些是事故温床?
- 升级一版 PDK 或规则 deck,回归测试到底要跑什么、跑到什么程度算过?
- 流片前的版本冻结纪律是什么,tapeout 后版本基线留什么档案?
一、版本不是一个号:工艺文件的四层构成
很多团队的第一课是发现「PDK 版本」这个说法本身就有歧义。一个完整可用的工艺环境至少由四层文件构成,每层有自己的发布节奏和版本号。
第一层是 PDK 本体:器件模型(SPICE model)、symbol、pcell、技术参数。foundry 按季度或半年发布,版本号类似 v1.0_2p1,大版本带工艺修正,小版本多是 pcell 修复和模型微调。第二层是 techfile:给布局布线、RC 提取工具用的工艺描述文件,每层金属的厚度、宽度规则、电阻电容系数都在里面。techfile 跟着 PDK 走但不一定同号发布——foundry 经常单独修一个 techfile 的 RC 系数错误,出一个 techfile_revB 补丁。第三层是规则 deck:DRC deck、LVS deck、ANT deck、ERC deck,物理验证的验收口径,由验证工具厂商和 foundry 联合维护,更新最频繁,成熟工艺一年能出四五版。第四层是库与 collateral:标准单元库、IO 库、memory compiler 生成器、liberty/db 时序视图,这些由库厂商基于某个 PDK 版本标定,版本号和 PDK 又不同步。
四层各管一摊,但签核时它们必须互相咬合:techfile 里的金属参数要和 DRC deck 检查的参数一致,LVS deck 提取器件的口径要和 PDK model 的器件定义一致,库的时序标定要基于同版 SPICE model。所谓「版本管理」,管的就是这四层之间的组合关系,而不是单独一个 PDK 版本号。
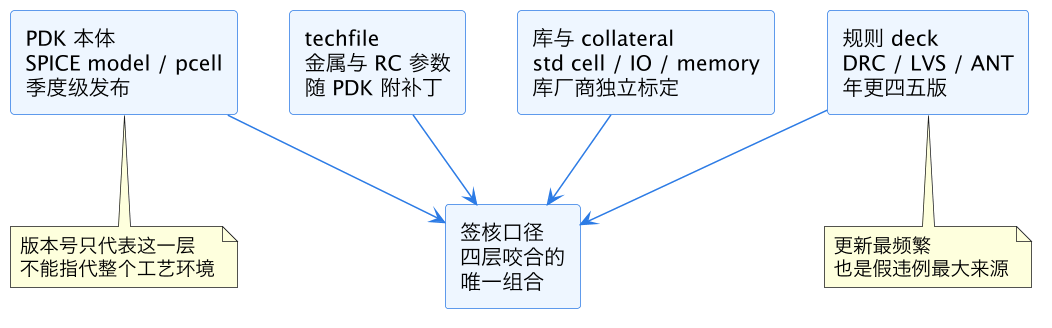
这张图是全部讨论的出发点:工艺文件版本管理的对象是「四层文件的组合」,foundry 邮件里那句「请升级到 v1.2」只动了第一层。团队的版本基线(baseline)必须把四层各是什么版本写死,才谈得上对齐。
二、版本基线:四层组合的单一事实来源
落到工程上,每个项目需要一份版本基线文件,作为四层组合的单一事实来源(single source of truth)。它通常是一个纳入 Git 管理的 YAML 或纯文本文件,大致长这样:
process: tsmc_n12ffc
baseline: 2026Q3-projA
pdk: v1.0_2p3
techfile:
  starrc: n12_1p2_revB
  qrc: 1.2.0
deck:
  drc_calibre: rev2.15
  lvs_calibre: rev2.15
  antenna: rev2.10
library:
  stdcell: tcbn12ffcllbwp7t_190a
  io: tpsn12_1v8_3p1a
  memory: mc2_n12_v3p2
几个纪律值得强调。第一,基线文件必须进版本控制、走评审流,改一行也要留 commit——它是事后追溯「这颗芯片到底按什么口径签的」的唯一凭证。第二,工具脚本(设计环境 setup、回归脚本)一律从基线文件读路径,禁止任何人在环境变量里私设指到别的版本;环境里出现两份 PDK 同时被挂载,是所有版本事故的公共起点。第三,基线里写补丁级版本号,不写「latest」之类的浮动符号链接——符号链接今天指向 A、明天指向 B,等于基线文件白写。第四,基线文件的消费者要覆盖全流程:综合、APR、提取、STA、物理验证、功耗分析,任何一环读的不是基线指定的版本,口径就裂开了。实操上值得加一道轻量检查——CI 里跑一个脚本,把各工具日志里实际加载的文件版本抓出来跟基线对一遍,对不上直接报红。这道检查成本很低,却能把「某工程师本地环境指错路径」这类事故从流片级风险降级成一次 CI 失败。
还有一个容易漏的点是 IP 与硬核的版本口径。外购 IP(PLL、SerDes、DDR PHY)是按特定 PDK 版本 hardened 的,它的 LEF、GDS、liberty 都钉在那个版本上。项目升级 PDK 时,IP 供应商确认函是回归清单里的一项硬输入:对方书面确认该 IP 在新版 PDK 下仍然有效,或者给出重交付计划。没有这张确认函就升级,等于在 signoff 口径里埋了一个第三方也说不清的未知数。
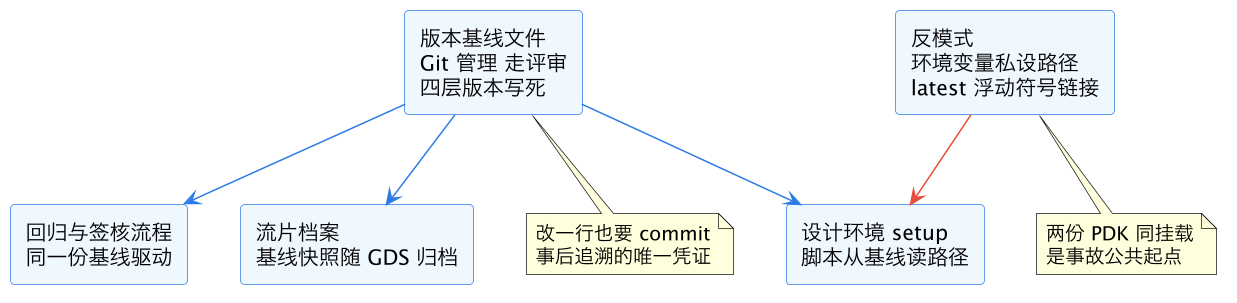
这张图讲基线文件的三个消费方和一个反模式:环境、流程、档案都从基线读,而「私设路径」绕开基线是红线。基线文件不贵,一页 YAML;缺了它,所有升级讨论都会退化成「我机器上跑的版本是什么来着」。
三、多项目并行:版本矩阵怎么建
单一项目时版本管理是体力活,多项目并行时才变成脑力活。典型场面:项目 A 在 signoff 冲刺,钉死在年初的基线;项目 B 刚 kickoff,想直接用最新 PDK;项目 C 在年中,纠结要不要跟 foundry 刚发的修正版。三个项目三套基线,公共的 IP、公共的验证环境、公共的库怎么复用,就是版本矩阵要回答的问题。
版本矩阵的维护原则是「一项目一列、一文件层一行、每格一个确定版本」,然后给每个格子标状态:冻结(frozen,进入 signoff 后不允许动)、跟踪(tracking,允许跟 foundry 更新)、观望(evaluating,新版本在评估还没启用)。下面这张表是一个三门并行的例子。
| 文件层 | 项目 A(signoff 冲刺) | 项目 B(kickoff) | 项目 C(中期) |
|---|---|---|---|
| PDK 本体 | v1.0_2p1(冻结) | v1.0_2p3(跟踪) | v1.0_2p1(观望 2p3) |
| techfile | 1p2_revA(冻结) | 1p2_revB(跟踪) | 1p2_revA |
| DRC/LVS deck | rev2.12(冻结) | rev2.15(跟踪) | rev2.12 |
| 标准单元库 | 190a(冻结) | 190a | 190a |
| memory compiler | mc2_v3p1(冻结) | mc2_v3p2(跟踪) | mc2_v3p1 |
矩阵本身只是记录,真正起作用的是它背后的两条铁律。第一条:signoff 冻结线。项目一旦进入 final signoff(通常是 tapeout 前六到八周),矩阵里这一列全部转冻结,之后 foundry 发什么都不跟,除非是可导致硅失效的 errata(见下节)。第二条:同层不同版本必须有隔离的执行环境。项目 A 和项目 B 用不同版 DRC deck,那它们的物理验证跑批必须在不同 workspace 或容器里跑,共享环境迟早有一天 deck 路径串了,A 项目拿 B 的 deck 出了一份「干净」的 DRC 报告——而两个 rev 之间恰好有一条金属间距规则收紧过,这就是真实流片事故的剧本。
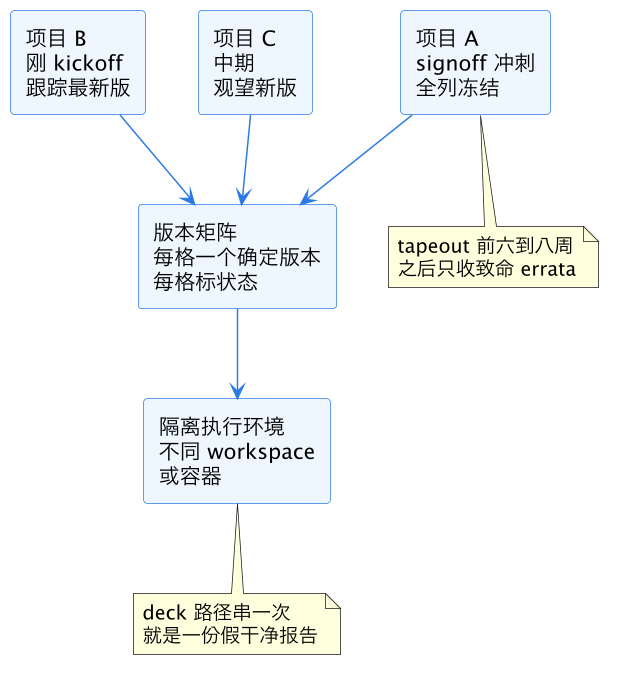
这张图把矩阵的两个消费者画在一起:三个项目向矩阵登记,矩阵决定它们各自的执行环境怎么隔离。矩阵不隔离执行,就只是张壁纸。
四、升级回归:一次 PDK 升级要跑什么
跟不跟 foundry 的新版,取决于回归成本。升级回归的本质是回答一个问题:换这套文件之后,我之前签过的东西还成立吗?一套最小可用的回归清单分四步。
第一步,工具级 smoke:新 PDK/techfile 装进干净环境,跑一个已知的小 testcase(比如一个几万门的参考设计),确认工具能读完所有文件、不抛版本兼容错误。techfile 和工具版本不匹配是常见翻车点,比如新版 techfile 用了新关键字、旧版提取工具不认识。第二步,规则 deck 差异分析:DRC/LVS deck 升级后,拿当前设计的 GDS 跑新旧两版 deck 做 diff。新增违例分两类——真规则收紧(要修设计或申请 waiver)和 deck 写法变化导致的假阳性(找 foundry 澄清)。这一步的产出是「新增违例归零或条条有结论」。第三步,寄生与时序漂移:新版提取模型下重跑 RC 提取,对比关键网表的寄生参数漂移幅度,然后增量重跑 STA。工程经验是同一节点内的小版本升级,时序漂移超过 2-3% 就要停下来查原因,而不是直接收下。第四步,库重标定检查:如果 PDK 的 SPICE model 变了而库厂商还没出配套新库,时序库就是「旧模型标定」配「新模型电路」,这是隐性的口径错位,要么等库、要么自己重标定、要么向 foundry 书面确认 model 变化不影响标定区间。
四步之外还有一件贯穿的事:回归结果要落成书面记录。每次升级出一份半页到一页的回归报告,写清从哪个基线升到哪个基线、四步各自的结论、遗留问题与 waiver 清单。这份报告既是项目内部的质量凭证,也是 foundry 或客户审计时「你们怎么验证升级的」的标准答案。团队把回归做成例行公事之后,升级决策就从「心跳加速的赌博」退化成「算一下两周人力排不排得开」的排期问题——这正是版本管理想达到的状态。
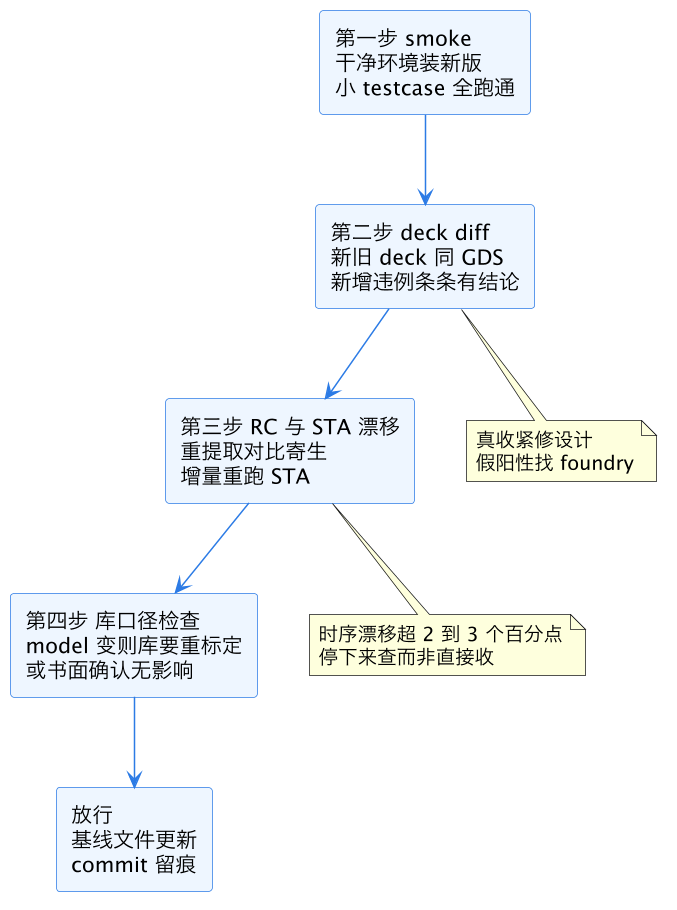
这张流程图是升级回归的最小闭环:四步任何一步过不去,升级就停在那一步,不存在「先升上去再说」。整套回归在一个成熟项目上大约是一到两周的工程量——这个数字就是「跟不跟新版」决策的分母。
五、升级窗口纪律与 tapeout 档案
最后把决策纪律收口。什么情况下必须升级、什么情况下禁止升级,行业里的共识相当一致。
必须跟的只有一种:foundry 发布 errata,确认当前版本存在可导致硅失效或良率损失的错误(model 错误、deck 漏检某类致命短路)。这种邮件来了,冻结也要破例——但破例动作是「定点打补丁 + 针对该 errata 的最小回归」,不是顺势全量升级。建议跟的是:项目尚在早期(RTL 或综合阶段),回归成本低,新版本带明显收益(DRC 收敛轮次减少、RC 精度修正)。禁止碰的窗口是 signoff 冻结期之后到 tapeout,以及 tapeout 后到硅验证完成之间——后者容易被忽略,但硅回来后要做失效分析,必须能用当时的版本复现签核环境。
tapeout 时的版本归档动作:基线文件打 tag,连同四层文件的实际内容(或 foundry 的只读归档路径)、签核报告一起进流片档案。两年后 silicon issue 回来,团队要做的第一件事就是翻出这份档案重建环境——版本管理做得好不好,到那一刻才见分晓。
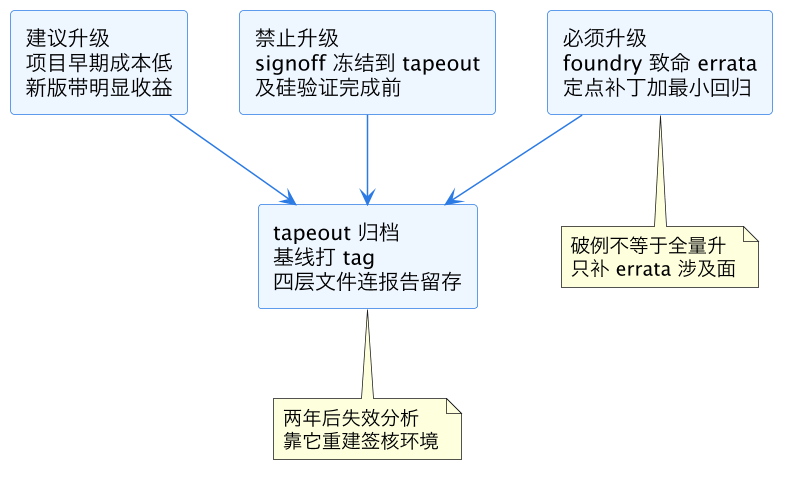
这张图是决策纪律的三档加归档:必须、建议、禁止的边界画清楚,所有路径最终都汇入 tapeout 归档——版本管理的终点不是「用了对的版本」,而是「任何时候都能证明当时用的是哪套版本」。
这一篇在知识体系里的位置
本篇属于 EDA 数据管理主题,上接 PDK 版本基线数据流(讲 PDK 数据在流程里怎么流转),横向上四层文件中的寄生提取侧细节见 StarRC techfile 与 ITF/TLU+,时序库侧的产物检查见 lib 与 db 编译检查流程。数据管理更宏观的话题(设计数据本身的版本与分支)可延伸到数据管理专题 数据管理与版本控制。
总结
工艺文件版本管理的对象不是「PDK 版本号」而是 PDK 本体、techfile、规则 deck、库 collateral 四层的咬合组合:用一份进 Git 的基线文件把组合写死,多项目用版本矩阵标冻结/跟踪状态并隔离执行环境,升级必走 smoke、deck diff、RC/STA 漂移、库口径四步回归,signoff 冻结期只收致命 errata,tapeout 时基线连同四层文件归档——做到任何时候都能重建并证明签核口径,版本管理才算闭环。