功能覆盖率和代码覆盖率是一回事吗:一字之差,验证闭环的两条腿
刚入行的验证工程师,看覆盖率报告时经常会困惑:代码覆盖率已经 95% 了,为什么经理还说"验证没收敛"?答案就藏在标题这个问题里——功能覆盖率和代码覆盖率不是一回事,它们量的是两个不同维度。本篇用一个问答案把这件事讲透,深入的 covergroup 写法见代码覆盖率与功能覆盖率详解和 covergroup 与 coverpoint 基础。
本文要回答的问题
- 功能覆盖率和代码覆盖率到底是不是一回事?
- 代码覆盖率 100%,功能覆盖率可能只有 50% 吗?反过来呢?
- 两类覆盖率各自由谁定义、谁来打钩?
- 新手最容易踩的三个误区是什么?
简短结论
不是一回事。 一句话区分:
- 代码覆盖率(Code Coverage):仿真器自动统计的客观计数——RTL 的每一行、每一个分支、每个状态机的每个状态,在这次回归里被执行过没有。它回答的是"代码跑过没有"。
- 功能覆盖率(Functional Coverage):验证工程师根据设计规格书,手工用 covergroup/coverpoint 定义的"该测的场景清单",仿真器只负责在采样点打钩。它回答的是"设计意图里的场景测到没有"。
一个是"机器数数",一个是"人对照规格书出题、机器打钩"。代码覆盖率再高,只说明 RTL 没死代码;功能覆盖率不满,说明规格书里还有场景压根没被激励覆盖到——验证闭环必须两条腿都走完。
一张对比卡看清本质差异
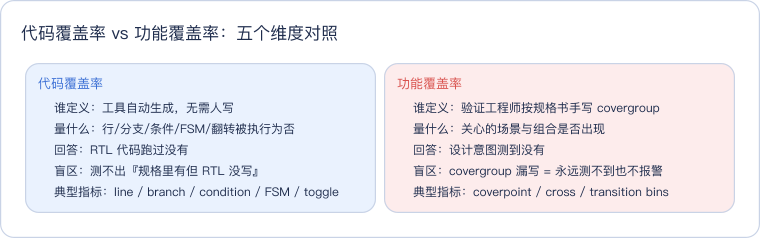
读这张卡抓住一条主线:左栏是"自底向上"的度量(从代码出发),右栏是"自顶向下"的度量(从规格出发)。正因为出发方向相反,两者才能互相补盲——代码覆盖率抓得住"写了没跑"的死代码,功能覆盖率抓得住"规格要测但激励没造"的场景空洞。
三条理由:为什么不能互相替代
理由一:代码覆盖率测不出"规格有、RTL 没写"的功能缺失
代码覆盖率的统计对象是 RTL 代码本身。假设规格书要求 FIFO 支持"满时写保护",但 RTL 作者忘了实现这个功能——那么 RTL 里根本没有对应的代码行,代码覆盖率对此完全无感,照样可以 100%。只有功能覆盖率里有人写了"full=1 且 wr_en=1 时数据不变化"这个 coverpoint,才能在回归里发现这个场景从来没被验证过,进而追问出 RTL 缺功能。
理由二:功能覆盖率测不出"写了但没跑"的冗余代码
反过来,功能覆盖率只盯着你定义的采样点。RTL 里一段没人调用的遗留逻辑、一个永远进不去的 default 分支,只要不影响你 cover 的场景,功能覆盖率就不会报警。这时候是代码覆盖率的 line/branch 报告把这段死代码标红,逼你去确认:到底是测试没激励到,还是代码本身就是多余的。
理由三:两者的"定义者"不同,决定了信任级别不同
代码覆盖率是工具从代码结构机械推导的,不依赖人的判断,所以它客观但浅——它不知道"测到什么程度算够"。功能覆盖率依赖验证工程师对规格书的理解,所以它深刻但主观——covergroup 写漏了,指标再好看也是假象。这也是为什么覆盖率评审(coverage review)的重点永远在功能覆盖率一侧:机器数的东西不用评审,人写的东西才要评审。
一张关系图:两条线如何汇合到签核
这张图的分层主线是:上面两个紫色块是"源头"(规格书派生出 RTL 和验证计划),中间两个蓝色块是"度量"(各自从一条源头线采数据),绿色块是"汇合点"(签核评审)。注意图里两条度量线互不交叉——代码覆盖率只从 RTL 出发,功能覆盖率只从验证计划出发,这正是它们无法互相替代的结构原因。
一个具体例子:4 深度 FIFO
假设要验证一个深度为 4 的同步 FIFO,规格书列出的关键场景包括:空读保护、满写保护、同时读写、复位后立刻读写。
回归跑完后:
- 代码覆盖率报告:line 100%、branch 92%——有一个分支没走到,查出来是"写指针回绕"的边界分支,补上定向用例后到 100%。
- 功能覆盖率报告:78%——"full 且同时读写"这个 cross bins 从来没命中过,原因是激励生成器把写使能约束得太保守,full 状态下从不再发写请求。
这个例子里两个数字说的完全是两件事:92% 的分支覆盖率指向 RTL 里一段具体代码,78% 的功能覆盖率指向激励生成器的一个约束漏洞。只看前者,你会以为"快测完了";只看后者,你不会发现回绕分支根本没跑过。两个报告并排看,才拼得出完整的验证进度。
功能覆盖率的内部结构(速览)
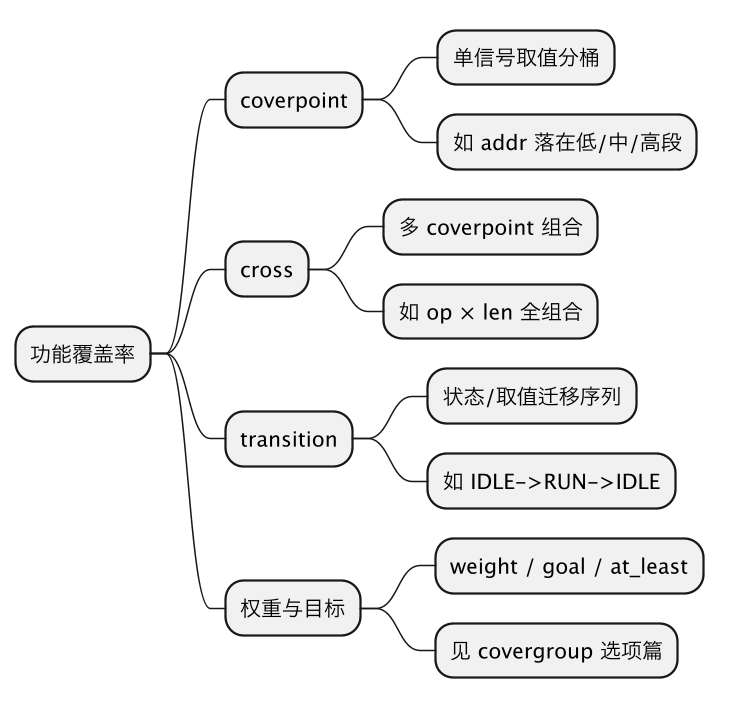
这张思维导图给出功能覆盖率的三类基本构件:单点取值的 coverpoint、组合关系的 cross、时序迁移的 transition,外加一套控制"怎么算测够"的权重选项。日常写覆盖率,80% 的工作量在前两类——把规格书里的功能点拆成 coverpoint,再对关键组合建 cross。深入写法见 covergroup cross 与 illegal bins 和 transition bins 用法。
常见误区
| 误区 | 真相 |
|---|---|
| 代码覆盖率 100% = 验证完成 | 只说明没死代码,规格场景可能一半没测 |
| 功能覆盖率是工具自动生成的 | 不是,每个 covergroup 都是人按规格书写的 |
| 两类覆盖率有一个高就行 | 签核要求双高,且要做覆盖率合并与评审 |
| 覆盖率数字越高芯片越没 bug | 覆盖率只量"测没测到",不量"测得对不对"——检查器(assertion/scoreboard)才管对错 |
这一篇在知识体系里的位置
本篇是验证入门篇,回答"两类覆盖率是不是一回事"这个最常见的第一问。往下深入的路径:
- 代码覆盖率与功能覆盖率详解:两类覆盖率的完整定义与工具侧行为。
- covergroup 与 coverpoint 基础:功能覆盖率怎么写。
- 覆盖率空洞分析流程:覆盖率卡在 90% 不动时怎么办。
- 测试计划与覆盖率映射:从规格书到 covergroup 的工程化方法。
- 功能覆盖率闭环计划:收敛阶段的整体打法。
一句话总结
功能覆盖率和代码覆盖率不是一回事:代码覆盖率是工具自动数的"RTL 跑过没有",功能覆盖率是人按规格书写的"设计场景测到没有";一个自底向上抓死代码,一个自顶向下抓场景空洞,验证签核必须两份报告都站得住才算闭环。