测试台性能剖析:仿真慢在 DPI、覆盖率还是打印?
更新时间:2026-09-30。本篇是验证性能主题的中间级长尾篇:假设你已经能搭起 UVM 组件与 phase 机制 描述的环境、跑过 SystemVerilog 代码覆盖率与功能覆盖率,现在的问题是回归一晚上跑不完。测试台性能剖析(testbench profiling)就是把"仿真慢"从一个感觉变成一张分时账单的过程——先测量,再优化,顺序不能反。
本文要回答的问题
- 仿真器自带的 profile 报告长什么样,哪些列决定优化优先级?
- 为什么 DPI 调用经常是测试台侧的第一热点,边界开销从哪来?
- 打开功能覆盖率后仿真慢一倍,是 covergroup 写法问题还是采样时机问题?
$display和 UVM 打印对性能的伤害有多大,怎么定量收紧?- 优化完怎么证明"确实变快了"而不是幻觉?
一、先测量:profile 报告是唯一裁判
工程师面对慢仿真的本能反应是"我觉得是 scoreboard 慢",然后花两天重写 scoreboard,回归时间纹丝不动。测试台性能剖析的第一条纪律:任何优化动作之前,先跑一次 profiling,拿到按模块/类/函数拆开的 CPU 时间分布。三大仿真器都内建了 profile 开关:VCS 用 -simprofile,Xcelium 用 -profile / simvision 里的 profiler,Questa 用 vsim -profile 配 profile report。打开开关本身会再拖慢 10%~30%,所以 profiling 只跑一条代表性短测试(比如正常回归里 10 分钟的冒烟用例),不要直接挂整晚回归。
一份典型报告会把墙钟时间拆成这几栏:
| 栏目 | 含义 | 健康占比参考 |
|---|---|---|
| HDL/Kernel | DUT 与接口的事件求值 | 门级 70%+,RTL 30%~60% |
| Class/Testbench | SystemVerilog 类代码(UVM 环境本体) | 20%~50% |
| DPI | C 参考模型、checker 的跨语言调用 | < 15% |
| Coverage | 代码覆盖率 + covergroup 采样 | < 20% |
| PLI/VPI、其他 | 波形 dump、外部工具钩子 | 视 debug 需求 |
占比超参考线的那一栏就是主战场。注意一个细节:profile 报的是 CPU 时间,如果你看到墙钟远大于 CPU 时间总和,瓶颈其实在磁盘 I/O——波形文件写爆、日志目录挂在网络盘上,这类问题 profile 报告里看不到,要用 iostat 或看仿真器自带的 I/O 统计另查。
二、热点地图:五块时间的典型流向
下图把一次 RTL 级 UVM 回归的 CPU 时间拆成五块,并标出每块最常见的"异常放大器":
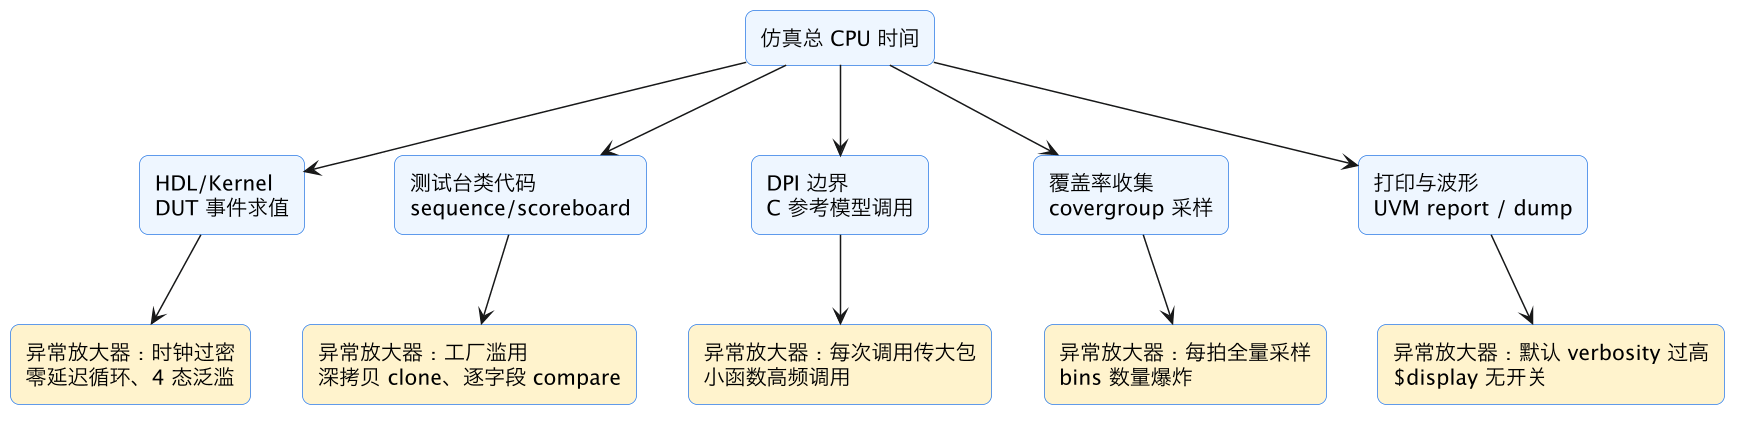
读这张图的方式是从左到右先问"哪块占比最大",再顺着它下面的黄色卡片核对症状。实际项目里 RTL 级回归最常见的前三名是:测试台类代码失控(UVM 用法问题)、DPI 边界摩擦(参考模型接得不对)、覆盖率写法粗放。HDL 本体慢通常轮不到验证工程师优化,那是设计侧的事——但如果 HDL 占比异常高且 DUT 很小,要检查测试台里有没有零延迟死循环把仿真时间卡在原地空转。
三、DPI 开销:跨语言边界的过路费
DPI(Direct Programming Interface)让 SystemVerilog 直接调 C 函数,是接参考模型、固件库的标准手段,相关集成方法见 SystemVerilog DPI 与 C/C++ 集成。性能上要记住一个量级:单次 DPI 调用本身有几十到几百纳秒的边界开销(参数封送、上下文切换),调用一次不心疼,每拍调用上万次就成了主热点。
三类最典型的 DPI 反模式:
- 逐字节/逐拍调用:把"每来一个 flit 调一次 C 函数检查"写成接口契约,一笔 4KB 的 DMA 传输变成几万次调用。改成批量接口——SV 侧攒一个 transaction 或一整块 buffer,一次
import "DPI-C"调用传 open array 过去,C 侧循环处理,边界开销摊薄到可忽略。 - 大结构体按值传递:SV 的 struct/packed 数组跨 DPI 边界要逐字段转换。能传指针(
chandle)就别传数据本体,C 侧只在需要时回读;必须在 SV 侧消费的结果也优先用 output 参数挂在同一次调用里,避免一来一回两次调用。 - 在 C 里又调回 SV(export)形成乒乓:DPI export 的开销比 import 更高,C→SV→C 的调用链每多一跳贵一截。profile 里看到 DPI 高且调用计数离谱时,先数"每秒跨边界次数",这个数字降下来比优化任何一端的本体代码都有效。
四、覆盖率收集:采样时机与 bins 数量决定代价
打开功能覆盖率后仿真慢 30%~100% 是常态,但其中一多半是写法问题。covergroup 的开销 = 采样频率 × 每次采样的求值成本。两个旋钮各自对应一类错误:
- 采样时机失控:
@(posedge clk)直接当时钟使能,意味着每一拍都把所有 coverpoint 表达式算一遍。协议覆盖率几乎从不需要每拍采样——把采样事件改成"valid && ready握手成功时"或显式调用cg.sample(),采样次数常常下降一到两个数量级,覆盖结果完全不变。 - bins 爆炸:cross 两个 256 值的 coverpoint,不加约束就是 65536 个 bin,每个 bin 都要维护命中计数。用
cross里的binsof/ignore_bins 收敛到语义上有意义的组合,或参考 covergroup 交叉覆盖率与 bin 过滤 的写法把无效组合在定义期就删掉。
还有一个容易被忽视的选项:option.per_instance 多开时每个实例独立维护一份计数,16 路 agent 就是 16 倍内存和采样开销——如果通道间同构,评估一下能否用 type_option.merge_instances 合并统计,相关取舍见 covergroup option 选项:per_instance、at_least、goal、weight 与 type_option。代码覆盖率那边同理:回归主力用 line+cond,branch/fsm/toggle 留给覆盖率专项跑,不要所有开关常年全开。
五、打印与波形:最便宜的优化往往在这
$display 写一行字看起来免费,但它在仿真热点循环里是真金白银:字符串格式化在 SV 侧做,I/O 走文件缓冲,profile 里经常看到一个$display 吃掉 5% 以上的 CPU。UVM 的 uvm_info 稍好,因为 verbosity 过滤在消息对象构造之后才生效——低 verbosity 的消息虽然最终不打印,字符串拼接 $sformatf 的参数却已经算完了。正确写法是用反引号宏(`uvm_info 自带惰性求值)或在昂贵拼接前手动 if (uvm_report_enabled(...)) 判断,系统性的收紧方法见 UVM report verbosity 控制。
波形 dump 同理:回归跑分数时全层次 dump FSDB 纯属浪费,只在失败用例重跑时按种子重放开波形。一条健康的回归策略是"默认安静、失败吵"——pass 用例只留 summary,fail 用例自动加 verbosity 和 dump 重放。
六、验证收益:优化前后用同一杆秤
每改一处,重跑同一条测试、同一个种子,对比三项:墙钟时间、profile 报告里目标栏的占比、仿真结果一致性(log diff 除时间戳外应为空)。把每次优化前后的数字记进一张小表,攒几次就是团队内部的"优化手册"——哪种手法在你们的设计规模下值多少,只有自己的数据可信。当单条测试已经压到极限,剩下的提速手段在系统层:并行回归、测试切片、失败用例优先调度,这些属于 回归管理与 triage 的范畴,本篇不再展开。
这一篇在知识体系里的位置
- 同层配套:SystemVerilog DPI 与 C/C++ 集成 讲 DPI 怎么接,本篇讲接完之后怎么让它不快也能跑快;UVM report verbosity 控制 是打印收紧的完整手法清单。
- 上游原理:SystemVerilog 代码覆盖率与功能覆盖率 解释覆盖率在收集什么,本篇第四节是它的性能账单。
- 下游延伸:单测试优化到顶后,看 回归管理与 triage 把整条回归流水线排得更聪明;仿真 vs 硬件加速的取舍见 仿真、Emulation 与原型验证怎么选。
总结
测试台性能剖析的核心是"先测量、再动刀":用仿真器 profile 报告把 CPU 时间拆到 HDL、类代码、DPI、覆盖率、打印五块,谁超标治谁——DPI 靠批量接口摊薄边界开销,覆盖率靠采样时机和 bins 收敛降频次,打印靠惰性求值和"默认安静"策略,每改一处都用同测试同种子复测验证收益。