Vivado 综合到比特流:WebPACK 免费授权全流程实测(RTL→bit 一条命令跑完)
更新时间:2026-10-27。本文是 FPGA 入门层的一篇实验文。FPGA 设计七步全流程 已经把「RTL → 综合 → 实现 → 比特流」的概念地图画清楚了,Vivado 快速上手 演示了 GUI 点击式操作;本篇回答一个更实际的问题——**不花一分钱授权费、不点一下鼠标,能不能把一段 Verilog 一路跑到可以烧录的 .bit 文件?**我们在 Vivado 2017.4 WebPACK(免费版)上针对 Arty A7-35T 开发板的 xc7a35t 器件真机实跑,答案是:一条
vivado -mode batch命令,3 分 24 秒,全程无人值守。
本文要回答的问题
- Vivado WebPACK 免费授权到底够不够用?xc7a35t 这类器件在不在免费范围里?
- 不用 GUI,怎样用一条命令把 RTL 源码跑到比特流文件?
- 综合、实现、生成比特流各阶段的真实日志长什么样,哪些行必须看?
report_utilization和report_timing_summary两份报告里的关键数字怎么读?
先给结论卡,四个数字全部来自后文真实构建日志与报告文件:
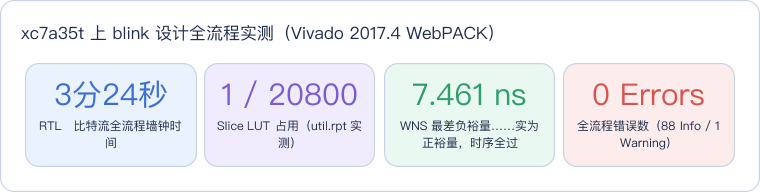
读这张卡抓住一个事实:一个 27 位计数器点亮 4 个 LED 的最小设计,在 3.5 万逻辑单元的 xc7a35t 上只用了 1 个 LUT 和 27 个触发器,时序裕量宽裕到 7.461 ns——免费授权对入门学习不仅「够用」,而且性能余量大得惊人。下面是这次构建的终端实录节选:
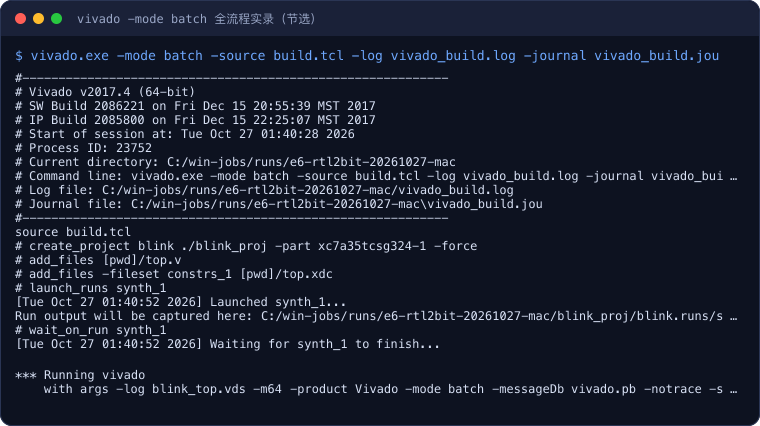
这份实录的头部信息值得逐行读:Vivado v2017.4 (64-bit) 确认工具版本,Command line: vivado.exe -mode batch -source build.tcl 是本次实验的唯一入口命令——工程创建、加文件、综合、实现、生成比特流全部由 build.tcl 一个脚本驱动,没有任何人工点击。日志接下来的 source build.tcl 与 create_project blink ./blink_proj -part xc7a35tcsg324-1 -force 两行,就是批处理模式的「工程初始化」动作。
一、WebPACK 免费授权到底能用什么
很多入门教程默认读者已经装好「Vivado」,却不提授权问题——而授权恰恰是新手第一道坎。先把结论说死:
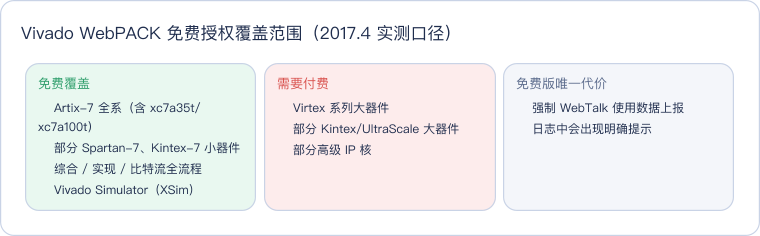
读这张卡按颜色分工:绿色栏是入门者真正关心的——Artix-7 全系免费,本篇用的 xc7a35tcsg324-1(Arty A7-35T 开发板上的芯片)就在免费范围里;红色栏是付费墙位置,基本不影响入门学习;灰色栏是免费版唯一的「代价」。这个代价不是嘴上说的,本次真实日志里就白纸黑字印着:
INFO: [Project 1-120] WebTalk data collection is mandatory when using a WebPACK
part without a full Vivado license. To see the specific WebTalk data collected
for your design, open the usage_statistics_webtalk.html or
usage_statistics_webtalk.xml file in the implementation directory.
这行 INFO 是 WebPACK 身份的「指纹」:看到它就说明你跑的是免费授权,工具会向 Xilinx 上报匿名使用统计,功能本身一刀未砍。另外值得注意的一个事实:2017.4 是 2017 年底发布的老版本,到本文实验日已快九年,免费授权照样全流程跑通——学习用途完全不必追新版本,老版本资源占用小、教程存量大,反而是入门的稳妥选择。
授权问题在日志里还有两个旁证。综合启动时工具会显式尝试申请许可——Attempting to get a license for feature 'Synthesis' and/or device 'xc7a35t',紧接着 Got license 表示 WebPACK 内置的免费许可直接命中;流程末尾又有 Releasing license: Implementation 的对称释放。整套「申请-持有-释放」的许可握手对免费用户完全透明,不需要装任何 License 文件、不需要联网激活——这也是 WebPACK 与付费版在使用体验上的唯一流程差异:付费用户多一步 license 配置,免费用户反而开箱即用。
二、实验设计:27 位计数器点 4 个 LED
为了让「资源占用、时序裕量」这些数字有可对照的实物,实验设计选一个最小但完整的电路:100 MHz 晶振驱动一个 27 位自增计数器,取高 4 位 cnt[26:23] 直接驱动 4 个 LED——最高位约 0.75 秒翻转一次,肉眼可见流水闪烁。RTL 核心就这几行:
module blink_top (
    input  wire       clk,
    output wire [3:0] led
);
    reg [26:0] cnt = 27'd0;
    always @(posedge clk) cnt <= cnt + 1'b1;
    assign led = cnt[26:23];
endmodule
配套的 top.xdc 是 Arty A7-35T 的真实引脚约束:时钟接 E3 引脚(板上 100 MHz 晶振),四个 LED 分别接 H5 / J5 / T9 / T10,电平标准 LVCMOS33,外加一行 create_clock -period 10.000 [get_ports clk] 告诉时序引擎这是一个 100 MHz 时钟。约束的写法细节不是本篇重点,XDC 约束入门 有专门展开;这里只需要知道——没有 XDC,工具不知道时钟多快、信号从哪个引脚进出,比特流照样生成但烧上板子就是一块废铁。
为什么要取 cnt[26:23] 这四位而不是低四位?低 4 位以 100 MHz 的频率翻转,肉眼看去 LED 只是常亮;第 26 位每 2^26 / 100MHz ≈ 0.67 秒翻转一次,相邻三位依次快一倍,四个 LED 就呈现出「不同频率的闪烁叠加」。这个「计数器高位当慢时钟」的手法是 FPGA 点灯的通用套路,它顺带让设计里出现了一条真实的时序路径(27 位加法器进位链),后面的时序报告才有东西可看——一个纯组合直通的设计,时序报告会是空的。
三、一条命令跑完:build.tcl 批处理脚本
整个流程的驱动脚本 build.tcl 只有十行出头,对应 GUI 里的一串点击:
create_project blink ./blink_proj -part xc7a35tcsg324-1 -force
add_files [pwd]/top.v
add_files -fileset constrs_1 [pwd]/top.xdc
launch_runs synth_1
wait_on_run synth_1
launch_runs impl_1 -to_step write_bitstream
wait_on_run impl_1
open_run impl_1
report_utilization -file [pwd]/util.rpt
report_timing_summary -file [pwd]/timing.rpt -warn_on_violation
puts "FLOW_DONE bit=[glob -nocomplain ./blink_proj/blink.runs/impl_1/*.bit]"
把这条脚本流水线画成流程图,对照 FPGA 设计七步全流程 的概念地图看,批处理模式就是把七步里的「综合 → 实现 → 生成比特流 → 报告」四步固化成代码:
读这张图按颜色抓三条线:蓝色是「准备动作」(启动命令、建工程),橙色是「重体力活」(综合与实现,全流程 95% 的时间花在这里),绿色是「产出物」。-to_step write_bitstream 这个参数是关键——默认 impl_1 只做到布局布线,加上它才让实现流程一路走到比特流生成。整条链上每个 wait_on_run 都是硬同步:前一步不 Complete,后一步绝不启动,这正是 GUI 里点「Generate Bitstream」背后实际发生的事情。
脚本里还有两个容易被忽略的工程化细节。其一是 create_project 的 -force:重复执行时直接覆盖旧工程目录,保证脚本是幂等的——批处理脚本必须可以反复重跑,否则第二天改了一行 RTL 就得手工删目录。其二是 open_run impl_1 这一行:报告命令必须作用在「打开的运行结果」上,wait_on_run 只保证磁盘上的结果就绪,不显式 open_run,report_utilization 读到的是内存里的旧状态或干脆报错。这类「脚本在空工程能跑、在脏工程翻车」的坑,只有把脚本当正式代码维护、每次改完完整重跑一遍才能暴露。
四、真实日志逐段导读
跑批处理模式,日志就是唯一的「进度条」。全流程日志 760 行,摘三段最关键的。第一段是综合启动与授权检查:
Command: synth_design -top blink_top -part xc7a35tcsg324-1
Starting synth_design
Attempting to get a license for feature 'Synthesis' and/or device 'xc7a35t'
INFO: [Common 17-349] Got license for feature 'Synthesis' and/or device 'xc7a35t'
INFO: [Synth 8-638] synthesizing module 'blink_top'
INFO: [Synth 8-256] done synthesizing module 'blink_top'
这段里 Got license for feature 'Synthesis' and/or device 'xc7a35t' 是免费授权能否覆盖当前器件的判定点——WebPACK 遇到不支持的器件会在这一步直接报错停下,而我们这里顺利通过,用实测回答了第一节的问题。done synthesizing module 'blink_top' 标志综合完成,此时 Verilog 已经变成 LUT 和触发器组成的门级网表。
第二段是实现与比特流生成的收尾:
Creating bitmap...
Creating bitstream...
Writing bitstream ./blink_top.bit...
INFO: [Vivado 12-1842] Bitgen Completed Successfully.
INFO: [Common 17-83] Releasing license: Implementation
88 Infos, 1 Warnings, 0 Critical Warnings and 0 Errors encountered.
write_bitstream completed successfully读这段抓两个信号:Bitgen Completed Successfully 加上 write_bitstream completed successfully 才是比特流真正落盘的完整证据——只看到 Creating bitstream... 而没有这两行,说明中途失败了;汇总行 88 Infos, 1 Warnings, 0 Critical Warnings and 0 Errors 是构建质量的体检报告,0 Errors 是底线,Warnings 个数要纳入每次构建的对比(这次的 1 条 Warning 是 WebPACK 相关提示,不影响产物)。
第三段是脚本末尾的收尾打印,也是整条流水线的「成功哨兵」:
# puts "FLOW_DONE bit=[glob -nocomplain ./blink_proj/blink.runs/impl_1/*.bit]"
FLOW_DONE bit=./blink_proj/blink.runs/impl_1/blink_top.bit
INFO: [Common 17-206] Exiting Vivado at Tue Oct 27 01:43:48 2026...
日志时间戳给出了全流程的墙钟时间:01:40:24 启动、01:43:48 退出,共约 3 分 24 秒。其中综合约 1 分 40 秒,实现加比特流约 1 分 36 秒——对这种微型设计来说大头是工具启动和器件数据库加载,真正的布局布线只占零头。把 FLOW_DONE 这行打印放进脚本尾,是无人值守构建的标准手法:外层脚本(或 CI)只要 grep FLOW_DONE 就能判定成败,不需要解析几百行日志。
这里还有一个新手常踩的坑值得点名:launch_runs 是异步提交任务,命令本身立即返回、真正的编译在后台进行——如果脚本里漏掉 wait_on_run,后续命令会在编译还没结束时就开始执行,轻则报告读到旧数据,重则整个流程在半成品状态退出且不留明显错误。日志里的 [Tue Oct 27 01:40:52 2026] Waiting for synth_1 to finish... 就是 wait_on_run 生效的证据。写自己的批处理脚本时,每一对 launch_runs / wait_on_run 都要成对出现,这是 Vivado Tcl 脚本的第一条纪律。
五、资源与时序报告怎么读
构建成功只是第一步,两份报告才是设计的「体检单」。先看资源报告 util.rpt 的核心表格:
+-------------------------+------+-------+-----------+-------+
|        Site Type        | Used | Fixed | Available | Util% |
+-------------------------+------+-------+-----------+-------+
| Slice LUTs              |    1 |     0 |     20800 | <0.01 |
| Slice Registers         |   27 |     0 |     41600 |  0.06 |
| Bonded IOB              |    5 |     0 |       210 |  2.38 |
+-------------------------+------+-------+-----------+-------+
读这张表对照设计算一笔账:27 个 Slice Registers 正好是 27 位计数器 cnt 的一位一触发器;1 个 LUT 实现的是 cnt + 1 的进位链入口逻辑;5 个 Bonded IOB 对应 1 个时钟输入加 4 个 LED 输出。20800 个可用 LUT 只用了 1 个——这就是为什么入门学习根本不需要担心器件容量。资源报告的完整读法见 Vivado 资源利用率报告解读。
顺带一提这组数字为什么值得较真:27 位加法理论上需要一条 27 级进位链,但 7 系列 FPGA 的 Slice 里有专用进位硬件(CARRY4),加法器不占通用 LUT,所以 LUT 用量只有 1。如果哪天你发现一个「很简单」的设计资源占用远超预期,util.rpt 里逐层次展开的 LUT as Logic / LUT as Memory / F7 Muxes / F8 Muxes 各栏就是排查入口——它精确告诉你资源被谁吃掉了。
再看时序报告 timing.rpt 的汇总行:
Clock      WNS(ns)   TNS(ns)  TNS Failing Endpoints      WHS(ns)   THS(ns)  THS Failing Endpoints
sys_clk      7.461     0.000                      0        0.252     0.000                      0
两个数字必须看懂:WNS(Worst Negative Slack,最差建立时间裕量)7.461 ns 是正值,表示最紧张的一条路径也比 10 ns 时钟周期宽裕 7.461 ns——一个 27 位加法器在 100 MHz 下毫无压力;WHS(Worst Hold Slack,最差保持时间裕量)0.252 ns 同为正,保持时间也没问题。WNS 和 WHS 都为正、Failing Endpoints 全为 0,是「时序收敛」的判定标准;任何一项为负,烧上板子就可能随机出错。报告里 sys_clk {0.000 5.000} 10.000 100.000 一行则回显了时序引擎识别到的时钟:周期 10.000 ns、频率 100 MHz,与 XDC 里 create_clock -period 10.000 的约束严丝合缝——如果这里显示的周期和你写的不一样,说明约束根本没被正确读入,后面的裕量数字再漂亮也没有意义。时序报告的系统读法见 Vivado 时序报告入门。
六、GUI 对照:同一份工程的图形界面视图
批处理跑完后,同一个工程用 GUI 打开看是什么效果?下图是 Vivado 2017.4 IDE 打开本工程后的主界面:
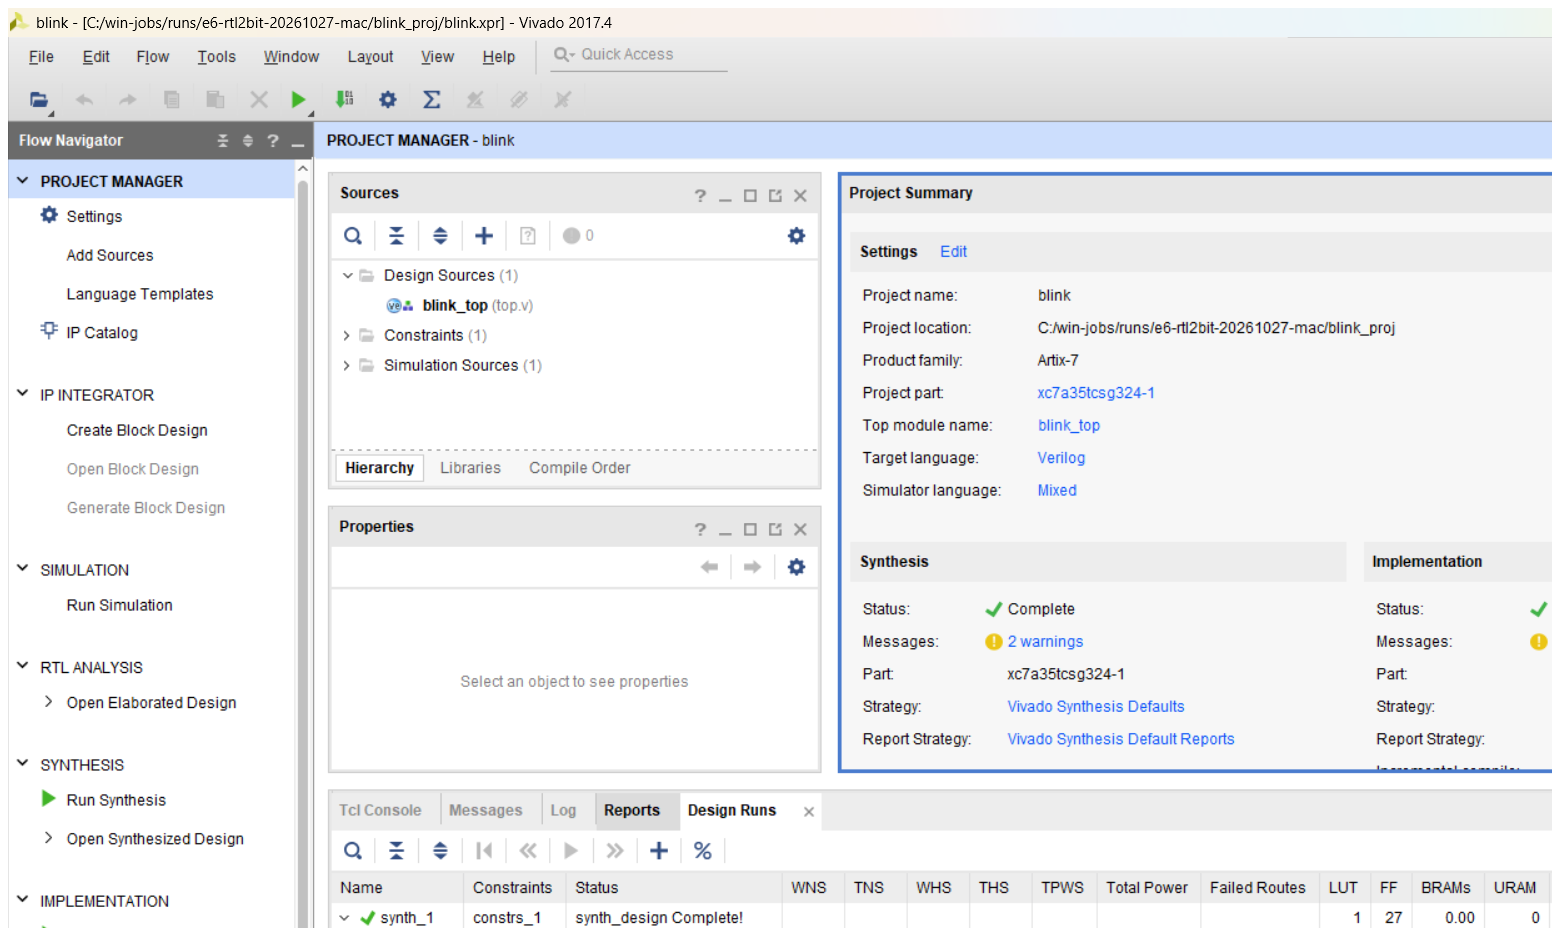
读这张图看三个位置。左上的 Project Summary 面板显示 Synthesis 与 Implementation 双 Complete、part 为 xc7a35tcsg324-1,与日志口径一致;下方的 Design Runs 表里 synth_1 一行状态 Complete,并直接列出了 LUT 1 / FF 27 两个数字——正是上一节 util.rpt 里那两个数的 GUI 呈现;左侧 Flow Navigator 是 GUI 模式的「剧本目录」,点击其中的 "Generate Bitstream" 等价于批处理里的 launch_runs impl_1 -to_step write_bitstream。也就是说,GUI 与批处理走的是同一套引擎、同一份工程文件,区别只在「人用眼睛盯进度条」还是「脚本用 wait_on_run 等哨兵」。拿到 .bit 之后怎么烧进 Flash 让板子上电自启,见 比特流烧录与 Flash 固化。
两种方式的选择不必纠结,对照表如下:
| 维度 | GUI 点击式 | 批处理 vivado -mode batch |
|---|---|---|
| 首次学习成本 | 低,跟着向导走 | 需懂少量 Tcl |
| 可重复性 | 依赖人工记忆点击顺序 | 脚本即文档,一把复现 |
| 无人值守 / CI | 不可行 | 天然支持,grep FLOW_DONE 判成败 |
| 排错 | 弹窗直观 | 全文检索日志更强大 |
| 适用场景 | 探索、调试、看报告 | 回归、夜间构建、教学留档 |
入门阶段的建议是两样都会:探索期用 GUI 建立直觉,定型后立刻把操作固化成 build.tcl——这正是本篇实验脚本本身的由来。
另一个值得亲手的修改实验:把 top.xdc 里的 create_clock 改成 4.000 ns(250 MHz)再跑一遍,WNS 会从 7.461 ns 压缩到 1 ns 上下;再狠一点改成 2.000 ns,就能亲眼看到 WNS 变负、Failing Endpoints 不再是 0——-warn_on_violation 参数会让时序违例在日志里打出显眼告警。看过一次「约束收紧 → 裕量转负 → 报告报警」的完整因果链,对「时序收敛」四个字的理解就从名词变成了经验。
实验环境
- 机器/系统:i5-13500H / Windows 11
- 工具版本:Vivado v2017.4 (64-bit),SW Build 2086221(WebPACK 免费授权)
- 目标器件:xc7a35tcsg324-1(Arty A7-35T 开发板)
- 日期:2026-10-27
- 完整命令:
run.bat(内部执行vivado.exe -mode batch -source build.tcl -log vivado_build.log -journal vivado_build.jou,随后比对FLOW_DONE哨兵行并归集 util.rpt / timing.rpt)
代码获取
完整 RTL、约束与批处理脚本已同步到公开仓库:geek-doc.cn/experiments/vivado-rtl-to-bitstream-webpack,目录内含 top.v、top.xdc、build.tcl 与 run.bat,装好 Vivado(2017.4 或兼容版本)后在工程目录执行 run.bat,或在 Tcl Shell 里 vivado -mode batch -source build.tcl 即可复现本文全部结果。
这一篇在知识体系里的位置
- 概念地图:FPGA 设计七步全流程(本篇是它「综合→实现→比特流」段的实机跑通版);
- GUI 互补:Vivado 快速上手(点击式操作,本篇走命令行批处理口径);
- 约束前提:XDC 约束入门(top.xdc 每行语法的来历);
- 报告深挖:Vivado 资源利用率报告解读、Vivado 时序报告入门;
- 下游动作:比特流烧录与 Flash 固化(拿到 .bit 之后怎么让它上电自启)。
一句话总结
Vivado 综合到比特流在 WebPACK 免费授权下功能一刀未砍——xc7a35t 这类 Artix-7 器件全流程畅通,唯一代价是 WebTalk 数据上报;一条 vivado -mode batch -source build.tcl 把建工程、综合、实现、生成比特流固化为可复现脚本,实测 3 分 24 秒跑完、27 个触发器加 1 个 LUT、WNS 7.461 ns 时序全过,日志末尾一行 FLOW_DONE 就是无人值守构建的成败哨兵。