SV sformatf 格式化:$sformatf/$sformat 与结构化日志
更新时间:2026-09-28。字符串的基础操作与文件读写已经在 SystemVerilog 字符串与文件 IO 里讲过,这一篇只聚焦一件小事但每天都用的事:怎么把变量拼成一行可读、可检索的日志。SV sformatf 格式化看着是细节,写不好却会让整个回归日志既难读又难 grep,值得单独过一遍。
本文要回答的问题
$sformatf和$sformat只差一个字母,到底差在哪,什么时候用哪个?%0d里的0是什么含义?%p为什么能一次性打印整个结构体/数组?- 在裸 SV 环境和 UVM 环境里,怎么用格式化拼出「统一前缀、可分级、可 grep」的结构化日志?
一、$sformatf 与 $sformat:返回值与副作用的分界
两个系统任务做同一件事——按格式串把实参拼成字符串——区别只在结果去哪:
$sformatf(fmt, args...)是函数,把拼好的字符串作为返回值交给你,可以自由赋给变量、传给别的函数、参与字符串拼接。$sformat(str, fmt, args...)是任务,第一个实参是一个string变量,结果直接写回它,没有返回值。
string s1, s2;
int err_cnt = 3;

s1 = $sformatf("err_cnt=%0d at %0t", err_cnt, $time);  // 返回值
$sformat(s2, "err_cnt=%0d at %0t", err_cnt, $time);    // 写回 s2
绝大多数场景选 $sformatf:它可以内联在 $display、uvm_info、字符串拼接的任意位置,一行写完。$sformat 只在两种情形下顺手:一是要反复改写同一个 string 缓冲(循环里滚动构造);二是某些老代码库的历史习惯。注意一个隐蔽坑:$sformatf 是函数,参数里不允许含耗时语句,而 $sformat 的第一个实参必须是变量、不能是字面量或表达式——写错位置编译器才会告诉你哪个是任务哪个是函数。
和 C 的 sprintf 相比,SV 的这对 API 没有缓冲区溢出风险(string 是动态扩容的),类型检查也更宽松:实参和格式符类型不匹配时仿真器通常不会报致命错,而是按自己的规则转换,打出一堆莫名其妙的值——所以格式符写错不崩、但日志全错,这类 bug 全靠自查。
二、格式符速查与实战频率
| 格式符 | 含义 | 实战频率 | 备注 |
|---|---|---|---|
%0d / %d | 十进制(0 = 去掉前导空格) | 极高 | 计数、地址、ID 一律用 %0d |
%h / %0h | 十六进制 | 极高 | 总线地址/数据默认 16 进制 |
%b | 二进制 | 中 | 看独热码、mask 位用 |
%s | 字符串 | 高 | 拼 name、层级路径 |
%t / %0t | 时间($time 格式) | 高 | 日志时间戳标配 |
%p / %0p | 聚合类型整体打印 | 中 | 结构体、数组一把梭,调试利器 |
%m | 当前层级路径 | 中 | 裸 SV 环境替代 UVM 的 get_full_name |
%% | 字面 % | 低 | 打百分比时别忘了转义 |
裸 %d/%h 会按位宽右对齐、前面补空格,日志列对不齐、grep 出来的行还长一截——这就是老手写 %0d 的原因:宽度按实际值来,紧凑。下面这张速查图把「一条日志从变量到落盘」的拼法串起来:
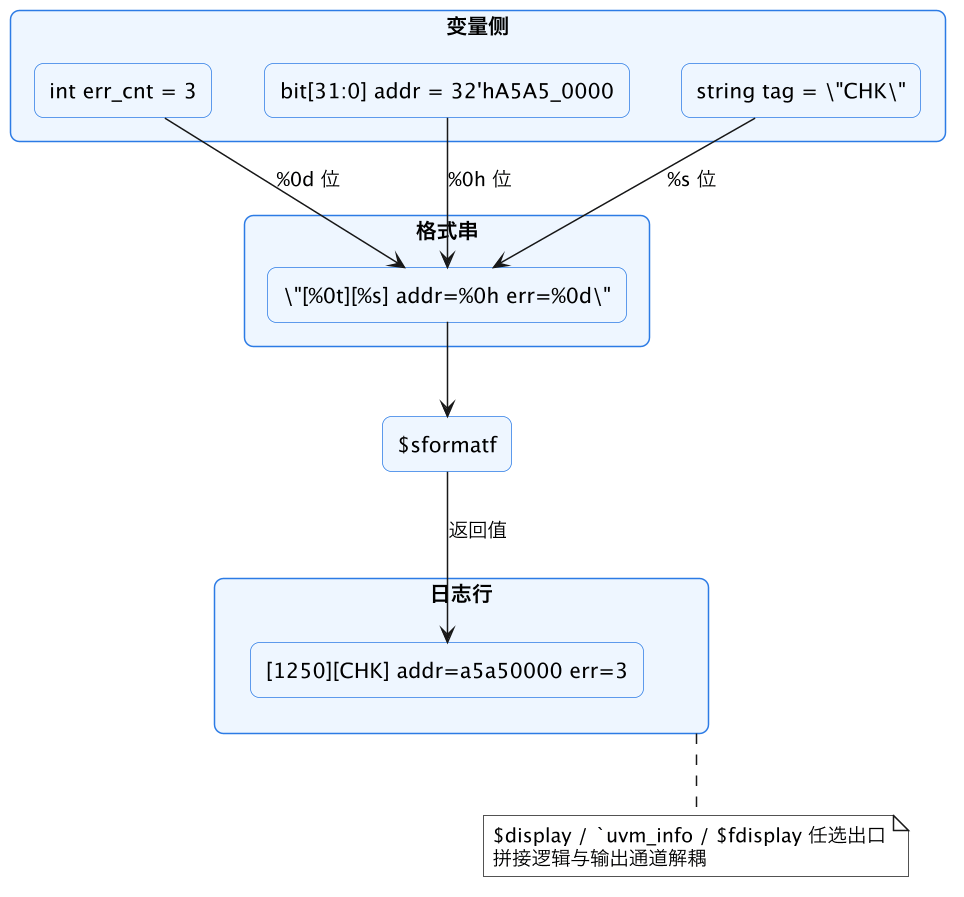
这张图的重点在最后那行注释:$sformatf 只负责「拼」,不负责「打」。拼好的串可以送 $display 到终端、$fdisplay 到文件、uvm_info 进 UVM 报告系统,同一条格式化逻辑可以服务三种出口——这就是「格式化」与「输出通道」解耦的价值,也是后面结构化日志方案的地基。
三、%p:打印结构体和数组的捷径
调试 transaction 时最烦的就是给每个字段手写一条打印。%p 直接接受任意聚合类型,按赋值图案(assignment pattern)风格整体展开:
typedef struct {
  bit [31:0] addr;
  bit [31:0] data;
  bit        write;
} txn_t;

txn_t t = '{32'h1000_0040, 32'hDEAD_BEEF, 1'b1};
$display("txn = %p", t);
// 输出:txn = '{addr:268435520, data:3735928559, write:1}
%p 对动态数组、队列、联合数组同样有效,%0p 去掉换行压成单行。它的定位是调试期的快速窥探,不是正式日志格式——字段以十进制展开、顺序依声明,不适合做长期稳定的日志契约。正式日志里 transaction 应该有自己的 convert2string(),里面用 $sformatf 逐字段按 %0h 拼,读日志的人看到的永远是 16 进制地址而非一坨十进制数。
四、结构化日志:统一前缀、可分级、可 grep
裸 SV 环境里没有一个统一的报告系统,各模块的 $display 格式百花齐放,回归日志几万行没法看。用 $sformatf 加一个公共函数就能立规矩:
function automatic string log_fmt(string lvl, string tag, string msg);
  return $sformatf("[%0t][%-5s][%s] %s", $time, lvl, tag, msg);
endfunction

// 使用
$display(log_fmt("INFO",  "CPU", $sformatf("reset done, pc=%0h", pc)));
$display(log_fmt("ERROR", "MMU", $sformatf("tlb miss @%0h", va)));要点有三条:一是时间戳在最前,同一拍的多条日志天然聚类;二是级别字段定宽(%-5s 左对齐补到 5 字符),grep "\[ERROR\]" 一刀切出全部错误;三是tag 字段标识来源模块,多 agent 日志交叉时一眼分辨归属。嵌套的 $sformatf 让每条日志的内容部分自由拼装,前缀部分永远一致。
到了 UVM 环境,`uvm_info 宏的第一个参数就是格式串、支持 $sformatf 风格的变参,前缀(时间、层级、ID)由报告系统自动补齐,此时不要再用 $display 混打——两套出口会让日志顺序错乱、severity 过滤失效。verbosity 与级别怎么配、怎么按组件调,见 UVM report 与 verbosity 控制,本篇不展开。需要落盘留存的关键日志(比如 scoreboard 的比对结果),用 $fdisplay(fd, log_fmt(...)) 走文件通道,终端通道继续交给 UVM,两条路互不干扰。文件句柄的打开与关闭细节同样在 SystemVerilog 字符串与文件 IO 里。
五、性能与可读性的平衡
格式化不是免费操作。$sformatf 每次调用都要做格式串解析和字符串堆分配,在高频路径上——比如每个时钟拍都打一条的 monitor 日志——一次仿真可能多消耗可观的内存与 CPU。两条实用纪律:一是先判开关再拼串,把 if (verbose) $display($sformatf(...)) 写成习惯,让关闭的日志连拼接开销都不付;UVM 宏内部就是这么做的(verbosity 不过直接短路),自己写裸 SV 时别忘了。二是高频日志字段定宽,地址用 %08h、计数用 %4d,等宽列让人眼扫波形对照日志时快得多,也让 awk 按列抽取统计成为可能。
另一个是长日志的拆分:一条日志超过约 200 字符,终端折行、grep 命中率都会变差。多字段的 transaction 打印宁可在 convert2string() 里用 \n 拼成「首行摘要 + 缩进字段块」的两段式,首行保持定宽可 grep,细节块给人读。这与 %p 的定位刚好互补——%p 给调试期的自己看,convert2string 给三个月后的自己和同事看。
六、常见坑速查
| 现象 | 根因 | 处理 |
|---|---|---|
| 数值打印出来全不对但不报错 | 格式符与实参类型不匹配(如用 %d 打 string) | 逐参数核对格式符;仿真器不强校验 |
| 日志列对不齐、前面一堆空格 | 用了裸 %d/%h 没带 0 | 一律 %0d/%0h |
$sformatf 里写 #10 之类报错 | 函数内不允许耗时 | 时间值先取到变量再传入 |
$sformat 第一个参数传表达式报错 | 第一参必须是变量 | 改用 $sformatf 返回值 |
| 结构体打印成单行十进制难读 | %p 的默认展开风格 | 正式日志用 convert2string 逐字段 %0h |
| UVM 日志顺序乱 | $display 与 `uvm_info 混用 | 统一走 UVM 报告通道 |
这一篇在知识体系里的位置
- 上游基础:SystemVerilog 字符串与文件 IO 讲 string 类型的操作与
$fopen/$fdisplay文件通道,本篇的日志落盘建立在它之上。 - UVM 侧出口:UVM report 与 verbosity 控制 负责日志的分级与过滤,本篇负责「消息体怎么拼」,两篇合起来覆盖日志全链路。
- 应用场景:虚接口下发时的路径拼接(
$sformatf("env.agt[%0d].drv", i))是格式化在配置机制里的经典用法,见 SystemVerilog 虚接口:动态赋值、重配与环境复用。
总结
SV sformatf 格式化的核心纪律是:$sformatf 出返回值、$sformat 写回变量,日常一律用前者;数值日志统一 %0d/%0h 去掉前导空格,聚合类型调试用 %p、正式日志走 convert2string;拼接与输出通道解耦,裸 SV 用一个公共 log_fmt 函数统一「[时间][级别][tag] 消息」前缀,UVM 环境则把消息体交给 uvm_info 宏——格式写对、出口统一,回归日志才既能给人读也能给 grep 读。