UVM 验证平台架构:一张图看懂 test/env/agent/driver/monitor/scoreboard
本篇是数字芯片验证方向的入门导读。读它之前,最好已经知道「为什么要先仿真再投片」(见 为什么先仿真)和「验证与测试的区别」(见 验证 vs 测试)。读完本篇你会对 UVM(Universal Verification Methodology,通用验证方法学)的标准骨架有全局认识,再去深入每个组件的细节(见 UVM 组件与 phase 机制、UVM sequence 与 driver、scoreboard)就不会迷路。
刚接触 UVM 的人打开一个真实项目,最常见的反应是:一个目录里几十个文件,class 套 class,uvm_component_utils 宏满天飞,却找不到「main 函数在哪」。这不是你基础差,而是 UVM 的设计目标本来就不是「写一个能跑的测试」,而是「搭一个能反复复用十年的验证平台」——为此它把激励生成、信号驱动、信号采样、结果比对拆成了固定角色,每个角色一个类,各司其职。本篇的任务就是把这套骨架一次讲清:一张分层图、每个组件一句职责、一笔事务在组件间的完整接力,最后和开源世界的 cocotb 角色做个对照。
本文要回答的问题
- UVM 验证平台为什么要分 test / env / agent / driver / monitor / scoreboard 这么多层?
- 每个组件的一句话职责是什么,它们之间靠什么连接?
- 一笔激励从「随机产生」到「判定对错」,在组件之间走的是怎样一条路径?
- 如果我用 Python 写 cocotb,这些角色分别对应什么?
- 学 UVM 的正确顺序是什么,哪些概念可以先放一放?
一、为什么验证平台要「分层」
先想清楚一个反问题:不分层会怎样?最朴素的 testbench 是一个 initial 块搞定一切——产生数据、驱动信号、采样输出、比对结果全写在一起。这种「大杂烩」在小模块上完全可行,问题出在复用上:换一个接口协议,驱动逻辑得重写;换一个待测设计(DUT,Design Under Test),比对逻辑得重写;同一个 DUT 跑一千条随机用例,每条用例又各自复制一份驱动代码。
UVM 的答案是按「变化的频率」切分:
- 几乎不变的:怎么把一笔事务翻译成信号时序(driver)、怎么从信号时序还原出事务(monitor)——这些只跟接口协议有关,跟「这次测什么」无关。
- 按环境变的:接几个接口、每个接口要不要主动发激励——这是 agent 和 env 层的组装决策。
- 每条用例都变的:发什么数据、按什么顺序发、期望什么结果——这是 test 和 sequence 层的事。
切完之后的收益非常实际:验证 IP(VIP)厂商可以把 driver/monitor 封装好卖给你;同一个 env 换不同的 test 就能跑冒烟、跑随机、跑边界;同一个 driver 在项目 A 的 block 级 env 和项目 B 的 SoC 级 env 里原样复用。这套「按变化频率分层」的思想不是 UVM 独创,软件工程里叫关注点分离,UVM 只是把它固化成了标准的类层次(更深入的讨论见 测试平台分层架构与复用)。
还有一个不常被提及的动机:分工。一个验证团队里,写 VIP 的人、搭 env 的人、写用例的人往往不是同一批。UVM 的分层恰好也是分工的边界——组件开发工程师关心 driver 的时序翻译是否忠实,集成工程师关心 agent 的 active/passive 配置,用例工程师只在 sequence 层打转。三层人各看各的一层,出问题时定位范围天然缩小。
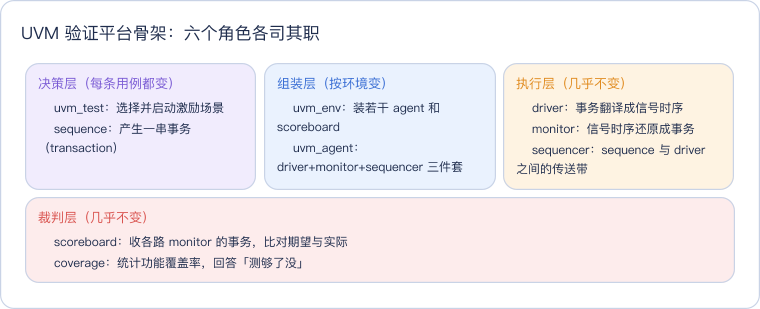
这张卡片就是全篇的地图:往下是「激励怎么进 DUT」,往右是「结果怎么判」。注意它的颜色语义——越靠近 DUT 的层(执行层)越稳定、越该复用,越靠近顶层的(决策层)越常变、越该轻量。记不住的组件先别背,跟着下面两个图走一遍就自然理解了。
二、组件分层图:谁装着谁,谁连着谁
UVM 平台的实例结构是一棵树:test 是根,env 挂在 test 下,agent 挂在 env 下,driver/monitor/sequencer 挂在 agent 下。树状包含关系解决「谁拥有谁」;组件之间真正的数据流动靠的是 TLM(Transaction Level Modeling,事务级建模)端口,事务对象沿着端口从一头流向另一头,组件之间不直接调对方的方法。
读这张图抓住三条线就够了。第一条是包含线:test 包含 env,env 包含 agent 和 scoreboard——这条线只在 build 阶段搭一次,搭完就不动。第二条是激励下行线(图左半边):sequence 把事务交给 sequencer,driver 从 sequencer 取事务、翻译成引脚电平变化,经 interface 打到 DUT 上。第三条是观测上行线(图右半边):monitor 是纯粹的「旁观者」,不驱动任何信号,只把总线上的时序还原成事务,广播给 scoreboard 和 coverage。橙色是 DUT,蓝色是两个 agent,红色 scoreboard 是裁判,绿色是覆盖率——一个健康的平台里,所有「对不对」的结论都只从 scoreboard 出来,所有「够不够」的结论都只从 coverage 出来。
有两个细节值得现在就知道。一是 agent 分 active 和 passive 两种模式:active 三件齐全(sequencer + driver + monitor),passive 只留 monitor——同一套 agent 代码,配一个 is_active 开关就能在「主动发激励」和「纯观测」之间切换,这是 SoC 级复用 block 级环境的常见手法(细节见 UVM agent 的 active/passive 模式)。二是输入输出两侧各挂一个 monitor 是刻意为之:scoreboard 不光要知道「DUT 吐出了什么」,还要知道「当时喂进去了什么」,两头都采才能做比对。
三、一笔事务的接力:从 sequence 到 scoreboard
分层图是静态结构,再看一遍动态过程就完整了。下面跟踪一笔写事务(比如往 AXI 总线写一个地址)从诞生到被判对错的完整旅程。
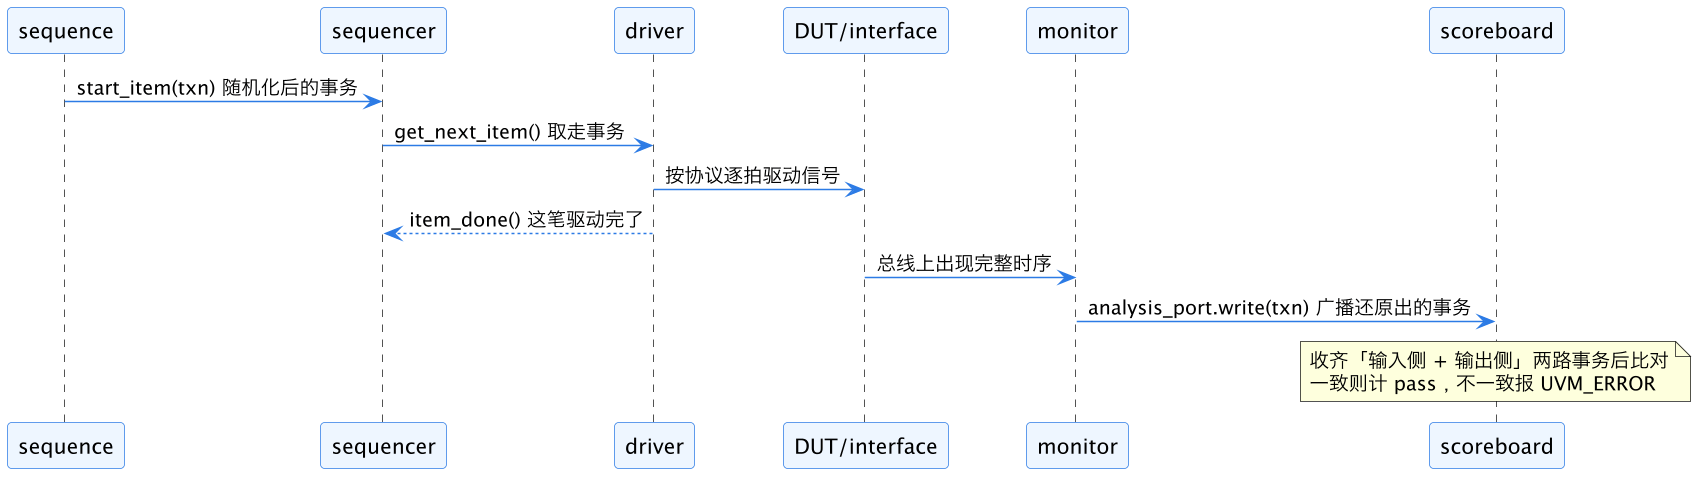
这条链上最容易被初学者忽略的是 sequencer 的角色:它不产生事务、不驱动信号,只做一件事——当多个 sequence 同时想往 driver 塞事务时,决定谁先谁后(仲裁)。可以理解成银行柜台的取号机:sequence 是顾客,driver 是柜员,sequencer 就是那台发号的机器。sequence 与 driver 之间「推事务 / 取事务 / 确认完成」的三步握手细节,展开讲能写一篇,这里先记住「driver 是主动来取的,不是被动被推的」这个方向感即可(深入见 UVM driver 与 sequence item 流转)。
monitor 到 scoreboard 那一跳也值得多看一眼:它用的不是「点对点连线」,而是 analysis port 广播——monitor 只管喊「我看到一笔事务」,不关心谁在听。同一个 monitor 的事务因此可以同时喂给 scoreboard、coverage 收集器、甚至一个打印日志的调试组件,加订阅者不用改 monitor 一行代码。这是 UVM 里「松耦合」做得最彻底的一处。
再补一个时间维度上的细节:driver 驱动一笔事务往往要花几十个时钟周期(比如一次 AXI burst 写要逐拍完成地址握手、数据握手、响应握手),而 sequence 产生事务是零仿真时间的「纯软件动作」。时间尺度差了好几个量级,所以 sequencer 与 driver 之间的握手天然是异步的——driver 处理完一笔才回来取下一笔。这个节奏差也解释了为什么激励侧可以肆无忌惮地随机、约束、排队,而不会拖累 DUT 那一侧的信号时序。
四、和 cocotb 的角色对照
如果你跑过本站的开源仿真实验(比如 最小 cocotb 测试平台 或 异步 FIFO 的 cocotb 验证),你可能会有个疑问:cocotb 里没有 test/env/agent 这些类,那 UVM 这套角色是 SystemVerilog 独有的吗?不是。角色是方法学层面的,cocotb 里同样的事情照样要做,只是没有强制你拆成固定的类。对照表如下:
| UVM 角色 | 一句话职责 | cocotb 里的对应物 |
|---|---|---|
| uvm_test | 选择并启动本用例的激励场景 | 一个 @cocotb.test() 装饰的协程函数 |
| sequence | 产生一串事务(可随机、可约束) | 生成事务的 Python 函数/生成器,或直接调 random |
| sequencer | 多路 sequence 之间的仲裁传送带 | 通常不需要;需要排队时用 asyncio.Queue |
| driver | 事务翻译成引脚时序 | 驱动协程:dut.data.value = x; await RisingEdge(dut.clk) |
| monitor | 时序还原成事务,纯旁观 | 独立的采样协程,只读信号不写 |
| scoreboard | 期望与实际比对 | Python 断言 + 参考模型(常是几行纯 Python) |
| coverage | 功能覆盖率统计 | cocotb-coverage 或手写计数 |
| factory/config_db | 运行时替换类型、下发配置 | Python 天然动态,函数参数/import 就能做到 |
这张表想说明两件事。第一,UVM 的复杂性大部分不是 UVM 发明的,是「可复用验证平台」这个目标本身要求的——cocotb 项目做大了,你也会自发地把驱动协程和采样协程分开、把参考模型从用例里抽出来,殊途同归。第二,反过来看,cocotb 是学这套方法学思想的好跳板:没有 phase、没有 factory、没有宏的干扰,角色分工一目了然;等你在 cocotb 里亲手体会到「driver 和 monitor 为什么要分开」(比如 cocotb 里 monitor 漏采一拍导致比对失败 这类问题),再回头看 UVM 的强制分层就顺理成章了。
当然两者也有本质差异:SystemVerilog 的约束随机(randomize() with {...})和 covergroup 是语言内建的,UVM 直接站在上面;cocotb 要靠 Python 生态自己拼。工业界大项目的签核级验证目前仍以 UVM 为主流,这不是情怀,是覆盖率模型和 VIP 生态的沉淀。
实践上的建议是两条腿走路:学习阶段用 cocotb 快速建立「驱动、采样、比对」的肌肉记忆,因为它环境零成本、报错信息友好;求职和工业项目阶段则必须过 UVM 这一关——招聘 JD 里的「熟悉 UVM 验证方法学」指的 essentially 就是本篇这张骨架图加 phase、factory、RAL 那几个大件。
六、三个常见误解
入门阶段有三个说法流传很广,值得当面澄清:
- 「UVM 是一套仿真器功能」——不是。UVM 本身只是一套用 SystemVerilog 写的开源类库(Accellera 发布、IEEE 1800.2 标准化),仿真器负责跑 SystemVerilog,UVM 类库跑在仿真器里。这也解释了为什么换个仿真器,UVM 代码基本可以原样带走。
- 「组件越多越专业」——错。一个 FIFO 的 block 级验证,一个 agent 加一个 scoreboard 足矣;硬上 virtual sequence、寄存器模型只是给自己挖坑。架构是为复用服务的,没有复用需求时,简单就是正义。
- 「scoreboard 里要写 DUT 的完整功能」——也不对。scoreboard 里的参考模型只需要「对到能抓住 bug」的精度:有时是一张期望值表,有时是一个简化行为模型,有时只是「输出必须等于延迟 N 拍后的输入」这样一条性质。把参考模型写成第二个 DUT,等于把验证成本翻倍,还引入「两个实现一起错」的风险。
回到本篇开头那张卡片再看一眼:六个角色的颜色编排其实就回答了「为什么学 UVM 总觉得东西多」——它把决策、组装、执行、裁判四类关注点全摆在了明面上。看懂这层意图之后,每个新组件出现时你只问一句「它属于哪一层、替代谁的变化」,就能快速归位。
五、先不用急的概念
UVM 全貌里还有不少大件本篇刻意没展开,列出来说是让你知道「它们存在、但入门阶段可以缓」:
- phase 机制:UVM 把仿真分成 build/connect/run 等阶段按序执行,保证树搭好了才连线、线连好了才跑激励。入门先记住「build 阶段自顶向下建组件」一条就够,细节见 UVM 组件与 phase 机制。
- factory 与 config_db:一个负责「运行时不改代码换组件类型」,一个负责「自顶向下下发配置」。它们是为了复用而生的,等你第一次需要「同一 env 跑两种 driver 行为」时再学不迟。
- 寄存器模型(RAL):把 DUT 的寄存器地址映射成对象,前门/后门访问都走它。属于寄存器验证专题,有自己的一篇 UVM 寄存器模型集成。
- virtual sequence / sequencer:多 agent 协同时的「总导演」,负责跨接口编排激励时序。
本篇的诚实声明:本站没有开源的完整 UVM 仿真环境(UVM 库需要商业仿真器如 VCS/Questa/Xcelium 才能完整运行,开源仿真器支持有限),所以本篇是纯概念图解,没有配套的可运行实验——想动手跑验证实验的读者,请移步 cocotb 实测系列(最小测试平台、AXI-Lite slave 验证),角色思想是相通的,只是语法换成了 Python。
这一篇在知识体系里的位置
- 上游(先修):为什么先仿真、验证 vs 测试——搞清楚验证在整个芯片流程里的位置。
- 同层深入:SystemVerilog 测试平台基础(语言层)、UVM 组件与 phase(生命周期)、UVM sequence 与 driver、scoreboard(本篇时序图的代码版)。
- 横向对照:最小 cocotb 测试平台、异步 FIFO 的 cocotb 验证——同样的角色思想在 Python 世界的落地。
- 后续方向:约束随机验证(激励怎么来)、代码与功能覆盖率(怎么知道测够了)。
一句话总结
UVM 验证平台架构的本质是「按变化频率分层」:几乎不变的 driver/monitor/scoreboard 沉在底层做复用,每条用例都变的 test/sequence 浮在顶层做裁剪;一笔事务走「sequence 产生 → sequencer 仲裁 → driver 翻译成信号 → DUT → monitor 还原成事务 → scoreboard 比对」的固定接力,组件之间靠 TLM 端口松耦合相连;这套角色分工不是 SystemVerilog 独有,cocotb 里照样要驱动与采样分离、激励与比对分离——记住那张六角色地图,再去看任何一份真实 UVM 代码,都不会再找不到北。