channel-based vs abutted 层次化布图:时序预算、绕线与 pin 对齐的取舍深讲
更新时间:2026-10-03。层次化物理实现的第一步不是摆宏,而是决定 block 之间「怎么接壤」。本站 floorplan 宏单元摆放策略 讲的是平铺设计里 memory 和 IP 宏怎么摆,floorplan 与 powerplan 讲的是电源网格怎么随形状走,层次化流程 ILM/ETM 讲的是接口模型怎么抽象。这一篇往上游再走一步:当一个大芯片被切成十几个 block 各自实现时,这些 block 在顶层是「隔着通道相望」(channel-based)还是「贴脸拼接」(abutted)?这个选择直接决定时序预算怎么分、顶层绕线资源够不够用、pin 对齐要花多少人力。选错风格,后面所有 block 都在为一个错误的拓扑还债。
本文要回答的问题
- channel-based 与 abutted 两种层次化布图风格在物理形态上的本质差别是什么?
- 顶层时序预算在两种风格下分别怎么切分,谁留的裕量更大、为什么?
- 顶层绕线资源(feedthrough、跨 block 走线)在两种风格下的压力有何不同?
- pin 对齐(pin alignment)为什么成为 abutted 风格的最大工程成本?
- 什么样的设计该选 channel,什么样的设计该上 abutted,有没有混合形态?
一、两种风格的物理形态:留缝还是贴边
层次化设计把整颗芯片划分成若干 block(也称 partition),每个 block 独立完成布局布线,顶层只负责拼接。拼接有两种基本几何形态。
channel-based(通道式):block 之间保留明确的间隙,形成横竖交错的布线通道。block 的 pin 可以打在自己四边的任意位置,顶层布线器在通道里完成 block 到 block 的互连。这是最早、也最经典的层次化形态——早期的门海和标准单元布图就是靠通道吃饭的。
abutted(贴边式,也称 no-channel / butt-joint):block 边界两两贴合,共享一条边,通道宽度为零。跨 block 的信号不再「下到通道里绕」,而是 A 块在边界上打一个 pin,B 块在镜像位置打一个 pin,两个 pin 物理上正对,直连或只隔几微米金属。这是先进工艺下大芯片(尤其是 SoC、AI 加速器)的主流形态,因为它消灭了通道面积和通道绕线。
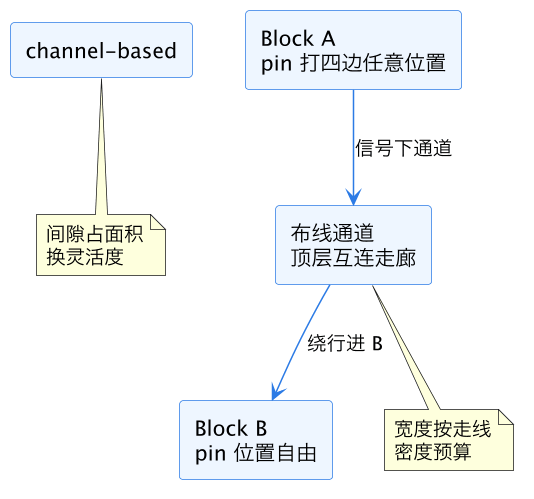
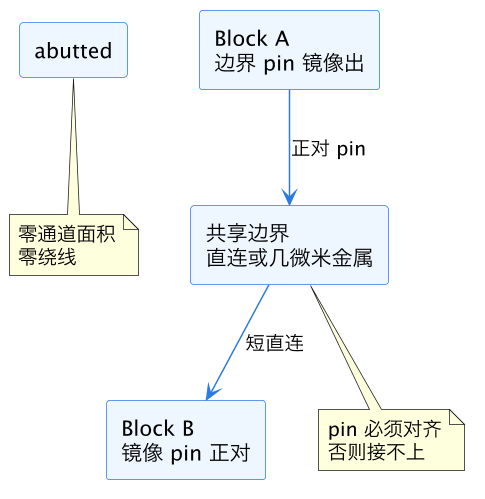
上面两张图是两种形态的剖面。读图时盯住「信号从 A 到 B 走了多远」:channel 风格里信号要出块、下通道、沿通道走、再进块,路径是折线;abutted 风格里信号几乎直线穿过共享边界。这一个几何差异,就是后面时序、绕线、成本所有差异的根。
二、时序预算:谁给 block 留了喘息空间
层次化流程里,顶层要把每条跨 block 路径的时序预算切成「A 块内一段 + 顶层互连一段 + B 块内一段」,各 block 拿着自己那份预算独立收敛。预算切分在两 种风格下的难度完全不同。
channel-based 下,顶层互连段的延迟大头是通道走线,而通道宽度、走线层、绕行距离在布图阶段就能估得比较准——通道是顶层自己的地盘,顶层工程师对它完全可控。所以预算切分相对宽松:block 各拿走自己的份额,顶层留一份「通道税」,彼此接口处常见做法是加 budget margin(比如接口路径预算的 10%)或者直接在边界打寄存器,把跨块路径彻底切成两段块内路径。这种「边界寄存器」的纪律让 block 之间几乎时序解耦,各自收敛互不拖累,层次化流程 ILM/ETM 里接口模型的悲观度也主要来自这一段。
abutted 下,顶层互连段趋近于零,听起来是白捡的时序收益——确实,跨块路径的线延迟几乎消失,接口时序天然干净。但代价是预算切分变成了紧耦合:两个 pin 正对直连,意味着 A 块输出级的驱动能力、B 块输入级的负载、以及边界处那几微米金属的 RC 必须一起算进同一条路径,任何一块内部布局的变化都可能改变边界 pin 的时序环境。更微妙的是电压和 PVT 角的一致性:贴边的两个 block 若分属不同电压域或做了不同的 IR drop 预算,边界上的接口时序要用 数据流 X2 之 corners/modes MMMC 的多角组合仔细检查,channel 风格里这段是顶层兜底,abutted 里没有兜底人。
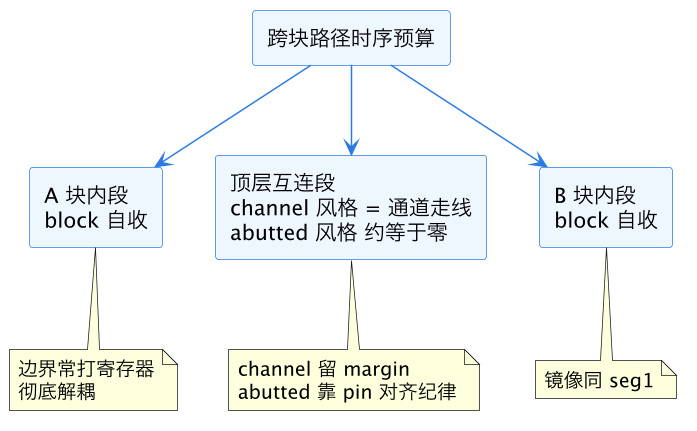
这张图是预算的三段切分。要点在中间一段:channel 风格把它当「要花钱但要花得明白」的走廊,abutted 风格把它压缩到接近零,但把成本转移到了 pin 对齐和接口约束上。时序收益不是免费的,只是付了另一种货币。
还有一个常被忽略的预算细节:跨块路径的时钟侧。channel 风格里两个 block 各自做自己的 CTS,顶层再补一段通道里的时钟走线,边界寄存器的时钟偏差可以按块内问题处理;abutted 风格里贴边寄存器往往分属两棵时钟树,边界上的 clock skew 直接吃进接口时序预算,需要在顶层统一规划时钟干线的入块点,让相邻块在共享边界附近的时钟到达时间尽量对齐。这笔钱在布图阶段不交,签核阶段会连本带利地讨回来。
三、绕线资源:通道宽度怎么算,abutted 的 feedthrough 怎么救
绕线侧,两种风格的矛盾点不一样。
channel-based 的核心问题是「通道开多宽」。开窄了,顶层互连走不下,后期被迫加宽就要动所有相邻 block 的边界——这在 block 已经各自收敛的中后期是灾难;开宽了,白白浪费面积,先进工艺下每一平方毫米都是钱。工程上通道宽度按「预估走线密度 × 层数 × 利用率」反推:先统计穿过该通道的 net 数(含总线和时钟),再按目标走线层和可接受的 track 利用率(通常 60% 到 70% 封顶,给串扰和 DRC 余量留空间,参照 布线拥塞 DRC 与串扰 的口径)折算物理宽度。总线密集处通道容易成为整片的「瓶颈走廊」,布图早期就要用 trial route 验证。
abutted 消灭了通道,但没有消灭「A 块到 C 块的信号」——中间隔着 B 块时怎么办?答案是 feedthrough(穿越走线):信号借道 B 块内部走线资源穿堂而过。这就要求 B 块在实现时预留穿越通道和对应 pin,B 块的布线资源被「不相干」的信号消耗。feedthrough 的管理是 abutted 流程里最繁琐的部分之一:哪些 net 允许穿越、穿越哪些层、在 B 块内部留下多少拥塞税,都要在 B 块开工前写进它的接口约束。规划漏了的 feedthrough,后期要么 ECO 开洞,要么改走相邻 block 绕大圈。
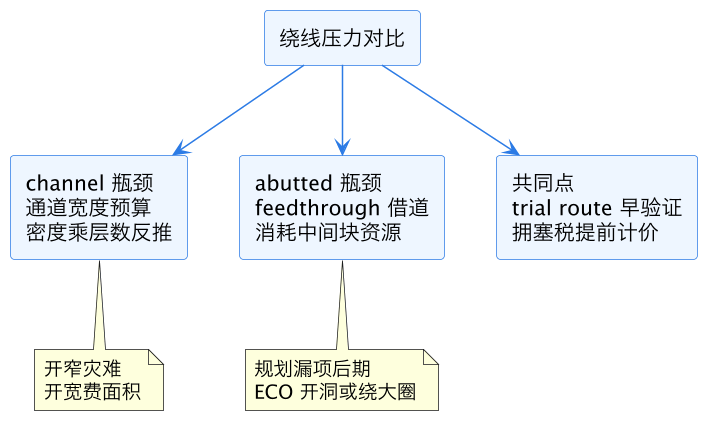
这张图把两种风格的绕线矛盾并排摆开。一句话读法:channel 的绕线问题集中在「通道这个公共资源的预算」,abutted 的绕线问题分散在「每个 block 为别人让路」的协调。前者是算术题,后者是管理题。
四、pin 对齐:abutted 的最大工程成本
如果说时序和绕线上 abutted 占优,pin 对齐就是它要还的债。两个贴边 block 的接口 pin 必须在共享边界上物理正对:坐标一致(或在同一 track 网格内容差)、金属层一致、宽度满足 DRC。一个几百 pin 的接口,靠手工对齐是不现实的,工程上靠三样东西支撑。
第一是 pin guide / pin constraint 文件:顶层布图阶段就冻结每条共享边界上的 pin 位置规划,以约束形式同时下发给两侧 block,block 实现时把 pin 钉死在指定坐标。这份文件是 abutted 流程的「接口宪法」,冻结后再改一处坐标,两边都要动。第二是 track 网格对齐:相邻 block 必须使用兼容的布线 track 起点和间距,否则即使逻辑坐标一致,物理 track 错半格,pin 就落在彼此的禁布区里。先进工艺下还要对齐 colored track(多重曝光着色),对齐维度从坐标扩展到颜色,DPT 双重曝光着色 的奇环问题在边界上尤其爱冒头。第三是边界单元的对称约束:贴边两侧的边界 row 末端、welltap/endcap 配置(见 welltap 与 endcap 摆放)必须按共享边界的规则裁剪,否则边界 DRC 会成片报错。
channel-based 几乎没有这些问题:pin 打在自己边界任意位置,顶层布线器在通道里自由连接,block 之间唯一的接口契约是逻辑网表和时序预算,物理层完全解耦。这种解耦还带来一个组织上的红利——不同 block 可以交给不同团队甚至不同地域并行实现,接口扯皮少。abutted 则要求两侧 block 的实现团队共享一份物理接口纪律,协作成本高出一截。
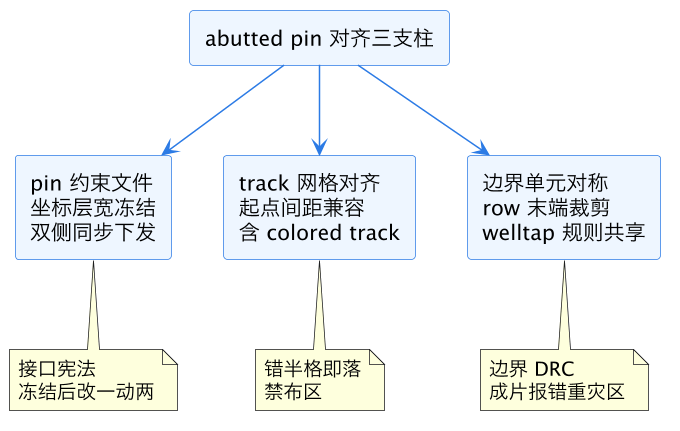
这张图是 pin 对齐的成本结构。读它时要意识到:这三支柱的任何一根松动,表现出来的都不是「对齐失败」这种直白错误,而是后期 DRC 修不完、接口时序莫名飘、block 之间反复返工——成本以一种弥散的方式兑现。
五、选型判据与混合形态
把前面的账汇总成一张决策表。
| 维度 | channel-based | abutted |
|---|---|---|
| 面积开销 | 通道占 5%-15% 芯片面积 | 接近零 |
| 跨块线延迟 | 通道走线,显著 | 接近零 |
| 时序解耦 | 强,边界寄存器纪律即可 | 弱,接口紧耦合 |
| 顶层绕线 | 通道宽度预算,算术题 | feedthrough 协调,管理题 |
| pin 对齐成本 | 几乎为零 | 高,三支柱纪律 |
| 团队协作解耦 | 高,物理接口自由 | 低,共享物理接口宪法 |
| 适用工艺/规模 | 成熟工艺、中小规模、接口少 | 先进工艺、大芯片、面积线长敏感 |
实际项目里纯形态少见,混合形态才是常态:整片以 abutted 为主骨架(数据通路密集、带宽高的相邻块贴边),在少数「接口少但走线杂」的方向(比如通往 IO 环、通往模拟岛)留窄通道;或者反过来,主体 channel,只对时序最紧的一两条边界做局部贴边。AI 加速器这类阵列化设计还有第三种形态:同构 block 阵列天然全 abutted,pin 对齐成本被「设计一次、复用 N 份」摊薄到接近零——这是 abutted 成本结构里最理想的情形。
选型的三条经验判据。其一,看接口带宽密度:相邻两块之间如果跑着几千 bit 的总线,通道绕线的延迟和功耗惩罚会大到不可接受,上 abutted。其二,看 block 成熟度和并行度:如果各 block 由不同团队并行、进度不齐、接口还在变,channel 的物理解耦是救命稻草,别为了省面积把组织风险引进来。其三,看层次化 STA 的兜底能力:abutted 接口的时序要依赖 层次化 STA 与 block 接口 的模型精度,团队如果没有跑通过这块流程,先用 channel 把物理问题降级成熟悉的时序问题。
这一篇在知识体系里的位置
本篇是 eda/ 目录物理实现线的布图结构文,向上承接 数据流 S3 之 floorplan 与 place 的流程定位,横向连接平铺侧的宏摆放(floorplan 宏单元摆放策略、floorplan 与 powerplan、voltage area 规划),层次化侧的抽象与签核(层次化流程 ILM/ETM、层次化 STA 与 block 接口),以及落地时绕不开的布线、着色与边界单元细节(布线拥塞 DRC 与串扰、DPT 双重曝光着色、welltap 与 endcap 摆放)。读懂两种风格的取舍,再看任何一份层次化布图,都能一眼认出它在哪个维度付了钱、在哪个维度省了钱。
总结
channel-based 与 abutted 是层次化布图的两种基本接壤形态:channel 风格用 5%-15% 的通道面积和显著的跨块走线延迟,换来 pin 位置自由、时序经边界寄存器强解耦、团队物理接口解耦三大红利,绕线问题收敛为「通道宽度预算」这道算术题;abutted 风格把通道面积和跨块线延迟压到接近零,换来的是 pin 对齐三支柱(pin 约束文件冻结、track 网格含 colored track 对齐、边界单元对称)的高昂纪律成本,以及 feedthrough 借道引发的跨块协调管理题。选型看三条:接口带宽密度高上 abutted,团队并行度与进度不齐用 channel 兜底,层次化 STA 流程没跑通前别把物理问题硬扛;实战中多为混合形态,同构阵列是 abutted 成本被复用摊薄的理想情形。
最后给一个流程侧的提醒:风格决策必须冻结在布图早期。通道宽度、共享边界的 pin 规划、feedthrough 额度这些数字,是所有 block 开工的共同前提,任何一个在中后期变更,涟漪都会波及所有相邻块。布图评审时把这份「接壤契约」当交付物签字画押,是层次化项目不翻车的第一道闸门。