FPGA 进阶 07:DSP48 与算术——乘加、滤波、资源推断与级联
本文是
fpga/进阶层第 11 篇。前面讲时序时多次提到「乘法要推断进 DSP48」,这篇把它讲透:FPGA 做数字信号处理(滤波、FFT、矩阵乘、调制解调)为什么快,秘密就在专用硬核 DSP48E1/E2(Xilinx;Intel 叫 Variable Precision DSP Block)。它也是 时序收敛 里「让资源走快车道」的关键。
本文要回答的问题
- 乘法为什么不能用 LUT 堆,非得用 DSP?
- DSP48 内部有什么、一个周期能做什么?
- Verilog 怎么写才能让工具推断出 DSP(而不是掉回 LUT)?
- MAC、FIR、复数乘法怎么映射?级联 cascade 为什么能跑高频?
- 资源报告怎么核对 DSP 用没用上?
一、DSP48 是什么:一颗专用算术硬核
每个 DSP slice 本质是一条「乘法 + 加法/累加」硬连线的数据通路(以 DSP48E1 为例):
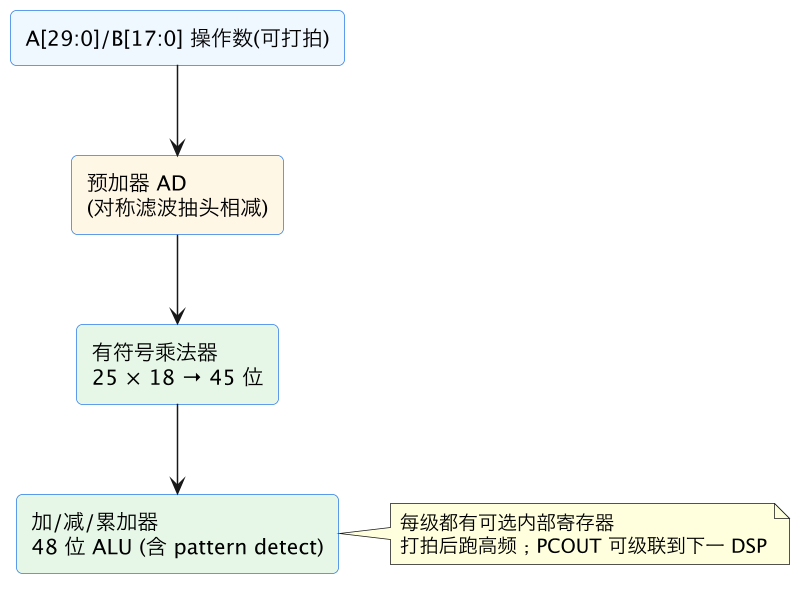
- 一个周期完成 MAC(乘加):
P = A×B + C或P = P + A×B(累加); - 原生有符号 25×18 乘法(UltraScale+ 更宽),48 位累加输出;
- 内置预加器(适合 FIR 对称抽头
A−D再乘)、模式检测(舍入/饱和/比较); - 每级都有可选流水线寄存器,打满拍能跑器件最高频率;
- 专用级联布线 PCIN/PCOUT,多个 DSP 串成链不占通用逻辑。
对照之下,用 LUT+进位链搭同样的乘法器:一个 18×18 乘法要几百个 LUT、逻辑层级深、布线长,又慢又占资源。FPGA 里 DSP slice 数量是有限且专门的宝贵资源,所有乘法/乘加都应尽量落到 DSP。
二、怎么写才能推断出 DSP48
综合器能不能把 RTL 映射到 DSP,取决于写法。推断 DSP 的 checklist:
- 操作用时序逻辑、结果用 reg:乘法器输入/输出打拍。纯组合乘法有时也能进 DSP,但打拍后既稳又能利用 DSP 内部寄存器跑高频。
- 位宽匹配原生宽度:有符号操作数落在 18×25 附近;过宽(如 32×32)会拆成多个 DSP,属正常。
- 输出打拍、启用内部寄存器:把乘法/累加结果在 DSP 内寄存(
MREG/PREG),频率最高,也最能帮助时序收敛。 - 别给 DSP 内部寄存器加异步复位:很多器件 DSP 内部寄存器不支持异步复位/置位,加了会把这级逻辑弹出 DSP、落到 LUT。
- 用
signed:有符号运算显式声明,避免工具按无符号多耗资源/位宽算错。 - 结构规整:连续乘加链让工具识别为 FIR/累加,自动走级联。
推断 vs 强制:写得规范工具会自动推断;想强制可加属性 (* use_dsp48 = "yes" *)(作用于模块/信号;Vivado),或综合时选 DSP 策略。写完一定查综合日志和资源报告:DSP48 数量是否如预期增加、LUT 是否异常暴涨。
三、典型映射:MAC、FIR、复数乘法
3.1 乘加累加器(MAC)
// 每拍做 acc += a*b,一个 DSP 完成(有符号、打拍、无异步复位到内部)
module mac #(parameter WI=18, WO=48)(
    input  wire clk,
    input  wire signed [WI-1:0] a, b,
    input  wire clr,                 // 用同步清零,别用异步复位弹 DSP
    output reg  signed [WO-1:0] acc
);
    always @(posedge clk) begin
        if (clr) acc <= 0;
        else     acc <= acc + a * b;   // 推断为单个 DSP48 的 MUL+ACCUM
    end
endmodule
3.2 FIR 滤波
FIR 输出 y[n] = Σ h[k]·x[n−k],是一条「系数×延迟线样本、再求和」的乘加链。写法要点:延迟线用寄存器/BRAM 存样本,每个抽头一个乘法,求和写成规整的累加链,工具会把多个 DSP 用 cascade 级联串起来;对称 FIR(h[k]=h[N-1-k])还能用 DSP 预加器先 x[n−k]+x[n−(N-1-k)] 再乘系数,省一半乘法器。系数用 signed 定点、ROM 存系数。
3.3 复数乘法
(a+jb)(c+jd) = (ac−bd) + j(ad+bc),要 4 个乘法 + 2 加/减(或优化成 3 乘法),映射到 4 个(或 3 个)DSP;FFT/解调里大量用,配合级联和内部打拍跑高频。
四、级联 cascade:让一串 DSP 跑满频率
DSP slice 有专用级联端口(PCOUT→PCIN 传累加结果,ACOUT→ACIN 传操作数),走芯片上为 DSP 专门铺的高速布线,不经过通用布线、几乎不占 LUT/额外延迟。FIR 抽头求和树、长累加、大位宽乘法拆块,都靠它把成百上千个 DSP 串成一条流水链,频率极高、时序好收敛。
用好级联的关键:
- 让乘加/累加结构规整对称(一条链顺序累加),工具自动识别用 PCOUT/PCIN;
- 在求和链中间别插入普通 LUT 逻辑或乱序相加,会打断级联、被迫走通用布线;
- 对称 FIR 善用预加器;系数/数据路径打拍数一致对齐。
五、位宽、溢出与定点
- 结果位宽要留够:两个 N 位有符号数相乘是 2N 位;累加 K 次再扩
log2(K)位。DSP 的 48 位 P 口就是为累加留的余量,别过早截位导致溢出。 - 有符号/无符号:DSP 原生有符号,全程
signed;无符号乘法可扩展 1 位符号或按器件支持配置。 - 定点小数:FIR/FFT 系数是定点小数,统一小数点位置(Q 格式),乘加后按 [定点 DSP 设计](规划 #30)讲的截位/舍入/饱和处理,避免精度损失或溢出。
- 同步清零代替异步复位:累加器清零用同步
clr,别用异步复位到 DSP 内部寄存器(会弹出到 LUT)。
六、资源核对与典型现象
| 现象 | 可能原因 | 排查/做法 |
|---|---|---|
| LUT/FF 暴涨、乘法路径时序差 | 乘法没推断进 DSP、用 LUT 搭 | 查资源报告 DSP 数;按第二节 checklist 改代码 |
| DSP 用了但频率上不去 | 没打内部寄存器、没用级联 | 打满 M/P 寄存器;规整累加链用 cascade |
| 累加结果偶发错 | 位宽不够溢出 | 结果留足 2N+log2K 位 |
| 有符号结果出错 | 没用 signed、按无符号算 | 全程 signed、统一 Q 格式 |
| 级联断开、走通用布线 | 求和树插了 LUT/乱序 | 顺序规整累加,Device 视图确认 cascade |
| 滤波器抽头多用双倍 DSP | 没用预加器 | 对称 FIR 用 pre-adder 省一半乘法 |
资源核对:实现后 Report Utilization 看 DSPs 占用是否符合预期(几个乘法/乘加对应几个 DSP),若 DSP=0 而 LUT 异常高,就是乘法掉回 LUT,必须修。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 乘法用 LUT 实现 | 慢、占资源、时序差 | 写规范让工具推断 DSP48 |
| 给 DSP 内部寄存器异步复位 | 逻辑弹出 DSP 到 LUT | 用同步 clr,不异步复位 |
| 纯组合大乘法不打拍 | 逻辑深、WNS 红 | 输入/输出打拍,用内部 M/P 寄存器 |
| 累加不扩位宽 | 溢出错数 | 2N + log2(K) 位、用满 48 位 P |
| 有符号数忘 signed | 结果/资源不对 | 全程 signed、Q 格式统一 |
| 求和树写乱 | 级联断、频率低 | 规整顺序累加,善用预加器/级联 |
相关与延伸
前置:时序收敛方法(乘法进 DSP 是收敛快车道)、FIFO 设计。 后续:BRAM/URAM 存储设计(数据通路另一大硬核);定点/截位见规划 #30 定点 DSP、FIR/FFT 实现见 #31。 IP 总览:常用 IP 核。
一句话总结
FPGA 做信号处理快,靠的是专用硬核 DSP48(Intel 叫 DSP Block):一个 slice 内置有符号 25×18 乘法器 + 48 位累加/ALU + 预加器,单周期完成 MAC,还有专用级联布线把成百上千个 DSP 串成流水;乘法绝不能让工具用 LUT 搭(几百 LUT、逻辑深、时序差),要按 checklist 让 RTL 推断进 DSP——操作数/结果用 reg、打拍用上内部 M/P 寄存器、位宽匹配原生宽度、不给内部寄存器异步复位(用同步 clr)、全程 signed,必要时 (* use_dsp48="yes" *) 强制,写完查 Utilization 确认 DSP 数增长、LUT 没暴涨;MAC/FIR/复数乘都映射成乘加链,FIR 对称抽头用预加器省一半乘法、规整累加让工具走 PCOUT/PCIN 级联(中间别插 LUT 打断)即可跑满频率;位宽按「2N + log2(累加次数)」留够防溢出,定点小数统一 Q 格式、截位/饱和交给定点篇——核心心法:把算术喂给 DSP、把存储喂给 BRAM、让流水打满拍。