CRC 校验器验证:多项式配置、单双比特错误注入与漏检防线
更新时间:2026-09-30。这是验证入门长尾篇,和 有效与就绪握手验证:valid 粘性与背压、中断清除验证:置位、清中断与丢失场景 同属「小模块、深验证」系列。CRC(Cyclic Redundancy Check,循环冗余校验,用多项式除法给数据帧算一段余数做检错码)校验器本身逻辑不复杂——一个线性反馈移位寄存器(LFSR)加一组异或门——但它的验证难点恰恰在「简单得容易掉以轻心」:参数配错一位,整个检错能力就静默退化,而功能仿真里数据全对时根本看不出来。
本文要回答的问题
- CRC 校验器的多项式、初值、输入反射、输出异或这一堆参数,验证怎么保证每个组合都算对?
- 单比特、双比特错误注入怎么写激励,注入位置要不要遍历全帧?
- 「漏检」(错误帧被判为好帧)这种最危险的情况,验证上怎么堵?
- 帧长不是数据位宽整数倍时,尾字节处理的错位 bug 怎么抓?
一、先把 CRC 的参数空间钉死
验 CRC 校验器之前,必须先把「一个 CRC 到底由什么决定」讲清楚。同样叫 CRC-16,不同协议的实现可能完全不同,因为 CRC 的计算由五个参数共同决定:
| 参数 | 含义 | 配错的后果 |
|---|---|---|
| 多项式 poly | 除法用的生成多项式 | 检错能力整体变化,余数全错 |
| 初值 init | LFSR 起始装载值 | 余数系统性偏移 |
| 输入反射 refin | 每字节是否按比特翻转后再送入 | 余数比特序错乱 |
| 输出反射 refout | 最终余数是否翻转输出 | 余数高低位颠倒 |
| 输出异或 xorout | 余数送出前异或的掩码 | 余数固定偏差 |
这五个参数构成一个不小的配置空间。以一颗支持 CRC-8/16/32 且各档参数可配的校验器为例,验证计划里至少要列出「每个合法预设组合各打一组金向量」。金向量(golden vector)从权威参考模型来——协议标准附录、已知正确的软件实现(如 Python 的 crcmod)都算,绝不用 DUT 自己的输出当参考,那是典型的「自己抄自己」,把 bug 合法化。参考模型的接入方式和 UVM scoreboard 数据对齐:乱序与延迟匹配 里讲的参考模型比对是同一套路。
每个预设组合至少打三类帧:全零帧(暴露初值错误)、全一帧(暴露多项式抽头错位)、递增序列帧(暴露反射位设置错误)。三类帧的余数对不上时,错误原因基本可以直接按这张表反查,调试效率比盯波形高得多。
二、错误注入点:在哪把比特翻掉
CRC 校验器的验证分两半:算得对不对(上一节),以及检得出错(本节)。后一半的核心手段是错误注入——在发给 DUT 的帧里有意翻转若干比特,看 DUT 是否报 crc_err。先画出错误注入点在数据通路里的位置。
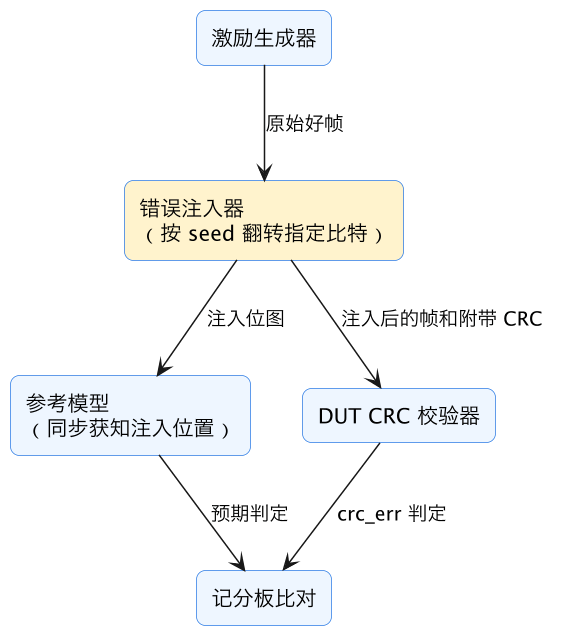
这张图的关键设计是:错误注入器放在激励生成器和 DUT 之间,并且把注入了哪些比特同步告诉参考模型。记分板不能想当然地「注入了错误就必须报错」——CRC 的检错能力是有限度的,某些特定模式的错误(恰好是生成多项式的倍数)在数学上就检不出来。参考模型拿着注入位图重新算一遍余数,余数为零则预期是好帧,非零则预期报错,这样记分板的预期才是精确的,不会把「数学上必然漏检」的用例误判成 DUT bug。
SystemVerilog 里注入器写成事务级函数即可:
function automatic bit [7:0] inject_err(bit [7:0] data[$], int pos[$]);
  bit [7:0] d[$] = data;
  foreach (pos[i]) begin
    d[pos[i] / 8][pos[i] % 8] = ~d[pos[i] / 8][pos[i] % 8];
  end
  return d; // 返回翻转后的帧
endfunction注意注入发生在载荷和 CRC 字段都算在内的整帧范围内——翻转 CRC 字段本身的比特也必须被检出,这是很多人会漏的注入区域。
三、单比特与双比特:注入策略怎么排
CRC 的检错能力是按错误模式分级的,注入策略必须对着这个分级来:
| 错误模式 | 数学保证 | 注入策略 |
|---|---|---|
| 单比特错误 | 任何非零多项式 100% 检出 | 定向:遍历帧首/帧尾/CRC 字段内若干代表位 |
| 双比特错误 | 帧长不超过多项式周期时 100% 检出 | 定向:间距 1、8、帧长一半、帧长减一 的比特对 |
| 奇数个比特错误 | 多项式含 x+1 因子时 100% 检出 | 随机三比特、五比特翻转 |
| 突发错误 ≤ 校验位宽 | 100% 检出 | 定向:连续 16/32 比特全翻转,起点遍历边界 |
| 突发错误 > 校验位宽 | 大概率检出,非保证 | 随机约束大量打,统计漏检率 |
单比特遍历全帧每个位置听起来完备,但帧长 1500 字节就是 12000 个用例,回归时间吃不消。实际做法是:边界位置(第 0 位、第 1 位、最后一位、最后第二位、CRC 字段首尾)定向打,中间位置随机抽样几百个,再用覆盖率确认抽样分布均匀。双比特同理,定向打「间距恰好等于多项式周期的约数」这种危险组合——这是双比特漏检最可能藏身的地方。
双比特注入的定向用例是 CRC 校验器验证里最有含金量的一组。如果 DUT 的多项式配置寄存器写错了一位抽头,恰好把多项式的周期改短,那么「间距等于原周期」的双比特错误就会漏检——这类 bug 用全对的好帧跑一万年也暴露不了,只有对着多项式周期精心构造的双比特注入才能抓出来。这也是为什么验证计划里必须写明「注入间距从规格书的多项式周期推导」,而不是拍脑袋随机。
四、漏检防线:记分板不能只比 crc_err
CRC 校验器验证最危险的失效模式是漏检——坏帧被放行进系统,后果比误报严重得多。堵漏检要三层防线。
第一层是上面说的参考模型精确预期,任何「数学上应检出而 DUT 没报」的用例立刻 fail,这条断言式的比对在回归里一次都不能 waive。
第二层是统计防线:对「数学上不保证检出」的超宽突发错误,随机注入打几十万帧,统计实测漏检率是否落在理论值附近(对 32 位 CRC 应接近 2 的负 32 次方量级,仿真里实际打不到那么低,主要看是否出现「离谱的高」,比如超过百分之一,那多半是实现 bug 而非数学必然)。
第三层是协议级断言:用 SVA 钉死「crc_err 拉起的帧不得进入下游好帧队列」,防止校验逻辑对了但结果信号接反这种低级错误。断言写法基础见 SystemVerilog 断言(SVA):写法和常见误区。
// 报错的帧绝不能被标记为好帧送出
ap_err_frame_not_forwarded: assert property (
  @(posedge clk) disable iff (!rst_n)
  crc_err |-> !frame_accept
);
五、尾字节与帧长边界
最后一个高频 bug 藏身点是帧长不对齐。数据总线 32 位宽,帧长 17 字节,最后一拍只有 1 字节有效——DUT 在收尾时把无效字节也参与运算了,余数就错了。这类 bug 的特征是「帧长恰为位宽整数倍时全对,差一点就错」,所以帧长必须扫边界:位宽减一、位宽、位宽加一,以及规格允许的最小帧和最大帧。
配合功能覆盖率收齐场景:对帧长建 bins(最小、最大、对齐、不对齐各档),对注错位置建 bins(载荷区、CRC 字段区、跨边界),两者 cross 之后确认回归真实打到过「不对齐帧 + CRC 字段内注入」这种角落组合。覆盖率分组写法参考 covergroup 进阶:cross 交叉与 illegal_bins 裁剪。
这一篇在知识体系里的位置
- 同系列姊妹篇:有效与就绪握手验证:valid 粘性与背压 解决 CRC 校验器输入接口的握手合规,本篇解决数据通路的算法正确性与检错能力。
- 断言基本功:SystemVerilog 断言(SVA):写法和常见误区 支撑本文的协议级断言写法。
- 覆盖率方法:covergroup 进阶:cross 交叉与 illegal_bins 裁剪 是帧长与注入位置交叉覆盖的工具篇。
- 比对方法:UVM scoreboard 数据对齐:乱序与延迟匹配 讲解参考模型接入记分板的通用模式。
总结
CRC 校验器验证抓两条主线:一是「算得对」,把多项式、初值、双反射、输出异或五个参数的每个合法组合用外部金向量比对,全零、全一、递增三类帧定位错因,绝不许用 DUT 输出当参考;二是「检得出错」,错误注入器放在激励与 DUT 之间并把注入位图同步给参考模型,单比特抽边界、双比特对多项式周期构造危险间距、突发错误按位宽分级定向,再用「应检出而未报零容忍、超宽突发统计漏检率、crc_err 帧不得放行」三层防线堵死漏检;最后帧长按位宽对齐边界扫一遍,尾字节错位就无处藏身。