SVA ended 与 matched:序列完成事件、跨序列同步与多时钟取值
更新时间:2026-09-28。在 SVA 断言实践:从 sequence 到 property 的写法套路 里,序列只是一个「会不会发生」的布尔模式;本篇讲它的另一面——序列完成本身可以当作一个事件被别的序列消费。
.ended/.matched就是拿到这个事件的两种方法,多时钟背景请先补 SVA 多时钟序列与局部变量。
本文要回答的问题
.ended和.triggered都是「序列刚完成」,区别到底在哪?- 多时钟场景下,为什么
.ended会取错值而.matched不会? - 「先发 req 后发 ack」这类跨序列配对,怎么用
.matched写才不带竞争?
一、从 .triggered 说起:完成事件在哪一拍可见
一个 sequence 在某一拍整体匹配成功,仿真器会把这件事记为一个「完成事件」。在 property 内部,最常写的是 .triggered:
sequence s_req;
  req ##1 valid;
endsequence

property p_ack_after_req;
  @(posedge clk) disable iff (!rst_n)
  s_req.triggered |-> ##[1:5] ack;
endproperty
.triggered 的语义是:当前这一拍,序列存在一个「终点恰好在这一拍」的匹配。它只能在序列被例化过的上下文里使用——属性求值时仿真器得真的跑过这条序列,它的匹配状态才有意义。一旦跳出这个上下文,想把「A 序列完成了」当作一个条件喂给另一个序列,.triggered 就不够用了,这时需要 .ended 与 .matched。
| 方法 | 语义 | 可用上下文 | 时钟归属 |
|---|---|---|---|
.triggered | 当前拍序列有匹配终点 | 属性内、序列被例化处 | 调用上下文时钟 |
.ended | 当前拍序列有匹配终点 | 任何表达式(sequence/property/过程代码) | 调用者时钟(采样值对齐到调用者沿) |
.matched | 同 .ended,但保持原时钟 | 序列内、多时钟场景 | 匹配点所在时钟 |
关键就在最后一列:.ended 会把「完成事件」拉回到使用它的那条序列的时钟域里观察,而 .matched 保留着完成发生时的原始时钟沿。单时钟下两者几乎等价,多时钟下差异立刻显形。
二、.ended:单时钟下的跨序列同步
先把最常见的用法立住。假设要写「写请求完成后,若干拍内必须看到写响应」,把请求和响应拆成两条独立序列:
sequence s_wr;
  wr_en ##1 (wr_last || wr_burst_end);
endsequence

sequence s_wr_then_resp;
  @(posedge clk) s_wr.ended ##[1:4] bvalid;
endsequence

a_wr_resp: assert property (
  @(posedge clk) disable iff (!rst_n) s_wr_then_resp);
@(posedge clk) s_wr.ended 的读法是:在 clk 的每个上升沿,回头看 s_wr 是否恰好在这一拍完成了匹配。因为 s_wr 自己也是 @(posedge clk) 计时的,两个沿天然对齐,.ended 的取值没有歧义。
这样做比把整条模式揉成一个超长序列的好处是关注点分离:s_wr 可以独立被覆盖率、被别的 property 复用;配对逻辑只负责「结束之后看响应」。协议检查器(protocol checker)里这类「阶段 A 完成 → 阶段 B 发生」的骨架几乎都长这样。
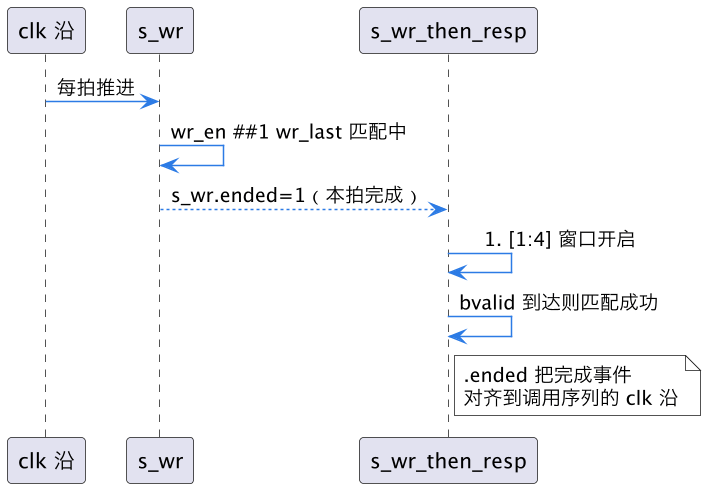
图里那条自返回的箭头是核心:s_wr_then_resp 并不驱动 s_wr,只是在每个 clk 沿上去查询 s_wr 的完成状态。两条序列各自独立求值,靠 .ended 这个一拍宽的事件做同步——这正是「跨序列同步」的实质。
三、.matched:多时钟下保住原始时钟沿
进入 multiclock 领域,.ended 的「对齐到调用者时钟」就从特性变成陷阱。设 s_slow 计时在慢时钟 clk_s,调用者跑在快时钟 clk_f:
sequence s_slow;
  @(posedge clk_s) a ##1 b;
endsequence
若在 @(posedge clk_f) 的序列里写 s_slow.ended,仿真器做的是:在 clk_f 的每个沿上,用 clk_f 沿的采样语义去问 s_slow 完成没有。当 clk_s 与 clk_f 不同步时,s_slow 的真实完成沿落在两个 clk_f 沿之间,.ended 可能把同一个完成事件在 clk_f 域里看多拍、或者因亚稳态式错位一拍都看不到——结果都是配对逻辑误触发或漏触发。
.matched 的定义就是堵这个洞:它报告「序列在自己的时钟上已经完成」,但这个布尔值只在下一次遇到调用者序列中的时钟切换语义时才被消费,取值严格挂在匹配点的那个沿上。LRM 的限定是 .matched 只能出现在 multiclock sequence 里、且两条序列的主时钟不同——这正是它存在的唯一场景:
sequence s_handshake;
  @(posedge clk_s) req_s ##1 done_s;
endsequence

sequence s_pipe;
  @(posedge clk_f) start
  ##1 s_handshake.matched   // 保留 clk_s 域的完成沿
  ##1 out_valid;            // 回到 clk_f 域继续
endsequence
下图对比两种取值在同一个错位场景下的命运:
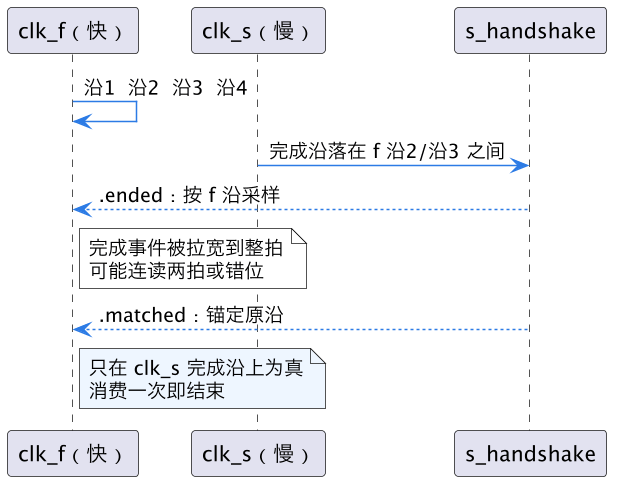
读图要点:.ended 把慢域事件投影到快域栅格上,投影必然失真;.matched 不做投影,事件的时间戳仍属于 clk_s。工程判据一句话:主时钟不同的两条序列对接,用 .matched;同钟对接,用 .ended。仿真器对 .matched 出现在单时钟场景会直接报编译错误,这条约束反而帮你在写错时立刻暴露。
四、典型坑位速查
| 现象 | 根因 | 处理 |
|---|---|---|
| 多时钟断言偶发误触发 | .ended 跨时钟域投影 | 改用 .matched |
编译报 .matched 非法使用 | 两条序列主时钟相同 | 退回 .ended 或 .triggered |
.triggered 取到 X | 序列从未在属性里被例化 | 确保序列在 antecedent 等处实际出现 |
| 配对窗口从错误一拍起算 | 把 .ended 当电平用,多拍为真 | 记住完成事件只占终点一拍,窗口用 ##1 起算 |
过程代码里 .ended 恒假 | 在 @(negedge) 块里查上升沿计时的序列 | 沿对齐再查询 |
最后一行值得展开:.ended / .matched 也能用在 always/initial 过程块里做覆盖率采样或 trigger,但查询沿必须与序列计时沿同源,否则永远查不到。
这一篇在知识体系里的位置
- 前置:SVA 断言实践:从 sequence 到 property 的写法套路 给出 sequence/property 的基础骨架。
- 多时钟背景:SVA 多时钟序列与局部变量 讲清
##1跨时钟切换与值传递,是理解.matched的前提。 - 进阶:断言绑定与覆盖率收集见 SVA bind 与断言覆盖率方法。
总结
SVA ended matched 都是读取「序列完成事件」的方法:.ended 把事件对齐到调用者时钟,适合单时钟跨序列同步;.matched 锚定匹配点的原始时钟沿,是多时钟序列之间唯一的正确对接方式;.triggered 则限于序列被例化的上下文。记住「同钟用 ended、异钟用 matched、属性内用 triggered」,跨序列配对的竞争与漏检就都堵住了。