CRC16 SystemVerilog模板:CCITT-FALSE 与反射 ARC 双配置一份代码精讲
更新时间:2026-11-10。这是一篇「拿来即用」的模板文:16 位循环冗余校验只写一份参数化代码,就同时覆盖 MSB-first 的 CRC-16/CCITT-FALSE 和 LSB-first 的 CRC-16/ARC 两种主流配置,重点讲清「输入反射」到底反射了什么、为什么反射后连工作多项式都要位反转。8 位宽度与 GF(2) 除法的移位异或基础在 CRC8 SystemVerilog 模板 里讲过,本篇专注 16 位与多参数;反馈移位寄存器为什么天然能产生最长序列,在 LFSR/PRBS 发生器模板 展开。
本文要回答的问题
- 同样是 CRC16,CCITT-FALSE 和 ARC 的参数差在哪,为什么结果完全不同?
- 「输入反射 / LSB-first」具体要反转哪些东西,只把字节位序反过来够不够?
- 为什么反射配置里工作多项式要从
0x8005变成0xA001? - 一份代码怎么用
REFLECT参数同时跑出两种标准的标准向量? - 双配置、双实现(串行/并行)怎么在一个测试平台里互相印证?
先把两种标准的参数与本篇的实现形态摆在一起:
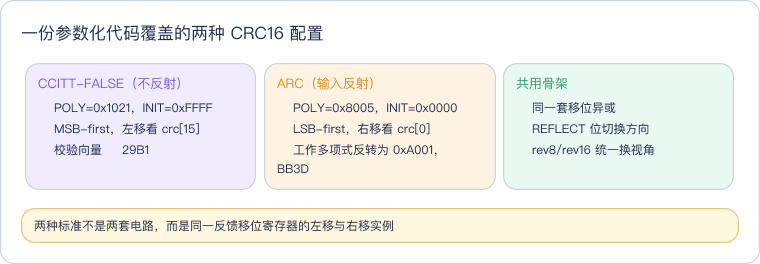
读这张卡先记住两个数:"123456789" 在 CCITT-FALSE 下余数是 29B1、在 ARC 下是 BB3D,这是后面验证两条配置各自正确性的锚点。第三个分区点明二者共用同一套移位异或骨架,靠 REFLECT 位在「左移」和「右移」两个方向间切换,而不是两套独立电路。
一、两种配置的分野:位序方向
CRC 的移位异或原理在 8 位篇已经建立,这里只补 16 位带来的新问题:比特送进寄存器的方向。CCITT-FALSE 是 MSB-first,每个字节从最高位 data[7] 送起,寄存器左移,反馈判据看最高位 crc[15]。ARC 是 LSB-first,每个字节从最低位 data[0] 送起,寄存器右移,反馈判据看最低位 crc[0]。
这张图的核心是:反射不只是「把输入字节倒着喂」。位序一反过来,整个 GF(2) 除法的观察方向都反了——移位方向、反馈判据所在的端头、以及参与异或的工作多项式必须一起反过来,三者中只改任何一个都会得到错误余数。下面两节分别落到串行和并行代码上。
二、反射为什么要反转多项式
这是最容易写错的一点。生成多项式 0x8005 是按「最高位对应 x 的最高次幂」书写的,它天然配合左移、看最高位的 MSB 口径。一旦改成右移、看最低位,同一个多项式在新的位序视角下必须做一次 16 位位反转才能保持等价:0x8005 反转后正是 0xA001。
// 16 位位反转:把 MSB 口径的多项式翻译成 LSB 口径的工作多项式
function automatic logic [15:0] rev16(input logic [15:0] x);
    logic [15:0] r;
    for (int k = 0; k < 16; k++) r[k] = x[15-k];
    return r;
endfunction

// 反射配置用反转后的工作多项式,非反射配置直接用原多项式
localparam logic [15:0] WPOLY = REFLECT ? rev16(POLY) : POLY;
输入字节同理:反射配置在处理前要先做一次 8 位位反转(rev8),让「物理上先到的最低位」对齐右移寄存器的进给方向。可以把 rev8 和 rev16 理解成同一套「换视角」操作——字节换视角用 rev8,多项式换视角用 rev16,缺一不可。本篇调试时就踩过这个坑:最初只反转了字节、没反转多项式,ARC 算出的是 afad 而非 BB3D,补上 WPOLY=rev16(POLY) 后标准向量立刻归位。
三、参数化串行实现:一份代码两个方向
串行版用一个 REFLECT 位把左右两条路径收进同一个 always_ff:复位时装载 INIT,每个有效比特按方向选择反馈端头与移位方式。
module crc16_serial #(
    parameter logic [15:0] POLY    = 16'h1021,
    parameter logic [15:0] INIT    = 16'hFFFF,
    parameter bit          REFLECT = 1'b0
)(
    input  wire        clk,
    input  wire        rst_n,
    input  wire        bit_valid,
    input  wire        bit_data,
    output logic [15:0] crc
);
    function automatic logic [15:0] rev16(input logic [15:0] x);
        logic [15:0] r;
        for (int k = 0; k < 16; k++) r[k] = x[15-k];
        return r;
    endfunction
    localparam logic [15:0] WPOLY = REFLECT ? rev16(POLY) : POLY;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n)
            crc <= INIT;
        else if (bit_valid) begin
            if (!REFLECT) begin                 // CCITT:左移,看最高位
                if (crc[15] ^ bit_data)
                    crc <= {crc[14:0], 1'b0} ^ WPOLY;
                else
                    crc <= {crc[14:0], 1'b0};
            end else begin                      // ARC:右移,看最低位
                if (crc[0] ^ bit_data)
                    crc <= {1'b0, crc[15:1]} ^ WPOLY;
                else
                    crc <= {1'b0, crc[15:1]};
            end
        end
    end
endmodule
两条分支结构完全对称:MSB 路径 {crc[14:0],1'b0} 左移、反馈取 crc[15];LSB 路径 {1'b0,crc[15:1]} 右移、反馈取 crc[0]。测试平台里两个串行实例吃同一时钟,CCITT 实例喂 cur[7-i]、ARC 实例喂 cur[i],位序差异在激励侧就分开了。
下面的波形展示同一字节在两条路径上的进给节奏:CCITT 从高位取比特、ARC 从低位取比特,两个余数寄存器各自按方向滚动,互不干扰。
读这张波形注意 ccitt_bit 与 arc_bit 每一拍取的都是同一字节里位置相反的两个比特,这正是两条配置位序分野在时间轴上的样子;crc 的更新逻辑由各自实例的 REFLECT 决定,时钟与 valid 握手完全共用,所以一份 testbench 能同时驱动两套 DUT。
四、字节并行实现与双配置对拍
并行版同样用 REFLECT 收口,组合循环内先按方向决定是否 rev8 输入,再展开 8 次移位异或,多字节帧靠 crc_in/crc_out 级联。
module crc16_parallel #(
    parameter logic [15:0] POLY    = 16'h1021,
    parameter logic [15:0] INIT    = 16'hFFFF,
    parameter bit          REFLECT = 1'b0
)(
    input  wire [7:0]  data_in,
    input  wire [15:0] crc_in,
    output logic [15:0] crc_out
);
    function automatic logic [7:0] rev8(input logic [7:0] x);
        logic [7:0] r;
        for (int k = 0; k < 8; k++) r[k] = x[7-k];
        return r;
    endfunction
    function automatic logic [15:0] rev16(input logic [15:0] x);
        logic [15:0] r;
        for (int k = 0; k < 16; k++) r[k] = x[15-k];
        return r;
    endfunction
    localparam logic [15:0] WPOLY = REFLECT ? rev16(POLY) : POLY;

    always_comb begin
        logic [15:0] c;
        logic [7:0]  d;
        logic fb;
        c = crc_in;
        d = REFLECT ? rev8(data_in) : data_in;
        for (int i = 7; i >= 0; i--) begin
            if (!REFLECT) begin
                fb = c[15] ^ d[i];
                c  = {c[14:0], 1'b0};
                if (fb) c = c ^ WPOLY;
            end else begin
                fb = c[0] ^ d[i];
                c  = {1'b0, c[15:1]};
                if (fb) c = c ^ WPOLY;
            end
        end
        crc_out = c;
    end
endmodule
从吞吐角度再看这对实现的工程取舍:16 位串行版处理一个字节要 8 个时钟拍,跑在 100 MHz 时钟下吞吐上限约 12.5 MB/s,喂 UART、SPI 这类低速串行帧绰绰有余;并行版一拍一个字节,同频率理论上限冲到 100 MB/s,够支撑大多数总线与包处理流水,但那条展开 8 层异或的组合路径在更激进的频率下可能需要插拍或换用多字节并查(table-based)结构。选型本质是在「时序裕量、面积、吞吐」三者间平衡,而不是一味追求并行。
测试平台为两种配置各例化串行与并行一个实例,再加一个带 reflect 参数的软件参考函数,形成「双配置 × 三实现」的六路对照。这里有个仿真纪律值得记下:并行输出是组合逻辑,必须在驱动下一字节前先把结果寄存下来,再去跑串行激励,否则串行复位和信号翻转会通过 testbench 的调度顺序污染对拍判断。本篇最终用独立输入总线、并行结果即时寄存、每步加 #1 等组合稳定三招,让 150 帧随机对拍全部对齐。
| 配置 | POLY / INIT | 位序 | 工作多项式 | 标准向量期望 | 实测 |
|---|---|---|---|---|---|
| CRC-16/CCITT-FALSE | 0x1021 / 0xFFFF | MSB-first | 0x1021 | 29B1 | 29B1 |
| CRC-16/ARC | 0x8005 / 0x0000 | LSB-first | 0xA001 | BB3D | BB3D |
五、验证:标准向量、150 帧对拍与检错
验证分四段。第一段用 "123456789" 同时核对两种配置的标准向量,串行、并行、软件三路必须分别落到 29B1 与 BB3D。第二段生成 150 帧、长度 1 到 40 的随机帧,双配置各自做三实现对拍。第三段在 CCITT 配置下做 40 组单比特翻转,验证余数非零、错误全检出。第四段把无错帧带上正确 CRC 整体求余,验证余数归零。
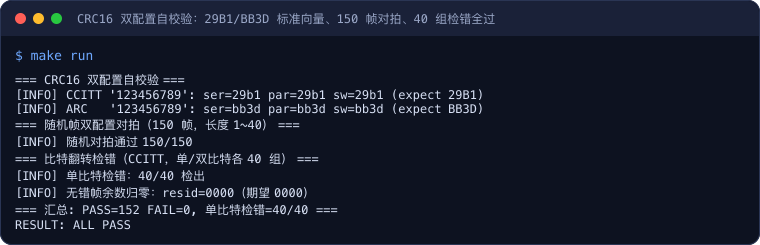
实录里两个标准向量各自三实现同值,随机对拍 150/150 通过,40 组单比特翻转 40/40 检出,无错帧余数 resid=0000。这组结果同时证明了三件事:反射三件套(字节反转、移位反向、多项式反转)齐备时 ARC 才正确;串行与并行在两种位序下都严格等价;CRC16 的汉明距离对单比特错误保持全检出。
=== CRC16 双配置自校验 ===
[INFO] CCITT '123456789': ser=29b1 par=29b1 sw=29b1 (expect 29B1)
[INFO] ARC   '123456789': ser=bb3d par=bb3d sw=bb3d (expect BB3D)
=== 随机帧双配置对拍(150 帧,长度 1~40) ===
[INFO] 随机对拍通过 150/150
=== 比特翻转检错(CCITT,单/双比特各 40 组) ===
[INFO] 单比特检错:40/40 检出
[INFO] 无错帧余数归零:resid=0000(期望 0000)
=== 汇总: PASS=152 FAIL=0, 单比特检错=40/40 ===
RESULT: ALL PASS
下图是这次双配置仿真在终端中的完整输出,顶部两行标准向量与底部的 RESULT: ALL PASS 首尾呼应,中间是随机对拍与检错的分段统计。
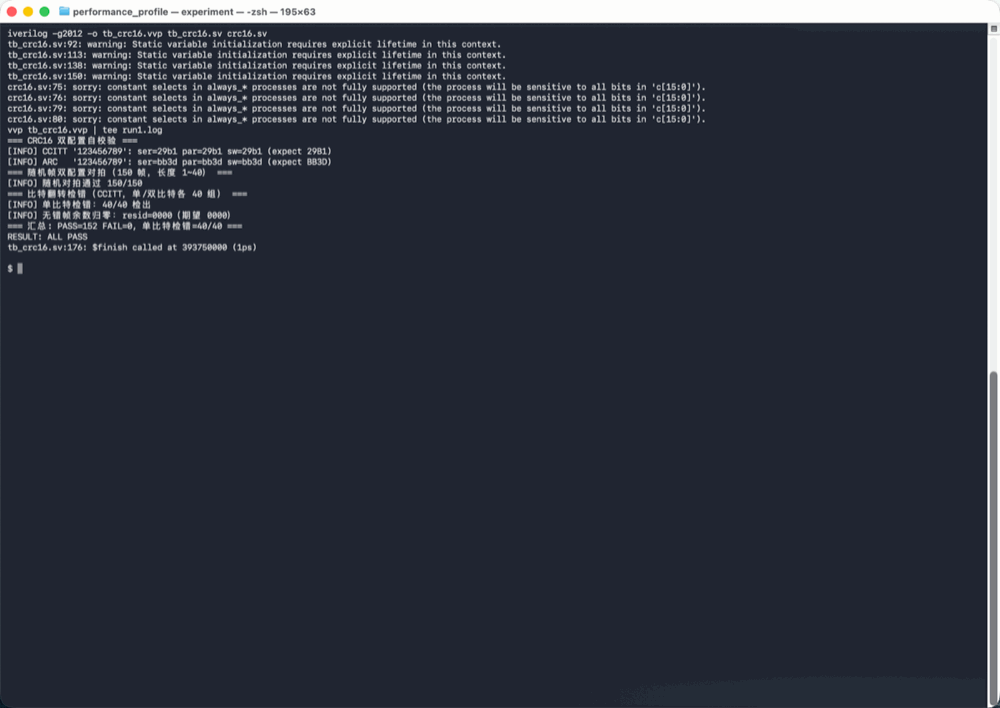
读图时先盯住第二、三行的 ser/par/sw 三个值——同配置下三者完全相等,说明串行硬件、并行硬件与软件模型在该位序下一致;再看 CCITT 是 29b1、ARC 是 bb3d,两个不同结果恰恰证明 REFLECT 切换确实改变了计算口径而不是跑了两遍相同电路。
六、反射的数值演算与常见变体
「位反转」如果只停留在概念上,落地时极易写错。把 0x8005 到 0xA001 的演算摊开看:先把 0x8005 写成 16 位二进制 1000 0000 0000 0101,再把这 16 个比特整体倒序,得到 1010 0000 0000 0001,即 0xA001。代码里的 rev16 循环做的就是这件事——r[k] = x[15-k] 逐位搬运,没有任何算术技巧。
// 0x8005 -> 1000_0000_0000_0101 -> 倒序 -> 1010_0000_0000_0001 -> 0xA001
function automatic logic [15:0] rev16(input logic [15:0] x);
    logic [15:0] r;
    for (int k = 0; k < 16; k++) r[k] = x[15-k];
    return r;
endfunction
输入字节的 rev8 同理。例如字节 0x53(0101_0011)反转后是 1100_1010 即 0xCA。反射配置每喂一个字节都先做这一步,目的是让「物理上最低位先到」的串行比特流,在右移寄存器里仍能按多项式规定的次序参与反馈。反射三件套——输入字节 rev8、移位改右移、工作多项式 rev16——必须同时成立,本篇调试时只做前两件、漏掉第三件时,ARC 稳定输出 afad 而非 BB3D,就是这个原因。
掌握了 POLY、INIT、REFLECT 三个旋钮后,绝大多数 CRC16 标准都能翻译成模块参数。下表列出常见变体的关键参数,最后一列给出与本篇模板的对应关系,表中均为各标准公开规定的常量,不是实测随机值。
| 标准 | POLY | INIT | 输入/输出反射 | 结果异或 | 校验向量 | 模板配置要点 |
|---|---|---|---|---|---|---|
| CRC-16/CCITT-FALSE | 0x1021 | 0xFFFF | 否 | 0x0000 | 29B1 | REFLECT=0,直接套 |
| CRC-16/XMODEM | 0x1021 | 0x0000 | 否 | 0x0000 | 31C3 | 同 CCITT 改 INIT |
| CRC-16/ARC | 0x8005 | 0x0000 | 是 | 0x0000 | BB3D | REFLECT=1,WPOLY=0xA001 |
| CRC-16/MODBUS | 0x8005 | 0xFFFF | 是 | 0x0000 | 4B37 | ARC 口径改 INIT |
| CRC-16/USB | 0x8005 | 0xFFFF | 是 | 0xFFFF | B4C8 | MODBUS 再加结果异或 |
| CRC-16/KERMIT | 0x1021 | 0x0000 | 是 | 0x0000 | 2189 | 反射口径配 0x1021 反转 |
这张表暴露一个规律:很多变体之间只差一两个旋钮。ARC 与 MODBUS 的多项式、反射完全相同,只把初值从 0x0000 换成 0xFFFF;USB 又在 MODBUS 基础上对最终余数整体异或 0xFFFF。结果异或(xorout)本篇模板没有单独做参数,因为它只在取余数后加一级异或,综合时就是 16 个二输入门,需要时在输出端补 assign crc_final = crc ^ XOROUT; 即可,不必改动反馈内核。
移植新变体的标准动作是三步:先按说明书填 POLY、INIT、REFLECT;反射为真时确认 WPOLY 已由 rev16 自动算出;最后用该变体公布的 check 值(一般就是 "123456789" 的余数)做标准向量断言,对上了再上随机对拍。跳过标准向量直接随机测试是危险的——一个写错位序的实现同样能在「自己 vs 自己」的对拍里全部通过,却和真实协议对不上,只有独立的权威向量能逮住这类系统性错误。
七、落地常见误区
把这一系列调试中真实暴露过、以及工程上反复出现的坑汇总成表,照表自查能省掉大半定位时间。
| 误区 | 典型现象 | 根因与处理 |
|---|---|---|
| 只反转字节不反转多项式 | ARC 算出 afad 而非 BB3D | 反射三件套缺 rev16,WPOLY 必须是 0xA001 |
| 并行结果未即时寄存 | 长随机帧偶发不一致 | 组合输出被后续激励污染,先寄存再跑串行 |
| 多字节每字节从 INIT 起算 | 余数与帧长无关、明显偏小 | 上一字节 crc_out 接回下一字节 crc_in |
| 把 0x11021 写进 16 位常量 | 编译截断或高位丢失 | x¹⁶ 项隐含在移位里,POLY 只写低 16 位 0x1021 |
| 标准向量期望值忘改 | 换协议后自检直接报错 | 改 POLY/INIT 同时更新 check 值断言 |
第二条值得展开,因为它不是语法错误而是仿真调度问题。crc16_parallel 是纯组合逻辑,输出随输入即时变化;testbench 里如果在同一时间槽先驱动了下一字节、再去读取上一字节的并行结果,读到的已经是新激励算出的值。可靠做法是每步驱动后加 #1 等组合稳定,并立刻把结果寄存到独立变量,再去产生串行激励。本篇最终为两个配置各用一条独立输入总线,也是为了彻底避免总线复用带来的相互干扰。
第一条则是反射口径最容易漏的一环。很多人记得「LSB-first 要把字节倒过来」,却忽略了多项式本身也是按 MSB 视角书写的常量,观察方向一换,它必须跟着位反转。判断有没有漏很简单:反射配置下如果 WPOLY 还等于原始 POLY,那一定错了;0x8005 与 0xA001 互为位反转,这一对数值可以当作反射链路是否接对的快速探针,上电后先跑一遍标准向量,看是否落到 BB3D 即可一眼分辨。
实验环境
- 机器/系统:Mac mini M4 / macOS 15
- 工具版本:Icarus Verilog 13.0(
iverilog -V输出Icarus Verilog version 13.0 (stable) (v13_0)),编译选项-g2012 - 日期:2026-11-10
- 完整命令:
make run(Makefile 内部依次执行iverilog -g2012 -o crc16.vvp crc16.sv tb_crc16.sv与vvp crc16.vvp)
代码获取
本文全部代码(参数化串行与并行 CRC16 模板、双配置自校验测试平台与 Makefile)已同步到公开仓库 geek-doc.cn/experiments/tpl-crc16-sv,克隆后在该目录执行 make run 即可复现两种标准向量、150 帧对拍与检错输出。
这一篇在知识体系里的位置
本篇是芯片设计入门簇中「数据校验」节点的 16 位与多参数模板页:8 位宽度与 GF(2) 移位异或基础见 CRC8 SystemVerilog 模板,反馈移位寄存器的结构与最长序列性质见 LFSR/PRBS 发生器模板,一位异或奇偶的起点见 比较器与奇偶校验电路。读完本篇应能把任意一份 CRC 标准说明书上的 width、poly、init、refIn/refOut 参数翻译成对应的模块参数。
总结
CRC16 的 CCITT-FALSE 与 ARC 共用同一套移位异或骨架,差别只在位序方向:MSB-first 左移、看最高位、用原多项式;LSB-first 右移、看最低位,且必须把输入字节和工作多项式一起位反转,0x8005 因此翻成 0xA001。一份带 REFLECT 参数的代码配合 rev8/rev16 就能覆盖两种标准,串行与并行实现都已通过 29B1、BB3D 两个标准向量、150 帧双配置三实现对拍和 40 组单比特全检出验证。换任何 CRC 标准时,按说明书改 POLY、INIT、REFLECT 三处,并同步更新标准向量期望值即可。