FP8 注意力内核:Q/K/V 量化的精度边界、per-block scale 与 Hopper FP8 MMA 的实现要点
更新时间:2026-10-06。FP8(8 位浮点,e4m3 格式 4 位指数 3 位尾数)在 Hopper 架构上有硬件级支持,把注意力内核的 Q/K/V 从 FP16 压到 FP8,收益是双份的:KV cache 读写带宽减半(decode 阶段直接受益),FP8 MMA 的峰值吞吐是 FP16 的两倍(prefill 阶段直接受益)。站内 FP8 e4m3 与 e5m2 推理 讲了格式本身,FA3 Hopper FP8 attention 讲了 FlashAttention-3 的整体设计。这篇聚焦一个更具体的问题:注意力三个矩阵 Q、K、V 对 FP8 量化的敏感度完全不同,scale 粒度怎么配、内核怎么写,才能把精度损失压在可接受线以内。
本文要回答的问题
- Q、K、V 三个矩阵对 FP8 量化的敏感度为什么差这么多,各自该用什么策略?
- per-tensor、per-token、per-block 三种 scale 粒度的精度-开销权衡是什么?
- Hopper 的 FP8 MMA(wgmma)在内核里怎么用,累加精度怎么处理?
- softmax 前后的数值范围问题怎么解,online softmax 和 FP8 怎么共存,硬件累加有哪些已知坑?
- 端到端精度验收该分几层做、各层判据是什么,什么信号说明量化过头了?
一、Q、K、V 的敏感度差异:不是所有矩阵都配叫 FP8
先把结论摆出来:三个矩阵里只有两个该被量化,剩下那个保持高精度反而是全局最优。注意力计算 QK^T 再乘 V,三个矩阵在数值链路里的角色不同,对量化的容忍度也完全不同。
V 是最耐受的。V 参与的是概率加权求和(P·V),误差被概率加权平均摊薄,且 V 本身的分布比较平滑。FP8 直接量化 V,精度损失通常在噪声水平,这也是为什么 KV cache 的 FP8 化普遍从 V 开始、甚至只做 V 都能拿到大部分带宽收益。实测里只量化 V 的端到端困惑度偏移经常小到测不出,量化 K 之后才会出现可测的偏移——这个「先 V 后 K」的顺序也是灰度上线的天然台阶。
K 中等敏感。K 决定注意力的匹配分数(Q·K),误差会改变 softmax 前的 logits,而 softmax 对 logit 误差是指数放大的——logit 差 0.1,概率比就差 e^0.1 ≈ 10%。好在 K 的分布相对集中,配合 per-channel scale(K 的每个 head 维度一个 scale)可以把量化误差压到 logit 噪声以下。这里有一个注意力特有的混杂因素:RoPE 位置编码作用在 Q 和 K 上,量化必须在 RoPE 应用之后做——旋转后的 K 各通道数值范围会被重新洗牌,先量化再旋转会让原先配好的通道 scale 失配,误差立刻上一个台阶。这个顺序问题在代码 review 时很容易被漏掉,因为两种顺序在数学形式上只差一个旋转矩阵的交换。
Q 最敏感但不能量化也最安全。Q 是每个 decode step 新算出来的(不经过 cache),如果 Q 也 FP8,误差同样指数放大进 logits。但 Q 的量化收益最小——它不驻留显存、不占带宽大头,只影响 QK^T 这一次 MMA 的吞吐。所以工程上的主流配置是 Q 保持高精度(FP16/BF16)或 FP8 加细粒度 scale,K、V 上 FP8:带宽收益拿满,QK^T 用混合精度 MMA(Hopper wgmma 支持 FP8 输入 FP16/FP32 累加,也支持混合操作数)。
这个敏感度排序的解释要回到 FlashAttention 内存分块 的数据流:decode 的瓶颈是把全部 KV 从 HBM 搬进 SRAM,K、V 是带宽的主角,Q 只有一个 token 的量。量化优化要打在带宽瓶颈上,K、V 正是靶心——先想清楚瓶颈再决定量化谁,这个原则在 注意力内核优化全景 里有更系统的展开。
用一组具体数字感受收益。70B 级模型、32k 上下文、单条请求的 KV cache 在 FP16 下约 5 GB,decode 一步要把其中本请求的部分完整读一遍;FP8 化之后读量减半,在 HBM 带宽 3.35 TB/s 的 H100 上,单步 KV 读取时间从约 1.5 毫秒降到 0.75 毫秒——对 ITL 预算几十毫秒的小 batch 服务这不是大头,但对长上下文大 batch 服务(KV 读取占 step 时间三到五成),这就是两位数的端到端改善。prefill 侧的收益形态不同:FP8 MMA 的峰值吞吐翻倍,但注意力只是 prefill 算力的一部分,端到端 prefill 加速通常在 15% 到 30%,要配 服务容量规划 重新核算 prefill 池的承载力。

上图把三个矩阵的敏感度和主流配置画在一起。记住左下角那句注释:decode 阶段 KV 搬运算术强度极低,K、V 的体积减半就是带宽需求减半,这是 FP8 注意力在 decode 侧收益的直接来源。
二、scale 粒度:per-tensor、per-token 还是 per-block
粒度选择是 FP8 工程里精度与开销交战的主战场。FP8 e4m3 的动态范围只有约 ±448,而注意力的激活值分布范围远超这个区间,所以必须配 scale(缩放因子):存 FP8 值加上一个高精度 scale,计算时还原。scale 的粒度是精度和开销的主战场。
per-tensor(整个张量一个 scale)开销最小,但张量内不同 token、不同通道的数值范围差几个数量级时,小数值区域会被粗 scale 压成零——精度灾难,基本只在权重量化里能用,激活不行。注意这里的对比对象是 量化 int8 与 int4 校准 里权重的静态分布,激活是运行时动态分布,两者的 scale 策略不能互相照抄。
per-token(每行一个 scale)是激活量化的及格线,见 LLM 量化 per-token scale。但注意力里有个特殊问题:K、V 是历史 token 的缓存,per-token scale 意味着每个 token 存一个 scale,解量化时要逐 token 乘,打断了 MMA 的连续数据流。
per-block(按 64 或 128 元素的块一个 scale)是 FA3 一系内核的选择:块粒度比 token 细,能跟上通道间的数值起伏;同时块边界和 MMA 的 tile 边界对齐,scale 可以在 tile 加载时顺手应用,不破坏数据流。DeepSeek 系的 FP8 实践证明了这条路的有效性。代价是 scale 本身的存储和带宽(每 128 个元素一个 FP32 scale,约 3% 的额外开销),以及内核里多一套 scale 寄存器管理。

上图把三种粒度收敛到一条选择原则:scale 粒度要和内核的 tile 结构对齐。脱离内核谈粒度没有意义——per-block 之所以赢,不是因为它在理论上最优,而是因为它能嵌进 wgmma 的 tile 流水里让 scale 应用变成零额外访存。
工程上还有一个 scale 的存储布局问题。KV cache 是 PagedAttention 管理的块状结构,scale 数组要和 KV block 的生命周期同步分配回收——主流做法是把 scale 和 KV 数据存在同一个 block 的头部或紧邻的伴生 block 里,块表一个条目同时定位数据和 scale。另一个细节是 scale 的更新时机:写入新 KV 时才计算该块的 scale(对新写入的 64 到 128 个元素求绝对值最大值再除 e4m3 上限),历史块的 scale 一旦写入就不再变——这保证了「同样的历史 KV 在不同 decode step 解出同样的值」,是投机解码验证一致性的隐含前提。scale 计算本身 fuse 进 KV 写入的 kernel 里做,不单独开 kernel,否则每次 decode 多一次显存往返。
三、Hopper FP8 MMA 的内核实现要点
Hopper 的 wgmma 指令原生支持 e4m3 输入、FP32 累加,这是 FP8 注意力的硬件地基。但把 MMA 换成 FP8 只是开始,内核层面还有四个要点。
累加精度不能降。QK^T 的累加必须 FP32,否则长序列下累加误差淹没 logits——e4m3 的尾数只有 3 位,两个 FP8 相乘的结果直接进 FP8 累加器是灾难。Hopper 的 wgmma 累加器天然是 FP32 寄存器,这条只要不乱改数据通路就自动满足。有一个相关的硬件细节:Hopper 的 FP8 wgmma 存在「周期性降精度累加」的已知行为(长累加链中间歇性地用较低精度截断),序列越长影响越可见,FA3 一系内核通过对累加链分段、定期把寄存器值提升到完整精度来规避——自研内核时这是必须复现的细节,跳过它在短序列测试里完全隐形,到 8k 以上的序列才暴露成 logits 系统性偏小。
scale 的应用时机。per-block scale 可以乘在 MMA 之前(解量化到 FP16 再算,失去 FP8 吞吐)或之后(对 FP32 累加结果乘 scale,保住 FP8 吞吐)。后者是对的姿势:QK^T 的每个 tile 累加完,在寄存器里乘上 Q、K 两个 scale 的乘积,再进入 softmax 的 max/sum 归约。V 那一侧的 P·V 同理,只是 P 本身是在线产生的概率,需要额外决定 P 用什么精度喂给第二个 MMA——P 的动态范围天然在 0 到 1,是三个输入里最适合 FP8 的,但要在归一化之前完成转换,否则 running sum 还没除下去,概率值会随 running max 剧烈波动。
online softmax 的兼容。FlashAttention 的 online softmax 维护 running max 和 running sum 做分块归一,FP8 化之后这套机制不变,但要注意 rescale 操作(running max 更新时历史累加要乘修正因子)的数值稳定性——修正因子本身是高精度浮点,乘法在 FP32 累加器上做,不要把中间结果降回 FP8。这是实现里最容易写错的一处,写错的后果是长序列上 logits 缓慢漂移、短序列测试全过。
transpose 与布局。QK^T 需要 K 转置、P·V 需要 V 的特定布局,wgmma 对操作数的共享内存布局有严格要求(core matrix 排布)。FP8 数据宽度减半后,原有的 ldmatrix/swizzle 模式要重排,bank conflict 模式也会变——性能调优时要用 ncu 重看 shared memory 冲突,FP16 时代的 swizzle 参数直接搬过来通常不是最优。
吞吐兑现的折扣。wgmma FP8 的标称峰值是 FP16 的两倍,但内核实测 rarely 到两倍:scale 应用、rescale、布局转换都要吃指令发射槽,Attention 又不是纯 GEMM(softmax 占三到四成时间)。FA3 的公开数字里 FP8 相对 FP16 的实测加速在 1.5 到 1.8 倍区间,预期管理要按这个区间而不是按峰值算。另一个平台差异:FP8 MMA 是 Hopper 起的硬件能力,Ampere 及更早的卡没有,FP8 内核在这些平台上只能走「解量化到 FP16 再算」的模拟路径——此时 FP8 只剩显存和带宽收益,没有算力收益,选型时要分清自己的卡在哪一代,平台代际差异见 B200 与 GB200 服务化架构 对 Blackwell FP8 增强的讨论。
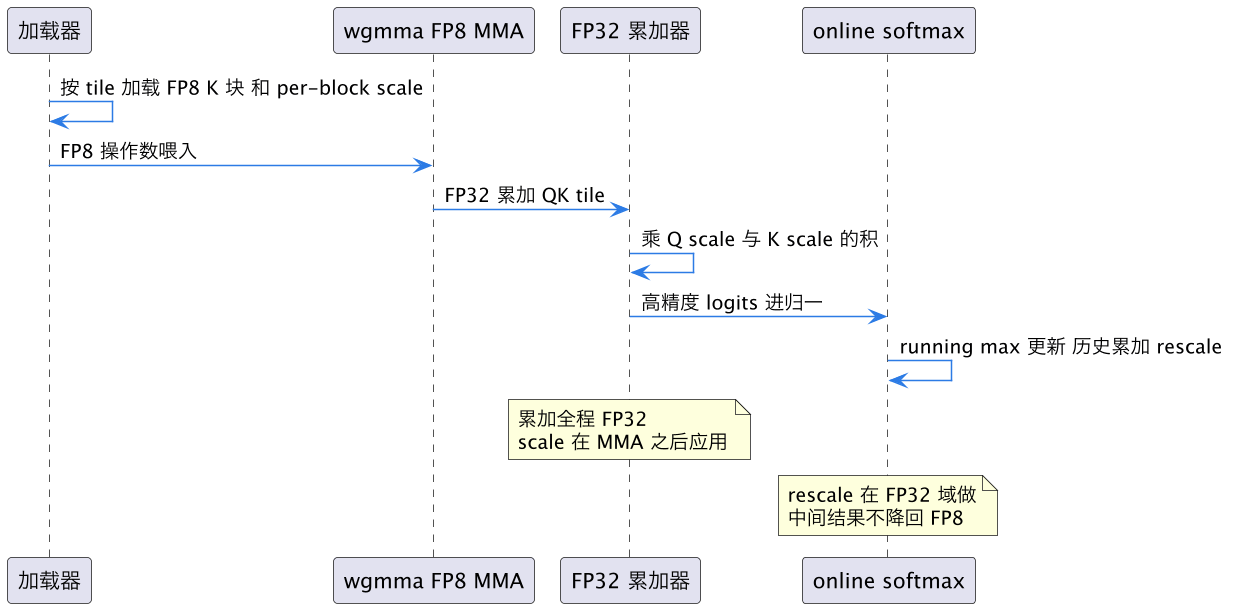
上面这张时序图把单个 tile 的数据流画出来了。核心信息是两个 note:FP8 只存在于「存储和 MMA 输入」两个位置,计算链路的其余部分全部高精度——这个「FP8 在边界、FP32 在内部」的原则是全部实现要点的公约数。
四、精度验收与失效信号
前三节解决了「怎么实现对」,这一节回答「怎么证明对」——数值路径的改动,验收体系和实现本身同等重要。FP8 注意力的验收不能只看端到端困惑度,要分层测,每层有各自的判据和各自能暴露的问题类别。内核级:固定输入对比 FP8 内核和 FP16 参考实现的输出,logits 的最大绝对误差应小于 softmax 噪声阈值(经验值 0.02 以下),逐 head 检查——某些 head 的 K 分布尖锐,是误差的重灾区。模型级:跑长上下文任务(大海捞针、长文档问答),FP8 的误差随序列长度累积,短序列测试测不出来。业务级:在真实流量上灰度对比接受率类指标(如果开了投机解码,接受率对分布漂移极度敏感,是分布级误差的金丝雀)。
失效的三个典型信号:长序列上输出开始复读(running max 的 rescale 写错了)、特定 head 的注意力模式塌缩成均匀分布(K 的 scale 粒度太粗)、batch 内长请求和短请求的表现分裂(scale 统计被 padding 污染)。三个信号分别对应第三节的四个要点,按图索骥即可。更多混合精度的搭配策略见 混合精度 FP16 BF16 FP8,KV cache 侧更激进的 int4 路线见 KV cache int4 量化。
把三层验收的判据和方法收成一张速查表,上线前逐项打勾:
| 层级 | 方法 | 通过判据 | 能暴露的问题 |
|---|---|---|---|
| 内核级 | 固定输入对拍 FP16 参考 | logits 最大绝对误差小于 0.02 逐 head 检查 | scale 粒度太粗 布局错误 |
| 模型级 | 长上下文基准 大海捞针 长文档问答 | 与 FP16 基线持平或损失在任务容忍线内 | 累加降精度 rescale 错误 |
| 业务级 | 影子流量双跑对比逐 token logprob | 差异 P99 在阈值内 投机接受率无显著漂移 | 分布级漂移 RoPE 顺序错误 |
灰度上线的方法也值得一说。FP8 注意力改的是数值路径,全量切换的风险远高于普通功能开关,标准姿势是双跑对比:影子流量同时过 FP8 内核和 FP16 内核,对比输出的逐 token logprob 差异分布,差异的 P99 落在阈值内再切小流量,小流量稳定一周再放大。切换后要盯的业务指标除了困惑度替身指标,还有投机解码接受率(如果开了投机)和长上下文任务的抽检通过率——这两个对数值漂移最敏感。回滚预案要提前演练:FP8 和 FP16 的 KV cache 格式不同,回滚不是改个配置,是清空 cache 或做格式转换,切换窗口要选在流量低谷。
这一篇在知识体系里的位置
本篇是低精度推理专题的内核实现篇:FP8 格式基础在 FP8 e4m3 与 e5m2 推理,内核整体架构在 FA3 Hopper FP8 attention 和 FlashAttention 内存分块,scale 粒度方法论在 LLM 量化 per-token scale,精度体系在 混合精度 FP16 BF16 FP8,上层选型地图在 注意力内核优化全景。
总结
FP8 注意力的成败取决于「量化谁、scale 多细、内核怎么写」三件套:Q/K/V 敏感度排序是 V 最耐受、K 居中配 per-channel、Q 最敏感但收益最小故保高精度,主流配置是 K、V 上 FP8 打带宽靶心;scale 粒度要和内核 tile 结构对齐,per-block(64 到 128 元素)以约 3% 存储开销换精度与数据流兼容,是 FA3 与 DeepSeek 系的共同选择;内核实现守住「FP8 只在存储和 MMA 输入边界、FP32 贯穿累加与 online softmax 内部」的原则,scale 在 MMA 之后应用、rescale 不降回 FP8;验收分层做——内核级逐 head 对误差、模型级测长上下文、业务级用投机接受率当金丝雀,复读、注意力塌缩、长短请求分裂是三个按图索骥的失效信号。