APL 电流特征化:给每个标准单元拍一张「电流照片」
做动态 IR drop 分析的工程师都知道:RedHawk/Totem 这类工具的压降结果准不准,一半看电源网寄生提取,另一半看每个标准单元翻转时从电源轨「抽」的电流长什么样。后者不是靠 .lib 里那张二维功耗表能给出的——它需要的是一条随时间变化的电流波形,这就是 APL 电流特征化(Apache Power Library characterization)要干的事:对每个标准单元、每种输入翻转组合、每组 slew 与负载条件,用 SPICE 仿真出一条精确的瞬态电流波形,建成电流波形库。Liberty 多视图数据介绍过 .lib 里 CCS power 等视图的定位;本篇只聚焦 APL 这条支线:它和 CCS power 怎么分工、建库流程怎么走、波形库内部什么结构、波形偏差会怎样传导到 IR 分析结果。
本文要回答的问题
- 已经有了 .lib 的功耗数据,为什么动态 IR 分析还要单独做 APL 电流特征化?
- 一个 APL 库从 netlist 到交付要走过哪些环节,每个环节的精度代价是什么?
- 电流波形库内部按什么维度组织,查库时缺角怎么办?
- 波形的峰值、宽度、面积偏差分别怎样影响 IR drop 和电迁移结论?
一、为什么 .lib 不够用:APL 与 CCS power 的分工
静态功耗分析(PrimeTime PX 一类)只需要「这次翻转消耗多少能量」——一个标量,对 slew 和负载插值即可。动态 IR drop 分析要的多得多:它把整条时钟周期内成千上万个单元的电流波形按翻转时刻叠加到电源网 RLC 模型上做瞬态仿真,所以必须知道电流在时间轴上的形状。CCS power(Composite Current Source power,Synopsys liberty 的电流源功耗模型)其实已经存了电流波形,那 APL 为什么还独立存在?区别在建库目标和消费方:
| 维度 | CCS power(.lib 内) | APL 电流波形库 |
|---|---|---|
| 主要消费方 | 门级功耗分析、部分 STA 工具 | RedHawk/Totem 动态 IR 与电迁移分析 |
| 波形建模重点 | 翻转能量与近似电流形状,供功耗积分 | 电源轨/地轨分别的瞬态电流,含寄生二极管与内部节点效应 |
| 建模维度 | slew × 负载,单输出翻转 | 输入组合 × slew × 负载 × 电源电压,多引脚同时翻转可展开 |
| 内部开关电流 | 与输出电流合并近似 | 显式分离内部(short-circuit + 充内部节点)与输出电流 |
| 文件载体 | .lib/.db 文本或编译库 | 二进制 apl 目录(current/cap/pw 分文件) |
| 建库工具 | Liberate 等通用特征化器 | Apache/Ansys aplcmp 专用流程 |
一句话概括:CCS power 回答「耗多少电」,APL 回答「电流在什么时刻、从哪根轨、以什么形状抽走」。后者才喂得动瞬态电网仿真,这也是 APL 电流特征化必须与工艺 PDK 的器件模型绑定、不能用归一化数据糊弄的原因。
二、建库流程:从 foundry 模型到 apl 目录
一套 APL 库的完整生产链可以拆成五步,每步都有明确的精度开关:
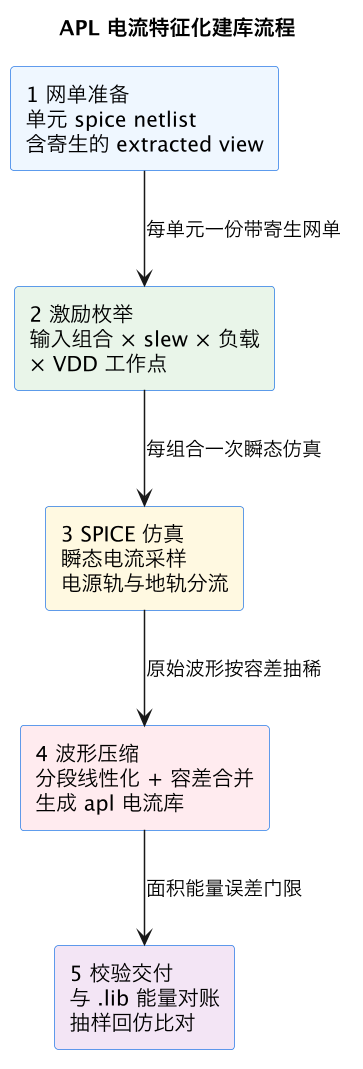
- 网单准备:用 LVS/PEX 后的 extracted view(含版图寄生 RC)而不是原理图网单。寄生电容直接抬高内部开关电流分量,用原理图网单建库,内部电流普遍低估 10% 以上。抽取流程与 LVS 器件识别与提取 共用同一套 foundry deck。
- 激励枚举:这是 APL 与 CCS 拉开差距的地方。除了 slew × 负载二维表,还要枚举有意义的输入组合(与门要区分单输入翻转与多输入同翻)、输出翻转方向(rise/fall 波形不对称)、以及 VDD 工作点(DVFS 设计需要多电压库角,与 MMMC 角模式管理 的 corner 定义对齐)。
- SPICE 仿真:对每个组合跑瞬态仿真,分别在 VDD 和 VSS 引脚上采样电流。仿真精度选项(reltol、最大步长)直接决定波形毛刺是否被数值阻尼吃掉——动态 IR 关心的是纳秒级尖峰,步长太松等于把最关键的峰值磨平。
- 波形压缩:原始采样点不可能全存,aplcmp 按容差做分段线性化,把形状相近的波形合并成参数化模板。容差是精度与库体积的主交换旋钮。
- 校验交付:两条硬闸门——与 .lib 的翻转能量对账(波形积分应与 CCS 能量在给定误差内一致),以及抽样回仿(拿库中插值波形与 SPICE 重跑比对峰值误差)。
一个 1000+ 单元的库、五种输入组合、5×5 的 slew 负载表、三个电压角,瞬态仿真次数轻松上十万,建库算力通常按周排队,这也是为什么 APL 库版本必须纳入 数据管理 X4 统一基线。
三、波形库的内部结构:查库时发生了什么
建好的 apl 目录对 RedHawk 表现为三张查得飞快的表。理解它的组织维度,才能看懂「查库缺角」这一类精度告警:
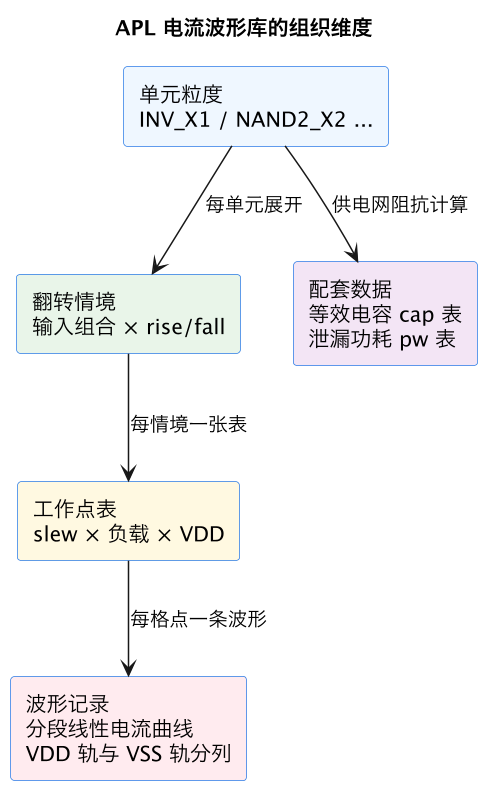
上图自上而下是查库路径:工具先定位单元,再按实例的实际输入翻转情境(来自向量或 VCD/SAIF 翻转率数据 的传播结果)选情境,然后在 slew × 负载 × VDD 三维表上插值取波形。两个容易踩的坑都出在插值环节:
- 外推缺角:实例的实际 slew 超出建库表范围(比如高速时钟树上极陡的边沿),工具只能外推,峰值电流可能被显著低估。建库时 slew 上限要按最快时钟域留裕量。
- 情境缺省:多输入同时翻转没建库时,工具退化为单输入波形叠加,而叠加会重复计算内部电流,多输入同翻的峰值往往被高估——对 worst-case IR 是「安全」方向,却可能把 去耦电容插入 的需求量算胖。
配套的 cap 表(等效输入/内部电容)和 pw 表(泄漏)同样关键:cap 表参与电网等效阻抗计算,泄漏则叠加成静态电流底座。
四、波形精度怎样传导到 IR 结论
动态 IR drop 对电流波形有三个敏感分量,各自的传导路径不同:
- 峰值高度:直接决定瞬态压降尖峰的幅度。波形峰值低估 15%,热点区域的动态压降几乎同比例低估——这是最危险的偏差方向,因为 IR sign-off 是单点阈值判定,差一点就是过与不过的区别。
- 波形宽度(持续时间):决定压降事件与电网 RLC 谐振的相互作用。窄脉冲激励出的振铃在电网阻抗峰值频率附近会被放大;宽度建得太宽则把能量摊平,掩盖 di/dt 风险——这也是 信号 EM 与电源 EM 分析共用同一电流库时,宽度偏差对电源 EM 的 Joule 加热估计尤其敏感的原因。
- 波形面积(总电荷):决定平均电流与静态压降底座,与 .lib 能量对账守的就是这一项。面积对了但形状错了,是「平均正确、瞬时错误」,恰恰是动态 IR 分析最典型的失效模式。
工程上常见的精度事故,多半不是仿真器算错,而是库角错位:用 tt/25°C 建的 APL 库去跑 ss/高温角的 IR 分析,驱动电流的角间差异(可达 20% 量级)被整体平移进结果。防线有两条:APL 库角与 PEX RC 角选择、S5 签核角(见 S5 签核收敛)强制对齐;库版本变更纳入 交接契约 X1 的对账清单,换库必重跑基准用例比对压降分布漂移。
这一篇在知识体系里的位置
- 数据主线:Liberty 多视图 讲 .lib 各视图分工,本篇是其 CCS power 视图在 IR 场景下的纵深补充;
- 下游消费:波形库喂给动态 IR 与去耦优化(见 去耦电容插入)、电迁移分析(见 信号 EM 与电源 EM);
- 上下游:单元网单来自 LVS 提取,翻转情境来自 VCD/SAIF 翻转率,角对齐见 MMMC 管理 与 S5 签核收敛。
总结
APL 电流特征化是用带寄生网单对标准单元逐情境跑 SPICE、把电源轨与地轨的瞬态电流波形建成插值库的过程,它与回答「耗多少电」的 CCS power 分工明确——APL 回答「电流以什么形状抽走」;建库的关键决策在激励枚举的覆盖度与波形压缩容差,而峰值、宽度、面积三类波形偏差分别传导为动态压降低估、振铃误判与平均电流失真,库角错位则是最常见的整体性平移事故,必须用角对齐与换库重跑来防。