FPGA 进阶 20:仿真加速与覆盖率——仿真太慢怎么办、事务级与协同仿真
本文是
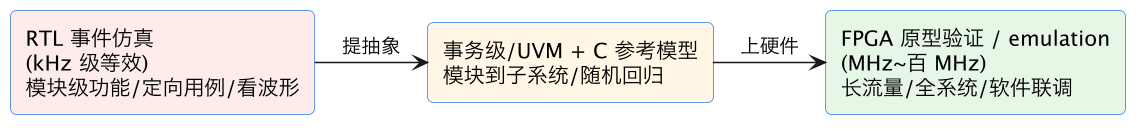
fpga/进阶层第 24 篇。小设计里仿真秒级出波形,但规模一大(整条数据通路、带 DDR/PCIe/以太网行为模型、跑真实帧和长流量),事件驱动的 RTL 仿真慢到每秒几千个时钟周期,跑一秒真实数据要几小时。这篇讲两件事:怎么让仿真快起来(少转储、提抽象、BFM/事务级、行为模型、FPGA 原型加速/协同仿真),以及怎么用覆盖率判断「测没测全」。怎么写自检 testbench 在下一篇 进阶 25。
本文要回答的问题
- RTL 仿真为什么慢?瓶颈在事件、层次还是波形 IO?
- 不花钱/少花钱能怎么提速(波形、仿真器、抽象、行为模型)?
- 事务级/BFM、C/Python 参考模型、DPI 怎么解放激励和检查?
- 什么时候必须上 FPGA 原型验证/协同仿真?
- 代码覆盖率和功能覆盖率差在哪?为什么 100% 覆盖不等于没 bug?
一、RTL 仿真为什么慢
事件驱动仿真:每个时钟沿、每次信号跳变都生成一个「事件」,仿真器按时间排序、逐个唤醒敏感逻辑求值。设计越大、跳变越多,事件量爆炸式增长。
慢的三大来源:
1. 层次/事件:所有模块每个沿都在求值,无关逻辑也在跑
2. 波形转储:全程 $dumpvars 所有层次所有信号 → 海量磁盘 IO
3. 重模型:完整 DDR/PCIe/以太网 IP 的周期精确行为模型极其笨重
外加:免费仿真器(iverilog)本身比商业 VCS/Xcelium 慢 1~2 个数量级后果:万级触发器设计全速跑,每秒可能只模拟几千~几万周期;一秒真实数据(百万周期)要几十分钟。长流量回归、软件联调不能靠逐信号 RTL 仿真硬跑。
二、提速手段(从便宜到昂贵)
| 手段 | 做法 | 提速量级 | 成本 |
|---|---|---|---|
| 少转储波形 | 只 dump 关键层次、只在出错时段 dump | 数倍~数十倍 | 零,立刻可做 |
| 换快仿真器/编译优化 | VCS/Xcelium 替代 iverilog;开优化、并行回归 | 数十倍 | 软件 license |
| 事务级激励 / BFM | 用 SV/UVM task 发「一个事务」,BFM 内部生成握手时序 | 开发+仿真效率 | 写 TB 功夫 |
| C/Python 参考模型 + DPI | 参考算法/记分板用高级语言写,经 DPI-C 调用 | 参考模型快几十倍 | 建模功夫 |
| 行为模型替代真实 IP | 用简单 AXI 响应/延迟模型替代完整 DDR 控制器 | 大设计数倍~数十倍 | 保证模型保真 |
| FPGA 原型/仿真加速 | 设计综合到 FPGA/emu 上真跑 | kHz→MHz~百 MHz | 板子/环境 |
| 协同仿真 co-sim | 待验关键模块上 FPGA,其余留仿真器 | 折中 | 环境复杂 |
少转储波形(零成本先做):
// 别全程全层次 dump:initial $dumpvars(0, tb);  // 0=所有层次,巨慢
initial begin
  wait (tb.u_dut.start_err == 1'b1);   // 出错附近才开始
  $dumpvars(1, tb.u_dut.u_fifo);        // 只 dump 这一层
  #100000 $dumpoff;
end事务级/BFM:把 AXI/UART 等接口时序封进 task,TB 只发事务:
task automatic axi_write(input bit [31:0] addr, input bit [31:0] data);
  bfm.awaddr <= addr; bfm.awvalid <= 1; wait(bfm.awready); bfm.awvalid <= 0;
  // ... w 通道 / b 响应由 BFM 内部完成,TB 不用逐拍 toggle
endtask
import "DPI-C" function void c_ref_model(input int in_data, output int out_data);
FPGA 原型/协同仿真:要跑真实长流量、软件驱动/协议栈时,把设计综合到 FPGA 真跑(专家线主题);协同仿真折中——待验模块上 FPGA,其余留事件仿真器,经事务接口交换数据。
三、覆盖率:怎么知道测没测全
| 覆盖率类型 | 谁统计 | 回答什么 | 举例 |
|---|---|---|---|
| 代码覆盖率 | 工具自动 | 哪些 RTL 结构被跑到 | 行(Line)、翻转(Toggle)、条件(分支)、状态机(FSM) |
| 功能覆盖率 | 你用 covergroup 定义 | 关心的场景/值域/组合演到没 | FIFO 空/半/满、burst 长度 1/最大/随机、满时写/空时读 |
| 断言/自检 | 你写 checker | 跑的时候结果对不对 | 属性断言、参考模型比对(下一篇) |
代码覆盖率低 → 有代码从没被测试碰到(有死角);但代码覆盖率 100% ≠ 没 bug——错误的加法被跑到、翻转照样满。功能覆盖率举例:
covergroup cg_fifo @(posedge clk);
  cp_level: coverpoint fifo_level {
    bins empty = {0}; bins mid = {[1:DEPTH-2]}; bins full = {DEPTH-1};
  }
  cp_action: coverpoint {wr_en, rd_en} {
    bins wr_only = {2'b10}; bins rd_only = {2'b01};
    bins both    = {2'b11}; bins neither = {2'b00};
  }
  cx_full_wr: cross cp_level, cp_action;  // 关键组合:将满时还写
endgroup三者闭环:代码覆盖率保「没死角」、功能覆盖率保「关心的边界场景都演到」、自检断言保「演的时候结果正确」。回归里把覆盖率和自检结果一起收集,覆盖率随版本只升不降。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 全程全层次 dump 波形 | 仿真慢到没法用 | 只在关键时段/层次转储 |
| 用 iverilog 跑大回归 | 慢 1~2 个数量级 | 有条件上 VCS/Xcelium |
| 完整 DDR/PCIe 模型做模块级仿真 | 笨重、跑不长 | 简单行为模型/BFM 替代 |
| 逐信号 toggle 写激励 | 啰嗦、易错、慢 | BFM/task 发事务 |
| 只看代码覆盖率 100% 就收工 | 边界场景没测、bug 漏网 | 加功能覆盖率 + 自检断言 |
| 长流量/软件联调硬靠 RTL 仿真 | 几小时跑不完 | FPGA 原型/协同仿真 |
相关与延伸
前置/配套:Testbench 与仿真入门、FPGA 调试方法论、FIFO 设计(覆盖率常拿 FIFO 边界举例)。 怎么写自检 TB、文件读写、参考模型、随机约束,见下一篇 进阶 25 高级 Testbench;FPGA 原型验证深水区见专家层。
一句话总结
RTL 仿真是事件驱动的,规模一大慢在「全层次每沿求值 + 全程全信号 dump 波形 + 笨重 IP 模型」,提速按成本递进:先少转储/分段 dump(零成本数倍)→ 换快仿真器开优化 → **事务级 BFM + C/Python 参考模型(DPI)**发事务而非逐信号 toggle、用简单行为模型替代完整 IP → 长流量和软件联调跑不动就上 FPGA 原型验证/协同仿真(kHz 提到 MHz~百 MHz)。覆盖率回答「测没测全」:代码覆盖率(行/翻转/条件/FSM,工具自动)保没死角,功能覆盖率(covergroup 定义的边界值域与场景组合)保关心情形演到,自检断言保结果对——代码覆盖率 100% 绝不等于没 bug,三者闭环、随回归只升不降。