测试中复位处理:mid-test reset 的 phase 跳转、objection 清理与验证组件状态复位全案
更新时间:2026-10-05。测试中复位处理(mid-test reset,测试进行到一半拉复位)是芯片验证里最容易把环境打崩的场景:上电复位大家都能跑通,因为那时 testbench 里什么状态都没有;而跑到 main_phase 一半、driver 正发着事务、scoreboard 队列里压着几十笔期望数据的时候复位信号突然有效,环境里每一处残留状态都会变成一颗雷。站内的 复位初始化验证 讲的是复位本身的设计正确性,UVM domain phase jump 讲了 phase 跳转的机制,UVM 事务记录调试 提供了在途事务追踪判定的工具;这一篇把视角拉到整个验证环境:mid-test reset 发生时,phase、objection、sequence、driver/monitor、scoreboard 五层分别要怎么清理,才能复位之后接着跑而不假死、不误报。
本文要回答的问题
- mid-test reset 与上电复位对验证环境的挑战差在哪,为什么「环境能跑上电复位」什么都证明不了?
- phase 跳转有哪几种做法,跳回 reset_phase 和 kill 掉所有 sequence 各有什么坑?
- objection 悬挂为什么会把仿真卡死,清理的正确时机在哪里?
- driver 和 monitor 的内部状态(握手半途、协议状态机、流水线记录)要复位到什么程度?
- scoreboard 里压着的期望队列该全清、按时间戳清还是按地址清,三种模式怎么选?
一、为什么 mid-test reset 是环境健壮性的试金石
先看一组事实对比。上电复位发生时,testbench 刚结束 build/connect 阶段,driver 没有发过任何事务,scoreboard 的所有队列都是空的,sequence 还没启动——环境里没有任何需要清理的状态,所以「复位后跑通」对上电复位是零成本事件。mid-test reset 完全相反:复位有效的那个时刻,环境里可能同时存在 driver 发到一半的握手、monitor 采样到一半的帧、sequencer 上挂着的多个 sequence、scoreboard 里几十笔等待比对的期望事务、reference model 里已经更新的中间态。复位信号一拉,DUT 内部状态瞬间清零,而 testbench 的这些软件对象不会自动清零——环境状态与 DUT 状态从此失配,后续所有比对都是拿新 DUT 的行为对旧世界的期望,轻则误报连环 UVM_ERROR,重则 objection 悬挂把仿真拖到超时。
真实项目里的翻车现场高度雷同:复位用例单独跑能过,串在随机回归里就间歇性失败;失败日志里 scoreboard 报的一批 mismatch,事务时间戳全在复位之前。根因几乎都是同一类——复位清理只做了「最显眼的那一层」(通常是 kill sequence),driver/monitor/scoreboard 的深层状态没人管。
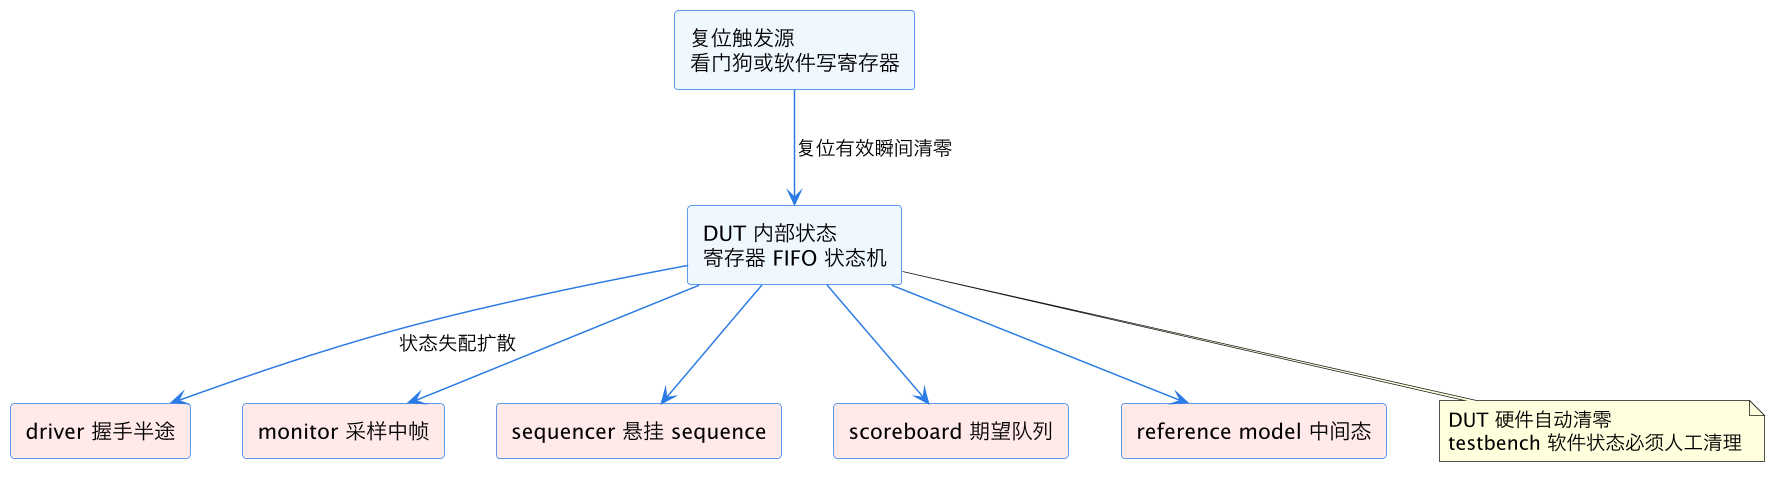
上图把 mid-test reset 的破坏面画清楚了:复位源只作用于 DUT,五类 testbench 残留状态全要靠环境自己去对齐。这就是本篇的主线——按层给出每一类状态的清理模式。
二、phase 层:跳回 reset_phase 还是原地清理
UVM 的运行时 phase 是单向流水线(reset → configure → main → shutdown),mid-test reset 发生后,主流做法有三种。
第一种是 phase jump:在检测到复位有效时,从 main_phase 跳回 reset_phase,让环境重新走一遍复位后的初始化流程。UVM 1.2 的写法是在 test 或 env 里调用 phase.jump(uvm_reset_phase::get())。这个做法语义最干净——复位后本来就该重新配置 DUT,configure/main 重走一遍和真实芯片的行为一致。坑有两个:jump 只影响发起 jump 的那个 domain,多 domain 环境(比如 DUT 有两个异步时钟域各挂一套 agent)必须每个 domain 分别 jump,细节见 UVM domain phase jump;另外 jump 不会自动 kill 正在运行的 sequence,sequence 不杀,driver 还会往已经复位的 DUT 里灌旧激励。
第二种是 kill sequence 加原地继续:不 jump phase,只是在检测到复位后 sequencer.stop_sequences() 或对所有 sequence 调 kill(),然后由测试序列自己重新发复位后的初始化激励。优点是控制粒度细、不用动 phase 机制;缺点是「重新初始化」的逻辑完全靠测试手写,容易漏步骤(比如忘了重新配置寄存器模型)。
第三种是 软复位用 objection 屏障:把复位封装成一个「环境级事件」,所有组件订阅这个事件各自清理,测试序列在复位后重新挂起 objection 继续跑。这种做法本质是把 phase jump 的工作手工化,灵活但最考验纪律。
| 做法 | 语义正确性 | 实现成本 | 常见坑 |
|---|---|---|---|
| phase jump 回 reset_phase | 最高,流程与真实芯片一致 | 中(多 domain 要逐个 jump) | 忘 kill sequence,旧激励灌进新 DUT |
| kill sequence 原地继续 | 中,依赖测试手写初始化 | 低 | 漏初始化步骤,回归间歇性失败 |
| objection 屏障加事件订阅 | 中 | 高(每个组件都要写清理钩子) | 清理钩子不齐,一处漏全盘乱 |
工程建议:单一时钟域、复位流程简单的设计用第二种;多时钟域、复位后要重走完整配置流程的用第一种;第三种只在有历史包袱的老环境里使用。
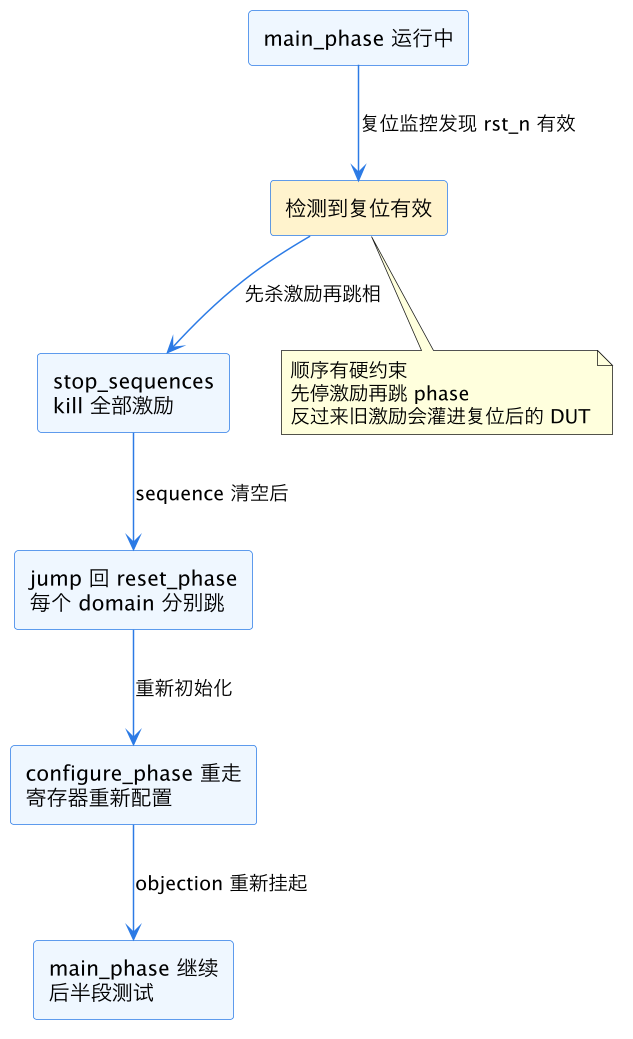
这张流程图强调的是动作顺序:检测复位 → 杀 sequence → phase jump → 重走配置 → 继续测试。顺序不能颠倒——先 jump 后杀 sequence 的话,jump 触发的 phase 切换回调里 sequence 还活着,driver 可能在 reset_phase 里发出一笔带着复位前地址的事务。
三、objection 层:悬挂为什么会卡死仿真
objection 是 UVM 控制 phase 结束的投票机制:有任何一个组件 raise 着 objection 没 drop,phase 就不结束。mid-test reset 场景下 objection 有两个经典死法。
死法一:sequence 被 kill 后 objection 没释放。 sequence 的 body 里常见写法是开头 raise objection、结尾 drop。sequence 被外部 kill 时,body 的进程被强制终止,结尾那句 phase.drop_objection(this) 永远执行不到——objection 悬挂,phase 永不结束,仿真一直跑到超时。解法有两种:一是用 uvm_sequence_base 提供的 pre_body/post_body 配对机制不够时,改用 starting_phase.raise_objection 配合在 do_kill 回调里补 drop;二是更稳的做法——objection 不由 sequence 拿,改由 virtual sequence 或 test 层统一管理,kill 普通 sequence 不影响 objection 计数。
死法二:phase jump 后 objection 状态错位。 jump 回 reset_phase 时,UVM 会清空目标 phase 的 objection 计数,但源 phase(main_phase)的 objection 状态在不同仿真器版本下行为有差异——有的实现会把 main_phase 的 objection 一并清掉,有的不会。工程上不要依赖这个行为,在 jump 之前显式把当前 phase 的 objection 全部 drop 干净,jump 之后由 reset_phase 的初始化 sequence 重新 raise。
清理的正确时机用一张时序图说明。
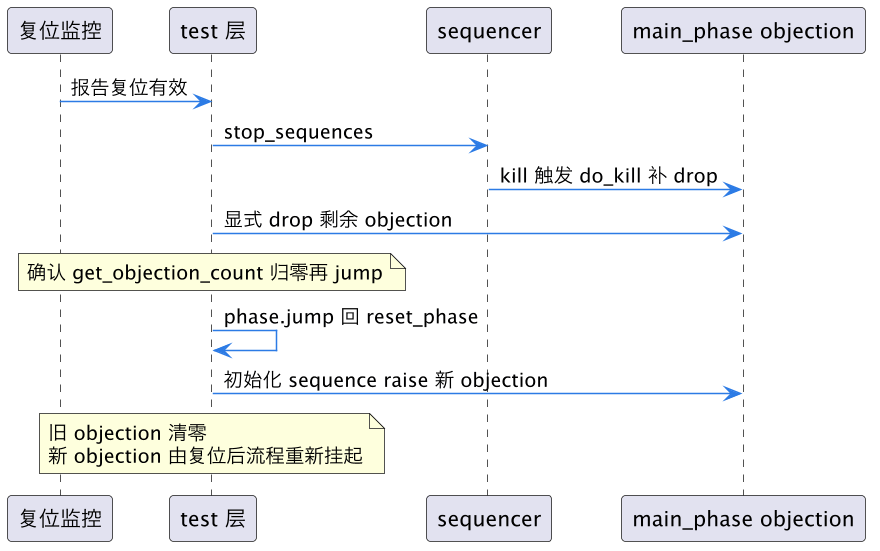
图里的关键检查点是 jump 之前的 get_objection_count() 归零确认——把这句断言写进复位处理代码里,悬挂类 bug 会在第一次回归就现形,而不是潜伏到深夜回归才炸。
四、driver 与 monitor:组件级状态复位
sequence 杀掉了、phase 跳好了,轮到组件内部的深层状态。driver 和 monitor 是重灾区,因为它们都贴着信号层,复位瞬间手里多半握着半成品。
driver 的清理清单有四项。第一,握手半途:driver 可能刚把 valid 拉高、还没等到 ready,DUT 就复位了——复位后 driver 必须把接口信号拉回空闲值(valid 拉低、数据清零),否则复位释放瞬间 DUT 会看到一个「没有源头」的 valid。标准做法是在 driver 的 run_phase 里用 fork/join_any 同时等接口时钟和复位事件,复位事件先到时跳进清理分支。第二,driver 内部的协议状态机(比如 AXI driver 的 outstanding 计数、写数据对齐队列)全部清零。第三,seq_item_port 里可能还卡着一笔 get_next_item 之后没 item_done 的事务,必须补一次 item_done 或走 sequencer 的复位流程,否则 sequencer 的仲裁状态会错。第四,如果 driver 用了 uvm_event 或 barrier 和别的组件同步,事件要重新 trigger 或复位。
monitor 的清理逻辑不同:monitor 不驱动信号,但它在采样的帧可能只采了一半。复位后这半帧绝不能写进 analysis port——一旦写出来,scoreboard 就会收到一笔「复位前的半截事务」当成新 DUT 的行为去比对。正确做法是 monitor 内部维护「帧进行中」标志,复位有效时把半帧丢弃、标志清零、协议解析状态机回到 idle。monitor 里挂着的覆盖率采样也要注意:复位期间采到的信号全 0 是复位行为不是功能行为,应该用 sva-disable-iff-reset 同款思路给覆盖率 bins 加复位豁免,相关写法见 SVA disable iff 复位豁免。

这张图把 driver 和 monitor 的清理动作并列展开,两者由同一个复位事件驱动、互不等待——清理必须是「各自就地完成」而不是「driver 先清完通知 monitor」,多组件环境里任何跨组件的清理依赖都会引入新的死锁面。
五、scoreboard:期望队列的清空模式
scoreboard 是 mid-test reset 里最容易翻车、也最能体现设计功力的一层。复位瞬间 scoreboard 里压着的期望队列(expected queue)是「旧 DUT 世界」的产物,复位后 DUT 状态清零,这些期望永远不会被匹配——不清掉,它们要么在复位后被新事务误匹配(mismatch 连环报),要么在 phase 结束时被「队列非空」检查报成遗漏。清空有三种模式,按 DUT 的复位语义选。
模式一:全清(flush all)。 复位把所有未完成事务一笔勾销——这是大多数硬核复位(hard reset)的语义,也是默认做法。实现上在 scoreboard 里写一个 flush() 方法,订阅复位事件,事件到达时清空所有期望队列、比对计数器、关联数组。reference model 里已经更新的中间态也要同步回滚或重建,否则后半段比对的「参考值」还带着复位前的历史。
模式二:按时间戳选择性清。 有些设计的复位语义是「复位前已完成的操作保持有效」(比如配置寄存器有复位保持区),scoreboard 就要区分:时间戳早于复位点且已判定「DUT 侧已提交」的期望保留,其余清掉。实现上给每笔期望打时间戳和提交标志,flush 时按标志过滤。
模式三:按地址/资源域清。 多复位域设计里,复位只清掉某个域的状态(比如只复位数据通路、保留控制面)。scoreboard 按域分队列,复位事件带域标识,只清对应域的期望。这种模式复杂度最高,但对分区复位(partial reset)的芯片是唯一正确的做法。
| 清空模式 | 适用复位类型 | 实现要点 | 风险 |
|---|---|---|---|
| 全清 | 硬核复位、全局复位 | flush 订阅复位事件,队列计数器全清 | reference model 忘回滚,参考值带旧历史 |
| 按时间戳清 | 有复位保持区的设计 | 期望打时间戳加提交标志,按标志过滤 | 提交标志判定错了,保留了一批死期望 |
| 按域清 | 分区复位多复位域 | 按域分队列,复位事件带域标识 | 域划分和环境不一致,清错队列 |
一个容易被忽视的细节:scoreboard 清空的同时,正在 analysis FIFO 里排队还没被取走的事务也要一并处理——uvm_tlm_analysis_fifo 里的积压数据和期望队列是两条通道,只清队列不清 FIFO,复位后第一笔比对拿到的还是旧数据。
六、落地清单与回归加固
把前五节收拢成一份可直接对照的落地清单。环境级:复位监控组件独立存在、用 config_db 或 event pool 广播复位事件;test 层持有 phase jump 逻辑。phase/objection 级:jump 前显式 drop 全部 objection 并断言计数归零;objection 统一由 test 或 virtual sequence 管理,普通 sequence 不直接持有。组件级:driver 实现复位分支拉回信号、清协议状态、补 item_done;monitor 丢半帧、回 idle、覆盖率豁免。scoreboard 级:按复位语义选清空模式,flush 同时清期望队列和 analysis FIFO 积压,reference model 回滚中间态。
回归加固有两个便宜而有效的手段。一是随机时刻复位:把复位触发点做成在测试窗口内均匀随机,而不是固定在几个「安全时刻」——固定在安全时刻的复位永远测不到 driver 握手半途的那条路径。二是复位后比对哨兵:复位释放后的第一笔事务打上特殊标签,scoreboard 对它单独计数,一旦它 mismatch,直接定位到清理遗漏而不是后半段的正常功能 bug。这两个手段成本极低,却能把「间歇性复位回归失败」从玄学变成可复现的定向调试。
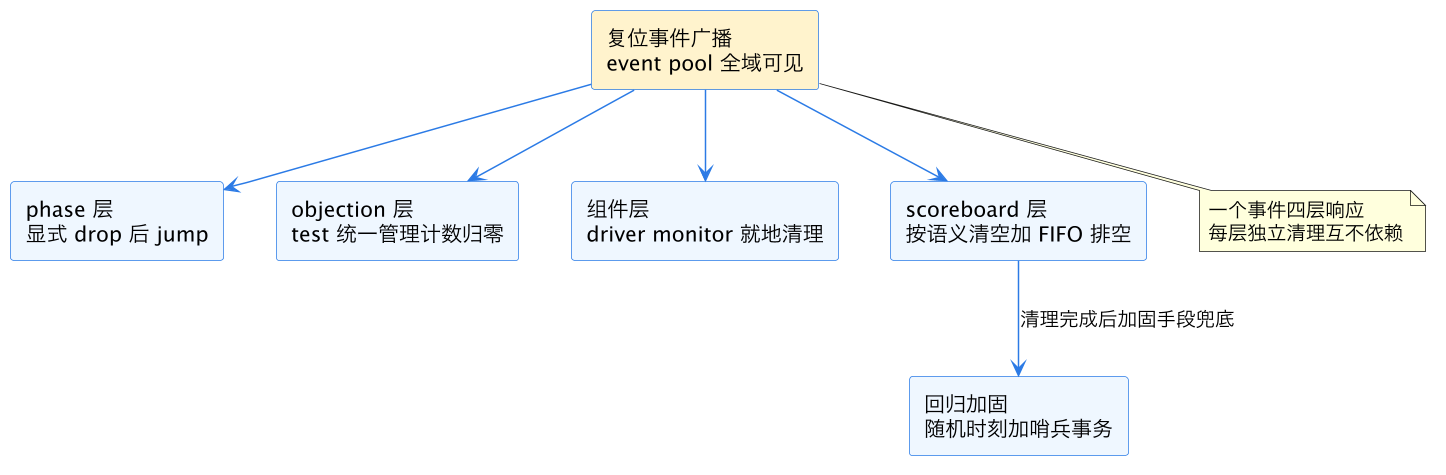
这张收束图把全文结构画成「一事件四层响应」:复位事件广播后,phase、objection、组件、scoreboard 四层各自独立清理,回归加固作为最后的兜底。记住这个骨架,以后任何新组件加进环境,只问一个问题——它属于哪一层、订阅了复位事件没有。
这一篇在知识体系里的位置
本篇是复位验证主线上的环境侧补全:复位设计与初始化流程见 复位初始化验证,phase 跳转机制细节见 UVM domain phase jump,在途事务的判定与豁免见 UVM 事务记录调试,断言侧的复位豁免写法见 SVA disable iff 复位豁免。四篇加本篇构成完整的「复位 × UVM 环境」知识闭环。
总结
测试中复位处理的本质是让 testbench 的软件状态追上 DUT 的硬件清零:先杀 sequence 再跳 phase、objection 显式清零后再 jump、driver/monitor 就地清理各状态、scoreboard 按复位语义选清空模式——四层清理一次做对,mid-test reset 从回归杀手变成最有杀伤力的常规用例。