virtual sequencer 协同:多总线 agent 时序握手的 virtual sequence 模式、相位对齐与资源互斥
更新时间:2026-10-04。单个 agent 的激励好写——启一个 sequence,往自己的 sequencer 上发 item 就行。可一旦场景升级到「AXI 上先搬完一批数据,APB 配置寄存器拉高中断使能,然后中断 agent 等 IRQ 拉高后再让 AXI 读走状态」,事情就变了性质:激励不再是「发什么」,而是「谁先谁后、谁等谁、谁独占谁」。这就是 virtual sequencer 协同要解决的问题。站内的 UVM virtual sequence 启动方式 讲了 virtual sequence 怎么挂到 virtual sequencer 上、怎么拿到子 sequencer 句柄,UVM 分层 sequence 堆叠 讲了协议分层时 sequence 怎么一层调一层。这两篇解决的都是「结构」问题;本篇解决「时序」问题——多个 agent 的 sequence 之间怎么做事件握手、怎么对齐相位、怎么互斥地抢共享资源。
本文要回答的问题
- 为什么多 agent 协同不能用「各 sequence 自由跑、靠运气碰时序」的方式?
- 用 uvm_event / uvm_event_pool 做跨 sequence 握手的标准写法是什么,trigger 和 wait_trigger 的配对有哪些坑?
- 多 sequence fork/join 编排时,相位(phase)对齐和 objection 怎么处理才不提前收场?
- 多 agent 抢同一共享资源(同一 sequencer、同一寄存器、同一内存区)时,lock/grab 与软件互斥怎么选?
- 协同场景 hang 住或时序错乱时,按什么顺序排查?
一、为什么需要协同:自由跑的 sequence 碰不出确定性时序
先看一个真实的协同需求:SoC 里 DMA 通过 AXI 搬数据,搬完后配置模块通过 APB 写状态寄存器,中断控制器拉 IRQ,CPU 侧 agent 响应中断后读走结果。这个场景涉及时序上的三个硬约束:APB 写状态必须发生在 AXI 搬完之后;IRQ 等待必须在 APB 写完之前就开始监听(否则错过边沿);AXI 读结果必须等 IRQ 触发之后。
新手的第一反应往往是:在 virtual sequence 里 fork 出三个线程,各自 p_sequencer.axi_sqr.execute(...),然后指望仿真调度「差不多」能碰上。这种写法在小颗粒场景偶尔能过,但它是非确定性的——三个 sequence 的启动先后取决于 fork 线程调度,item 之间的相对间隔取决于各自 driver 的就绪时刻,换个仿真器、换个随机种子、甚至加个无关的打印,时序就可能漂移。验证的本质是「可控地制造场景」,靠运气碰出来的时序,今天过了明天挂,挂了还复现不了,是最贵的一类测试。
上图是协同问题的全貌:virtual sequence 作为编排层把各 agent 的 sequence 拉起来,但「拉起来」只是起点,真正让场景确定的是右边三要素——事件握手决定先后、相位对齐保证 objection 生命周期正确、资源互斥保证共享资源不被并发踩坏。下面三节逐个展开。
二、事件握手:uvm_event_pool 是跨 sequence 的标准信号量
跨 sequence 通信,UVM 官方给的工具是 uvm_event 和它的全局登记表 uvm_event_pool。核心思路:握手的双方不直接互相引用句柄(sequence 之间本来就不该有硬连接),而是通过一个字符串名字在 event pool 里拿同一个事件对象,一方 trigger(),另一方 wait_trigger()。站内的 UVM event pool 与 barrier 讲了 event pool 的机制细节,这里直接给协同场景的标准用法。
class coord_vseq extends uvm_sequence;
  `uvm_object_utils(coord_vseq)
  `uvm_declare_p_sequencer(virtual_sequencer)

  uvm_event_pool ep = uvm_event_pool::get_global_pool();

  task body();
    uvm_event ev_dma_done = ep.get("dma_done");
    uvm_event ev_irq_seen = ep.get("irq_seen");

    fork
      // 线程一:AXI 搬数据,完成后打事件
      begin
        axi_dma_seq dma = axi_dma_seq::type_id::create("dma");
        dma.start(p_sequencer.axi_sqr);
        ev_dma_done.trigger();
      end
      // 线程二:APB 等搬完再写状态寄存器
      begin
        apb_cfg_seq cfg = apb_cfg_seq::type_id::create("cfg");
        ev_dma_done.wait_trigger();
        cfg.start(p_sequencer.apb_sqr);
      end
      // 线程三:IRQ 监听最先启动,见到中断后通知
      begin
        irq_wait_seq irq = irq_wait_seq::type_id::create("irq");
        irq.start(p_sequencer.irq_sqr);
        ev_irq_seen.trigger();
      end
    join
  endtask
endclass这份骨架里有四个必须注意的坑。第一,IRQ 监听线程必须先于事件生产者启动——中断是边沿敏感的,如果等 APB 写完再启动 IRQ sequence,那个脉冲可能已经过去,wait 永远等不到。协同时先问自己:这个场景里谁是「错过就再不会来」的信号?它的监听者必须先挂出去。第二,ep.get("dma_done") 是先拿先建的:无论 trigger 方还是 wait 方先执行 get,拿到的都是同一个对象,名字就是全局命名空间里的键。所以事件名要带模块前缀(dma_done 不如 dma_ch0_done),否则两个测试用同名事件会互相串扰——这是 event pool 全局性带来的经典事故。第三,wait_trigger 只等「wait 之后发生的 trigger」;如果 trigger 先于 wait 执行,wait 会永远挂住。需要「曾经触发过就算数」的语义时,要么用 wait_ptrigger()(persistent trigger),要么在 trigger 前先 reset() 清掉历史。第四,事件只能传「发生」这一个比特,要传数据(比如 DMA 搬运的字节数)就配一个共享的 config 对象或 mailbox,事件只做敲门,数据走另一条路。
还有一个容易被忽略的细节:fork/join 的变体选择直接影响协同的容错性。join 要求全部线程返回,最严格也最常用;join_any 在第一个线程返回后就放行,配合 watchdog 用;join_none 放出去就不管,协同场景里基本不该出现——join_none 放出去的线程脱离了 objection 的保护范围,phase 结束时它可能还在往 driver 发 item,UVM 会在 phase 跳转时强杀线程,scoreboard 里留下半个事务的期望,报一堆莫名其妙的不匹配。如果你发现自己想用 join_none,先问「这个线程的寿命谁负责」,答不上来就改回 join。另外,多个等待方等同一个事件时,uvm_event 的 trigger 是广播语义,所有 wait_trigger 都会放行,这正好适合「一个完成信号放行多方」的扇出场景(比如 DMA 完成后 APB 写状态和覆盖率采样线程同时启动),不需要额外发多个事件。
| 等待原语 | 语义 | 适用场景 |
|---|---|---|
wait_trigger() | 只等调用之后的下一次触发 | 严格先后关系(A 完 B 始) |
wait_ptrigger() | 历史上触发过就立即返回 | 状态类事件(ready 已拉高) |
wait_on()(uvm_event 派生) | 条件变量式等待 | 需携带数据的握手 |
| barrier | 多方到齐再一起放行 | N 个 agent 同步起跑 |
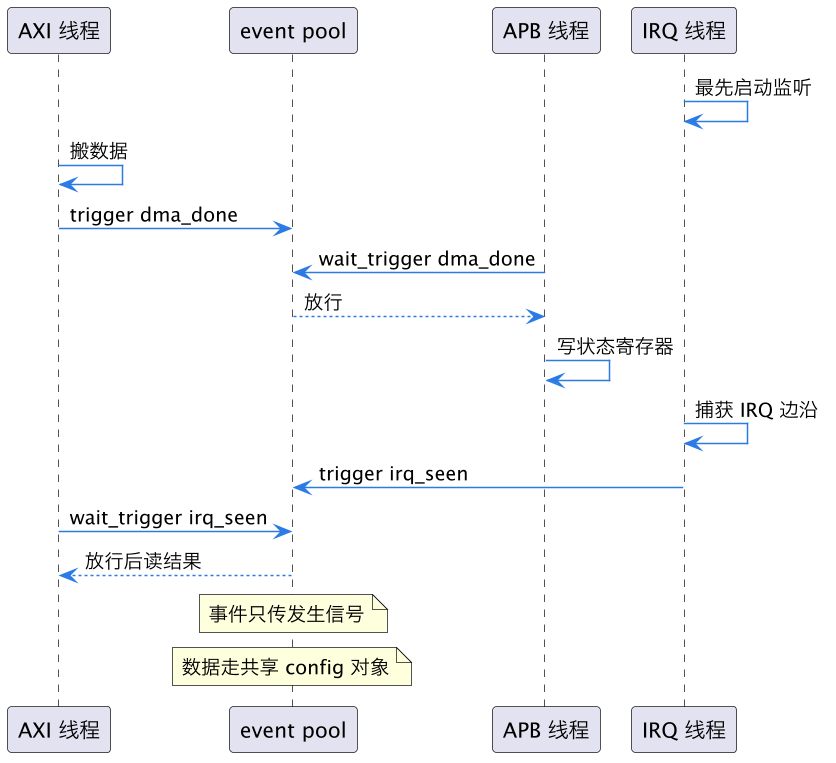
这张时序图把上面代码的握手链路画清楚了:IRQ 监听最先挂上,AXI 完成后经 event pool 放行 APB,IRQ 捕获边沿后再经 event pool 放行 AXI 的收尾读取。注意所有握手都经过 event pool 这个中立第三方,线程之间零直接引用——这正是协同可维护性的来源:哪个线程出问题,替换它不影响其他人。
三、相位对齐:objection 生命周期决定测试何时收场
多线程 fork 出来之后,第二个问题马上出现:测试什么时候算结束?UVM 的 run phase 靠 objection 计数——所有 objection 都 drop 了,phase 就结束。在协同场景里,如果 virtual sequence 的 body 里只在最外层 raise/drop 一对 objection,而某个 fork 线程还在等一个永远不会来的事件,结果是要么测试被 watchdog 强行杀掉,要么更糟——某个线程提前 return 导致 objection 计数归零,phase 在别的线程还没干完活时就收场了,后半段激励根本没打出去,scoreboard 却报了 PASS。
正确纪律有三条。第一,objection 只在最外层 virtual sequence 的 body 开头 raise、join 完成之后 drop,子线程内部不碰 objection——子线程的寿命由 fork/join 结构本身约束,join 不返回 body 就不会走到 drop。第二,给每个等待型线程配超时兜底:fork ... join_any 套一层 watchdog 线程,或者用 uvm_timeout 加相对超时,等待事件超过阈值就报 uvm_error 主动失败,而不是让测试 hang 到全局超时。hang 住再被杀的测试,日志停在最后一刻,你分不清是事件没来还是事件来了没被等到;主动超时的测试,错误信息直接指到等待点。第三,涉及 phase jump 或多 domain phase 的复杂环境(参考 UVM domain phase jump),协同 sequence 的 objection 必须 raise 在正确的 phase 实例上,否则 domain 之间的 phase 进度不一致时 objection 管不住别的 domain。
上图是 objection 生命周期的标准结构:raise 和 drop 夹住整个 fork/join 区间,watchdog 与业务线程并行、用 join_any 保证「要么全部完成、要么超时炸掉」,任何一种结局都会在有限时间内走到 drop。这个结构看一眼平淡无奇,但项目里一半的「测试偶发 hang 两小时」事故,根因都是缺了 watchdog 那条支路。
四、资源互斥:lock/grab 与软件互斥的分工
协同的第三类问题:多个 sequence 要抢同一个东西。UVM 在 sequencer 层面内置了两种互斥原语,lock() 和 grab(),站内的 sequencer lock/grab 独占 和 sequencer 仲裁机制 已经把语义讲透了,这里只给协同视角的选型结论:grab 插到仲裁队列最前面、抢到后独占直到 ungrab,适合「我这笔操作必须立刻、连续地独占总线」的硬实时场景(比如读-改-写不能被插入其他事务);lock 排队等待、抢到后独占,适合「可以等,但轮到我了就要完整做完」的场景。协同场景里默认用 lock 不用 grab——grab 的插队语义会破坏你精心编排的事件顺序,两个线程互相 grab 同一个 sequencer 还会死锁(A grab 住等事件,事件的生产者 B 也在等同一个 sequencer 的 grab)。
更要小心的是 sequencer 之外的共享资源:同一个寄存器块的前后门访问、同一块内存模型的地址区间、同一个 scoreboard 的期望队列。这些没有硬件仲裁,只能靠软件互斥。标准做法是在 env 或 config 对象里放一个 semaphore(SystemVerilog 内建类),所有访问方先 get(1) 再访问、用完 put(1)。比 semaphore 更工程化的做法是把共享资源包成一个带锁的小 utility 类,访问函数内部自己拿锁放锁,调用方无感——调用方要记得拿锁的协议,早晚会有人忘。
互斥还有一个和事件握手叠加时的隐蔽陷阱:持锁等事件。假设线程 A 对 APB sequencer 加了 lock,然后在锁内等待「DMA 完成」事件,而 DMA 完成信号的产生恰好需要线程 B 先用同一个 APB sequencer 发一笔配置——A 持锁等 B,B 等锁,死锁成型,而且日志里双方都停在「合理」的等待点上,极难看穿。纪律只有一句话:锁内不等待外部事件,事件等齐再进锁。把临界区压缩到最小——拿锁、发 item、解锁,所有握手逻辑放在锁外完成。这条纪律和数据库编程里「持锁不调用外部回调」是同一个道理,顺序上永远是「先协同、后互斥」,不能反过来。
| 互斥机制 | 作用域 | 插队能力 | 协同场景建议 |
|---|---|---|---|
grab() | 单个 sequencer | 有,插到队首 | 避免用,易死锁 |
lock() | 单个 sequencer | 无,排队 | 默认选择 |
| semaphore | 任意共享对象 | 无 | 寄存器/内存模型互斥 |
| 封装 utility 类 | 任意共享对象 | 无 | 大团队首选,防遗忘 |
五、协同失效的排查顺序
协同场景挂了,表现无非两种:hang(某处 wait 永远不满足)或时序错乱(事件都发生了但顺序不对)。排查按固定顺序走,不要上来就加打印。第一步,看 objection 和 phase:测试是 hang 在 run phase 还是被 watchdog 杀了?hang 的话 dump 一下各线程状态,找到卡在哪个 wait。第二步,检查事件配对:把 ep.get("xxx") 的所有调用点列出来,trigger 和 wait 的名字逐字符比对——字符串多一个下划线就是两个不同的事件对象,wait 方永远等不到。这是协同 bug 的第一大户,建议在 event pool 之上包一层类型安全的常量类,事件名全部用 const string 引用。第三步,检查 wait/trigger 时序:trigger 是否先于 wait 发生?需要的话换 wait_ptrigger 或加 reset。第四步,查互斥死锁:所有 lock/grab/semaphore 的获取顺序画出来,看是否存在环路(A 持锁 1 等锁 2,B 持锁 2 等锁 1)。第五步,才轮到看波形——前四步覆盖八成以上的协同 bug,而且全部可以在日志和代码层面完成,不用开仿真器。
这张流程图就是上面五步的顺序:objection、事件名、时序、死锁环、波形。顺序背后的逻辑是「检查成本递增、命中率递减」——越靠前的步骤越便宜,而绝大多数协同 bug 恰恰住在便宜的那几层。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下 UVM 激励线的一篇 S 层深文,主关键词 virtual sequencer 协同。向上承接 UVM virtual sequence 启动方式(virtual sequence 的结构与挂法)和 UVM 分层 sequence 堆叠(协议分层的 sequence 组织),把「多 agent 拉起来之后怎么保证时序确定」这个空白补齐。横向与 UVM event pool 与 barrier(事件机制本身)、sequencer lock/grab 独占(互斥原语语义)、sequencer 仲裁机制(仲裁算法)互为补充——那几篇讲单个机制,本文讲机制在协同场景里的组合用法与选型纪律。向下,objection 生命周期纪律可延伸到 UVM phase objection 结束控制,watchdog 兜底思路与 UVM heartbeat watchdog 一脉相承。
总结
virtual sequencer 协同的本质是把多 agent 激励从「自由跑靠运气」升级为「事件握手定先后、objection 管生命周期、互斥原语保共享资源」的确定性编排:握手用全局 event pool 配名字常量类(wait 之前确认监听者已挂上、分清 wait_trigger 与 wait_ptrigger),相位上 objection 只在最外层 raise/drop 并给每个等待线程配 watchdog 超时兜底,互斥上 sequencer 默认用 lock 不用 grab、寄存器和内存模型用 semaphore 或封装 utility 类,排查时按「objection 状态 → 事件名比对 → wait/trigger 时序 → 锁环检查 → 波形」的顺序由便宜到贵逐层推进——协同场景的价值不在激励多花哨,而在时序可复现,而可复现的全部秘密就是把每一次等待都写明白等的是谁、等不到怎么办。