AXI outstanding 信用:信用池管理、反压传播与 QoS 联动实战
更新时间:2026-09-28。本篇是「集成电路大类 · 芯片设计 · 片上总线」序列里的进阶篇。outstanding 与 ID 乱序语义先读 AXI4 outstanding 与 ID 乱序,QoS 字段本身见 AXI4 QoS 服务质量,五通道握手基础见 AXI4 完整协议。本篇把视角从「协议允许什么」移到「工程上必须保证什么」:互联和 slave 的 buffer 深度有限,master 到底被允许在途多少笔、谁计数、反压怎么往回传、高优先级流量怎么插队。
本文要回答的问题
- AXI outstanding 信用到底是什么,它和控制反压的 valid/ready 握手差在哪一层?
- 信用池怎么发放与回收,AW/AR 侧和 W 数据侧的计数口径为何不同?
- 互联内部的 buffer 为什么会溢出,信用上限如何按深度与延迟乘积来定?
- 反压如何从下游 slave 逐级回传到上游 master,中途会不会丢请求?
- 信用配额与 AXI QoS 怎么联动,才能让高优先级流量不被普通流量饿死?
一、outstanding 信用是什么:事务层配额,不是握手信号
AXI 的 valid/ready 握手管的是「这一个拍能不能送出去」,属于通道层的流控;AXI outstanding 信用管的是「我一共可以有多少笔请求在路上还没收到响应」,属于事务层的流控。两者叠加工作:握手保证拍级不丢数据,信用保证笔级不撑爆 buffer。
一笔 outstanding 事务的生命周期是:master 在 AW/AR 上发请求、计数器加一;读到 RLAST 或收到 B 响应、计数器减一。从发出到响应回来,中间隔了互联穿通延迟、slave 处理延迟、数据返回延迟,可能几十个时钟周期。如果 master 不加约束地发,下游每级 buffer 都要按最坏情况留深,面积与功耗直接失控。信用的本质就是把「允许在途的上限」变成一个可配置、可验证的参数,让 buffer 深度收敛到确定值。
图中那条注释是信用机制的落脚点:互联里每条通往 slave 的命令队列深度,必须不小于该 slave 方向上所有 master 信用之和。信用值是设计时定的,buffer 深度是按信用值配的,二者是一对参数而不是两个独立选择。
信用还有一层常被忽略的含义:它是 master 侧的「自我约束」。AXI 协议本身不规定 master 最多发几笔,但每一个真实 master IP(CPU、DMA、GPU 命令引擎)都有自己的 outstanding 上限,slave 侧验证模型必须按这个上限造激励,才能把互联打满。
二、信用池怎么管:AW/AR 计数与 W 通道信用
读方向信用比较直观:AR 通道每发一笔占一个信用,RLAST 到达归还。写方向要小心——AW 请求信用和 W 数据信用是两条账。AW 发出后 slave 知道了「有一笔写要来」,但写数据什么时候到不保证(AXI4 起 W 与 AW 之间无顺序约束,只要求同一笔内部 beat 顺序)。如果 slave 的写数据 buffer 很浅,互联就必须在 W 通道上单独做反压:WREADY 拉低让 master 攒着,直到下游有空位。
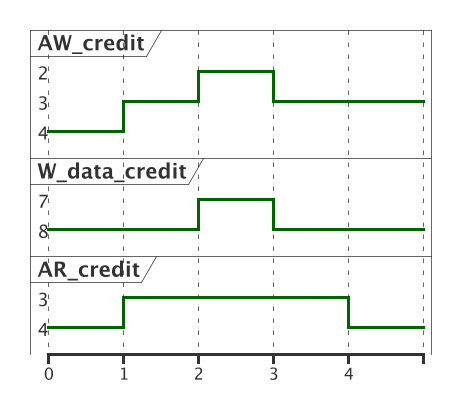
读图:拍 1 同时发出一笔 AW 和一笔 AR,两条账各减一;拍 2 又发一笔 AW,同时 W 通道推出去一拍数据,写数据信用跟着减;拍 3 收到一个 B 响应,AW 信用归还(写数据 buffer 也随最后一拍 W 被消费而释放);拍 4 一笔读走到 RLAST,AR 信用归还。两本账不同步回收,这正是写路径比读路径更容易在验证里漏 cover 的原因。
| 计数对象 | 发放时机 | 回收时机 | 关联资源 |
|---|---|---|---|
| AW 请求信用 | AW 握手完成 | B 响应握手完成 | slave 写命令队列 |
| W 数据信用 | W beat 被下游接收 | 写数据写入存储/转交 | 写数据 buffer |
| AR 请求信用 | AR 握手完成 | 该 ID 的 RLAST 握手 | slave 读命令队列 |
| R 数据缓冲 | 由 slave 侧 buffer 决定 | master 收走 R beat | 读返回 buffer |
一个高频 bug 是把 B 提前当回收点:master 侧一收到 B 立刻释放信用是协议允许的,但互联内部的 W buffer 可能还没排空——如果同一 ID 的下一笔写立刻复用信用冲下来,旧的 W beat 与新 AW 在互联里错位,典型现象是数据被写到错误的地址。稳妥做法是互联在「B 已返且对应 W buffer 真正清空」双条件满足后再给上游放额度。
三、信用上限怎么定:带宽延迟积与 buffer 深度
信用上限不是拍脑袋。理论下限来自带宽延迟积(bandwidth-delay product,BDP):为了打满链路,在途事务数据量必须 ≥ 往返延迟 × 目标带宽。举例:目标读带宽 32 GB/s,从 AR 发出到 R 数据回来的往返是 200 ns,每个 outstanding 读是 64 字节 cache line,那么需要 32e9 × 200e-9 ÷ 64 = 100 笔 outstanding 才能打满。信用给 32 笔,实际带宽就只有三分之一。
上图把定参过程压成一个闭环:BDP 给下限,成本给上限,buffer 深度跟着信用走。工程上常见的落地值:CPU 簇出口 16~64 笔,DMA 引擎 8~32 笔,显示控制器按行缓冲节奏配 4~16 笔。配小了带宽打不满,配大了互联和 slave 的存储资源白占面积,而且对时序收敛没有任何好处——深 FIFO 的读写指针比较逻辑本身就是关键路径常客。
还有一个常被拿来质疑的点:既然 BDP 能算,为什么不直接按最坏情况给足?原因是 BDP 的「往返延迟」本身是负载相关量——低负载下 200 ns 的往返,在互联拥塞时可能涨到 600 ns,按峰值延迟配信用会让 buffer 深度翻三倍,而 99% 的时间里这些深度用不上。务实做法是按典型负载配到能覆盖 95% 以上工况的额度,再用 QoS 和反压兜底尾部场景;性能仿真里把「信用耗尽停顿拍数占比」作为一个常看的统计量,超过 5% 就说明额度配紧了。
还有一个维度是 per-ID 与全局的拆分。AXI 允许同 ID 保序、跨 ID 乱序(细节见 AXI4 outstanding 与 ID 乱序),所以信用往往是「全局 32 笔 + 单 ID 最多 8 笔」的双层配额。只配全局不限单 ID,一个发同 ID 洪峰的 master 会把保序队列堵死,连带拖垮共享同一物理通道的其他 ID。
四、反压怎么传播:从 slave 一路回堵到 master
信用耗尽之后会发生什么?master 侧的逻辑很简单:没信用就不拉高 AW/AR 的 valid。但反压不是只发生在 master 一处,它沿着互联逐级回传,每一级都有自己的队列和门限。
传播链条是 slave 满 → 输出级 FIFO 堆高 → 交叉开关停派该方向 → 输入级堆高 → master 侧 ready 拉低。这里的关键性质是每一级只反压、不丢弃:valid 一旦拉高,请求在 ready 变高之前必须原样保持,整条链上任何一拍都不允许丢请求——这是 valid/ready 握手与信用机制合起来保证的,验证时要对每一级都写「valid 拉起后信号稳定」的断言。
图里那条注释指向真实设计里最贵的一个坑:队头阻塞(head-of-line blocking,HOL)。如果输入级 FIFO 是单一队列、按 FIFO 顺序出队,那么排在「去满队列 slave」请求后面的「去空闲 slave」请求也被堵死。解法是做 per-slave 虚拟输出队列(VOQ),或者干脆按 slave 分输入队列;AXI crossbar 的商业 IP 大多内置 VOQ,自研互联如果省了它,在多主多从混流下吞吐会腰斩。互联内部数据通路的更多结构选项见 AXI 互联数据通路架构。
反压传播还有一个时序上的细节:ready 拉低是组合路径还是寄存一拍?跨时钟域或多级流水里,「本拍发现满、下一拍才反压」意味着上游还会送一拍数据进来,FIFO 必须为此留一拍余量(skid buffer 或 almost-full 提前量)。AXI-Stream 侧同类问题的拍级分析可对照 AXI-Stream 反压时序,思想完全一致:反压永远要提前于真正溢出。
五、信用与 QoS 联动:高优先级怎么插队
AXI4 的 AxQoS 字段本身只是 4 bit 标签,协议不规定它怎么被用——真正生效靠互联仲裁器把 QoS 翻译成调度和信用分配策略。没有联动时,一个按带宽猛发普通优先级流量的 master 会占满共享 egress FIFO,高优先级请求排在其后,延迟被普通流量决定。
读图:请求按 QoS 分流进两条队列,高优先级队列有预留信用(比如总额度 32 里硬保 8 个给 QoS≥12),普通流量共享剩余池;仲裁严格先看高优先级队列,但带一个加权兜底计数器,防止普通流量被永久饿死。这套「分流队列 + 配额预留 + 兜底仲裁」是 QoS 落地的最小可用组合,QoS 字段语义本身见 AXI4 QoS 服务质量。
落地时有三个工程判断点。其一,QoS 是「提示」不是「契约」,slave 和互联可以部分实现,验证时不能假设 QoS 高就一定先完成,只能验证统计意义上的延迟上界。其二,信用预留要防「高优先级洪峰反过来打爆自己」——预留配额之外,高优先级流量也应允许借普通池的空闲额度,否则正常工况下总利用率被拉低。其三,动态 QoS(master 根据内部积压实时抬升 QoS)要小心抖动:QoS 频繁升降会让仲裁结果不稳定,常见做法是加迟滞,QoS 上调立即生效、下调延迟若干拍。NoC 级更系统的流量分级方案见 片上网络 NoC 路由器。
六、验证要点:把「不溢出、不丢、不饿」写成断言
信用机制的正确性最终要落到可执行的检查上。验证环境至少要覆盖四类性质:不溢出(任何时刻在途数 ≤ 信用上限)、不丢失(发出的每笔最终都有响应,计数守恒)、不错配(响应 ID 与请求 ID 对得上)、不饿死(任何 master 的请求在有限拍内获得 grant)。
| 检查性质 | 推荐手段 | 典型 bug |
|---|---|---|
| 不溢出 | SVA 断言:inflight ≤ credit_max | 回收点算错,超发 1 笔 |
| 计数守恒 | scoreboard 配对 AW/AR 与 B/RLAST | 乱序下按序配对错位 |
| 不错配 | ID 追踪表 + 交叉比对 | per-ID 队列指针回卷 |
| 不饿死 | 覆盖:最长等待拍数 < 门限 | 严格优先无兜底 |
| 反压稳定 | SVA:valid&& !ready ⇒ 下拍信号不变 | ready 拉低时改地址 |
per-ID 与全局两层配额、W 与 AW 两本账、QoS 分流三条路径,两两组合就是验证空间的骨架,covergroup 至少要采到「全局满但单 ID 未满」「单 ID 满但全局未满」「高低 QoS 同时竞争」这几个交叉仓。SVA 的挂接与覆盖率组织方法见 SVA bind 与覆盖收集。
激励侧也要配合:只用「匀速发流」的测试平台永远打不出信用耗尽的边界。有效做法是三类激励轮换——洪峰激励(背靠背发到额度顶满,观察回收与再发放是否准确)、毛刺激励(响应延迟随机拉长,制造反压传播中途的 valid/ready 拉扯)、混流激励(多个 master 以不同 QoS、不同突发长度并发,逼近 HOL 与饿死的边界)。每一类激励都要配对应的计数器镜像模型,testbench 自己维护一份「应该在途几笔」的影子账,与 RTL 的内部计数实时对拍,差一立刻报错——只靠最终 scoreboard 对账,定位「哪一拍多发了一笔」要翻几百拍波形,成本天差地别。
这一篇在知识体系里的位置
outstanding 的协议语义根基是 AXI4 outstanding 与 ID 乱序;QoS 字段与典型仲裁策略见 AXI4 QoS 服务质量;互联如何承载这些信用与反压,结构面看 AXI crossbar 互联 和 AXI 互联数据通路架构;单笔事务从发起到完结的全程对照 AXI4 事务全生命周期。
总结
AXI outstanding 信用是事务层的配额机制:master 每发一笔 AW/AR 占一个信用、收到 B/RLAST 归还,写方向还要给 W 数据单独记一本账;信用上限由带宽延迟积定下限、由 buffer 成本压上限,互联每条命令队列的深度必须兜住信用之和;信用耗尽后反压沿「slave→输出级→交叉开关→输入级→master」逐级回传且全程不丢请求,多主场景要靠 VOQ 防队头阻塞;再叠加 QoS 分流队列、预留配额与兜底仲裁,才能在打满带宽的同时给高优先级流量保住延迟上界——验证的落脚点就是「不溢出、不丢失、不错配、不饿死」四条性质全部写成断言与覆盖。