UVM heartbeat 心跳:注册 objection 活动、卡死检测与超时退出
更新时间:2026-09-28。UVM phase 与 objection:测试如何体面地结束 讲了 objection 机制怎么决定仿真何时收尾;这一篇讲它的另一面——objection 的提起记录还可以当作「生命体征」被监视,用来回答一个更棘手的问题:仿真没结束,但它是不是已经死了?
本文要回答的问题
- 长时间跑不完也不报错的仿真,怎么区分「还在正常干活」和「已经死锁」?
uvm_heartbeat到底监视什么信号?为什么说它监视的是 objection 活动而不是某个信号跳变?HBFAIL报出来之后,往哪个方向查?心跳误报又怎么防?
一、问题:挂起的仿真是最难排查的失败
回归里最折磨人的失败不是 UVM_ERROR,而是仿真既不退也不动:日志停在某一刻,CPU 占用可能还是 100%(某个 forever 循环在空转),你分不清它是快好了还是早就死了。常见根因集中在几处:
| 卡死形态 | 典型根因 |
|---|---|
| objection 永不落下 | sequence 里 raise_objection 后某条路径漏了 drop_objection |
| driver 永久等待 | get_next_item 等不到 item(sequencer 死锁 / sequence 没启动) |
| 握手互等 | DUT 等 valid、TB 等 ready,两边都在等对方先动 |
| phase 不跳转 | 某组件的 phase task 里死循环,没 yield 也没返回 |
这些场景靠 +UVM_MAX_QUIT_COUNT 或全局 timeout 都抓不准:前者只管错误计数,后者只能一刀切——一个正常要跑 8 小时的 case,timeout 设 9 小时就浪费 9 小时才发现异常。UVM heartbeat 心跳解决的就是这个「一刀切」问题:不看仿真跑了多久,看它这段时间里有没有生命迹象。
二、uvm_heartbeat 监视什么:objection 活动即脉搏
UVM 库里自带 uvm_heartbeat 组件,思路是:一个活着的 testbench,各组件必然在不断地提起/落下 objection(每发一笔事务、每进一个 phase task 都可能伴随 objection 活动)。如果监视窗口内所有被注册的组件一次 objection 都没提起过,大概率就是卡死了。
用法分三步:拿句柄、设监视的 objection 对象、把要监视的组件加进来:
class base_test extends uvm_test;
  uvm_heartbeat hb;

  virtual function void build_phase(uvm_phase phase);
    super.build_phase(phase);
    hb = uvm_heartbeat::type_id::create("hb", this);
    // 监视 run_phase 的 objection
    hb.set_heartbeat(uvm_test_done, env);
    // 把 env 下所有组件注册进监视列表
    uvm_component comps[$];
    env.get_children(comps);
    ...
  endfunction

  virtual task run_phase(uvm_phase phase);
    uvm_objection hb_obj = phase.get_objection();
    hb.set_mode(UVM_ALL_ACTIVE);   // 所有组件都必须有活动
    hb.start(hb_obj);              // 开始跳
    ...
  endtask
endclass
这里有几个容易混淆的点需要掰开:
- 它监视的是「提起 objection」这个事件,不是 objection 的计数值。 一个组件
raise一次之后挂在那里不落,心跳照样认为它活着——因为心跳复位条件是「观察到一次 raise 活动」。所以心跳抓的是「完全无活动」的死锁,抓不到「raise 了忘 drop」那类挂起(那类靠 objection trace 查,见文末链接)。 set_heartbeat的第一个参数是 objection 对象本身,通常就是 phase 的phase.get_objection(),表示「监视挂在这个 objection 上的活动」。- 注册的组件集合决定监视粒度。只注册 driver,monitor 死掉不会被发现;通常把 env 下所有 active 组件都加进来。
再补两条注册语义上的细节。第一,注册进心跳的组件应当是确实会周期性提起 objection 的 active 组件:driver、跑着实 scoreboard 比对 loop 的组件都行;一个纯被动的 monitor 如果从不 raise objection,把它塞进 UVM_ALL_ACTIVE 的名单只会制造误报——它不是死了,是本来就不该有活动。第二,多个组件注册进同一个 heartbeat 时,窗口是共享的:在 UVM_ALL_ACTIVE 下窗口的复位条件变成「名单里每个组件都至少 raise 过一次」,任何一个组件静默超时都会拖垮整个窗口并触发 HBFAIL;而 UVM_ANY_ACTIVE 则退化成「大家轮流保命」,名单里最活跃的那个组件会一直复位窗口,反而可能掩盖另一个组件的死亡。所以组件活动模式差异大的环境,与其一锅端注册,不如按角色拆成两三个 heartbeat 各管一摊。
三、心跳检测时序
下面这张图把一个典型的心跳窗口画出来:组件正常活动时 heartbeat 不断复位,静默超过窗口就触发 HBFAIL。
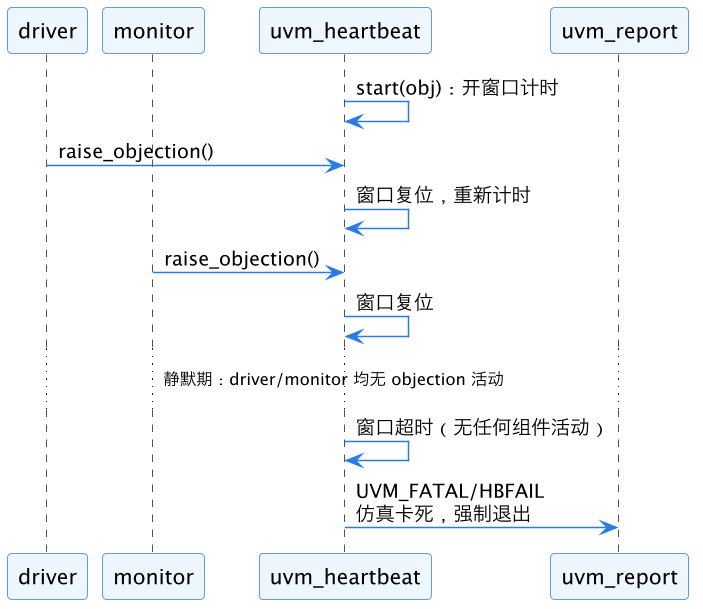
读图抓两点。第一,任何一个被监视组件的活动都会复位窗口(默认 UVM_ALL_ACTIVE 模式下其实要求所有组件都活动,这里是 UVM_ANY_ACTIVE 的行为;两种模式的差别就在「任何一个动就算活」还是「每个都必须动过」)。第二,HBFAIL 一旦发生就是 fatal 级,仿真直接结束——所以心跳窗口长度要大于正常业务的最长静默期,否则就是误报。
三种模式的语义对照:
| 模式 | 复位条件 | 适用场景 |
|---|---|---|
UVM_ALL_ACTIVE | 窗口内每个注册组件都要有过 raise | 所有组件都应周期性活动的常规 testbench |
UVM_ANY_ACTIVE | 任一组件有 raise 即复位 | 组件角色不对称,有的可能长时间静默 |
UVM_ONE_ACTIVE | 只盯指定的那一个组件 | 已知关键路径组件(如主 driver) |
四、误报与漏报的工程纪律
心跳机制简单,但用不好两头受罪:窗口太短满屏误报,窗口太长又退化成了 timeout。几条来自回归实践的经验:
为什么不手写看门狗线程。 没有 uvm_heartbeat 之前,常见做法是 fork 一个超时线程、主线程完成后 disable fork,或者自己起个 forever #(T) 循环检查某个计数器。两条路线对照:
| 维度 | 手工 fork 看门狗 | uvm_heartbeat |
|---|---|---|
| 监视信号 | 自定义(某个计数器/事件) | objection 提起活动,免插桩 |
| 覆盖粒度 | 通常只盯一条主线程 | 可注册任意组件集合 |
| 误报控制 | 全靠手写复位逻辑,易漏路径 | 三种模式内建,语义明确 |
| 失败现场 | 只知道自己超时了 | fatal 自带 objection 状态 |
| 维护成本 | 每个 test 抄一遍,易漂移 | 库组件,行为统一 |
手工方案最大的坑不是写起来麻烦,而是复位条件散落在业务代码里:每条可能的活动路径都要记得「喂狗」,加一条新路径忘了喂,就是一个潜伏的误报源。uvm_heartbeat 把「活着」的定义收敛到 objection 活动这一个可观测事件上,业务代码零改动,这是它真正的价值。
窗口长度按「最长合法静默期」设。 比如 DUT 有一个耗时 200us 的配置阶段,期间 driver 不发任何事务,那心跳窗口就得大于 200us 加裕量。窗口本身通过 objection 的 set_drain_time 或仿真器侧配合控制,具体以所用 UVM 版本的实现为准——读一遍你库里 uvm_heartbeat 的源码比猜文档靠谱,它只有百来行。
测试收尾阶段要主动停心跳。 phase 正常跳转、组件陆续 drop_objection 之后,testbench 进入合法的「无活动」状态,心跳还开着就会在 drain 阶段误炸。纪律是:hb.stop() 放在你确认主业务完成之后,或者干脆只在 run_phase 主体期间开启。
HBFAIL 之后怎么查。 fatal 消息里带当时各组件的 objection 状态。顺着两条线走:一看哪个组件最后有活动、卡在哪次握手(配合 UVM report 与 verbosity 控制 里讲的分级带时间戳日志,定位最后一次打印的时间点);二看 objection 计数残留,谁 raise 了没 drop——这正是 UVM phase 与 objection:测试如何体面地结束 里 objection trace 的用武之地。心跳负责「发现死了」,objection trace 负责「查明怎么死的」,两者是搭档不是替代。
回归层面的配合。 心跳把「挂死」从「无限等待」变成「带现场信息的 fatal」,这对批量回归价值最大:挂死的 case 快速失败、释放 license 和机器,失败原因在 回归管理与失败分类 里单独归一档,和真正的功能错误分开统计——挂死率本身(而不是具体某个 bug)往往是环境稳定性的先行指标。
这一篇在知识体系里的位置
- 机制上游:UVM phase 与 objection:测试如何体面地结束 讲 objection 的 raise/drop 与 drain,心跳监视的正是这套机制的活动面。
- 排障下游:回归管理与失败分类 讲 HBFAIL 这类「环境性失败」如何与功能 bug 分桶统计。
- 日志配合:定位挂死现场依赖带时间戳的分级日志,见 UVM report 与 verbosity 控制。
总结
UVM heartbeat 心跳把「仿真是否还活着」这个判断从「跑了多久」改成「这段时间里被监视的组件有没有提起过 objection」:注册组件、选好 UVM_ALL_ACTIVE/UVM_ANY_ACTIVE 模式、按最长合法静默期定窗口,卡死的仿真就会在 HBFAIL 中带着 objection 现场快速失败;收尾记得 stop(),否则合法的空转期会被误判成死亡。