寄存器模型自动生成:从 IP-XACT/spec 经 ralgen 生成 uvm_reg_block 的工程流、模板定制与增量更新
更新时间:2026-10-03。一个中等规模 SoC 的寄存器数量轻松过万,字段数量翻几倍。如果 UVM 环境里的寄存器模型(RAL,Register Abstraction Layer)靠手工一行行写
uvm_reg_field,不仅写到怀疑人生,更致命的是它和 RTL 实现一定会漂移——设计改了地址 map,验证模型没跟上,寄存器测试在错误的地址上读写,报出来的 bug 全是假警报。行业里对这个问题的标准答案是寄存器模型自动生成:维护一份机器可读的寄存器 spec(IP-XACT 或自家表格),用 ralgen 类生成器一键产出 uvm_reg_block 代码。本站的 UVM 寄存器验证方法论 讲了寄存器验证的整体策略,uvm_reg_block map 结构 讲了生成产物的目标结构,RAL frontdoor backdoor 讲了模型生成之后怎么访问。这一篇把上游那一环——spec 怎么管、生成器怎么跑、模板怎么改、增量更新和手工 patch 怎么共存——讲成一条可落地的工程流水线。
本文要回答的问题
- 寄存器模型自动生成的完整数据流长什么样,每一段的输入输出是什么?
- 输入 spec 选 IP-XACT 还是自家表格,spec 本身的版本治理怎么做?
- 生成器的输出模板为什么要定制,定制哪些点才不踩坑?
- RTL 寄存器频繁变更时,增量更新怎么做到「只重生变化的块」而不冲掉手工成果?
- 生成代码里那些工具表达不了的特殊语义,手工 patch 怎么和自动再生成长期共存?
一、完整数据流:从 spec 到 uvm_reg_block 的四段流水线
寄存器模型自动生成不是「一个工具吃一份文件吐一份代码」那么简单,真实项目里它是一条四段流水线:spec 源 → 中间格式 → 生成器 → 产物入库。每一段都有独立的 owner 和独立的失效模式。
第一段是 spec 源。寄存器的事实源头通常在设计团队手里,形态千奇百怪:Word 文档里的地址表、Excel 表格、IP-XACT 1685 标准的 XML、或者 SystemRDL 源码。这一段的核心原则是单一数据源(single source of truth)——整个公司必须只有一份文件被认定为「寄存器事实」,文档、头文件、RAL 模型、测试激励全部从它派生。凡是「RTL 工程师改代码、验证工程师改模型、文档工程师改手册」三条线并行的团队,漂移只是时间问题。
第二段是中间格式。大多数团队会把五花八门的源格式统一转成一种中间表示(IR),比如先用脚本把 Excel 导出成 SystemRDL 或 IP-XACT,再喂给生成器。多这一层的好处是生成器只对接一种输入,前端格式随便换;坏处是转换脚本本身成了新的维护负担,Excel 里一个合并单元格就能让转换脚本崩掉。
第三段是生成器本体。Synopsys 的 ralgen(VCS 自带)、PeakRDL、开源的 reggen(OpenTitan 项目用的 hjson 流程)都是这一段的候选。生成器读入 IR,按内置或定制的模板展开成 SystemVerilog 类:uvm_reg_block 做容器,uvm_reg 表达寄存器,uvm_reg_field 表达字段,create_map 里铺地址映射。
第四段是产物入库与消费。生成的 .sv 文件编进验证环境的 package,被寄存器 sequence、adapter、predictor 消费。这一段的纪律是:生成产物要么入库受版本管理,要么构建期现生成,二选一,全团队统一,最忌一半人提交一半人不提交。
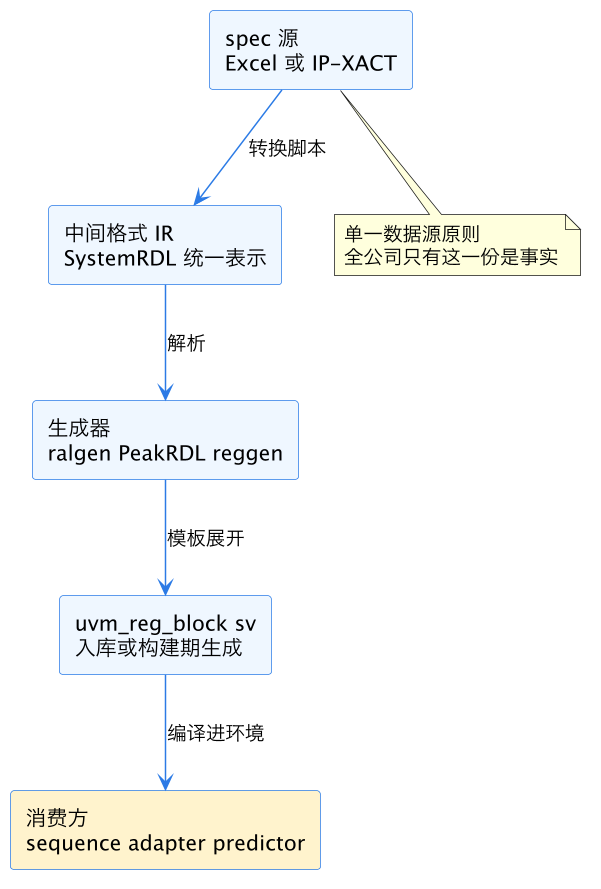
上图是整条流水线的骨架。注意箭头方向全部是单向的——任何一环被反向修改(比如直接改生成的 sv 文件而不改 spec),环路就断了,下一次再生成时修改被冲掉,漂移从这一刻开始。这条「单向性」是后面所有纪律的总纲。
二、输入 spec 的选择与治理:IP-XACT 不是银弹
选 spec 格式是整条流水线里最影响长远的决策。主流三个选项各有适用面。
IP-XACT(IEEE 1685)是行业标准,EDA 工具链支持最好,ralgen 直接吃,和 IP 打包、集成工具能联动。代价是 XML 极其冗长,一个寄存器几十个标签,人手几乎不可写,必须有 GUI 或脚本辅助;而且标准只覆盖常见语义,特殊字段行为(write-1-to-clear-set 混合、影子寄存器、间接寻址)要靠 vendor extension 表达,一扩展就丢了可移植性。
SystemRDL(Accellera 标准)是专门为寄存器描述设计的语言,可读性远好于 XML,信号 property 表达力强,PeakRDL 生态活跃。缺点是工具链不如 IP-XACT 全,商用仿真器不直接吃,需要先转。
自家表格(Excel 加转换脚本,或 OpenTitan 风格的 hjson)门槛最低,硬件工程师零学习成本,审查 diff 友好。代价是所有语义规则得自己在转换脚本里实现,团队规模一大脚本就腐化。
| 维度 | IP-XACT | SystemRDL | 自家表格 |
|---|---|---|---|
| EDA 工具支持 | 最好,ralgen 直连 | 需 PeakRDL 等桥 | 全靠自己脚本 |
| 人工可读可写 | 差,XML 冗长 | 好 | 最好 |
| 特殊语义表达 | vendor extension | property 丰富 | 随心所欲但易腐化 |
| 上手门槛 | 高 | 中 | 低 |
| 适合规模 | 大团队多 IP 复用 | 中大团队 | 小团队单项目 |
选完格式只是开始,spec 的治理才是日常。三条硬纪律:spec 进版本库,每次变更走评审(寄存器地址变更影响固件、驱动、验证三方,必须会签);spec 有 schema 校验,CI 里跑格式和语义检查(地址重叠、字段位宽溢出、保留位误用,这些错误在生成阶段才被发现就晚了);spec 的版本号和生成产物、RTL 版本三方对齐,环境编译时把 spec 版本号打进 log,回归报告里能反查「这次跑的是哪版寄存器定义」。
三、生成器怎么跑:ralgen 流程与模板定制点
以 ralgen 为例,基本调用一行命令:ralgen -t <top> -ipxact <file>.xml -gen_sv,输出一个或多个 ral_<block>.sv 文件,每个文件里是一个继承 uvm_reg_block 的类。命令本身没有技术含量,工程含量全在三个地方。
第一是顶层组织。SoC 级寄存器模型不是一个大 block 而是树:顶层 block 套子系统 block,子系统套 IP 实例,每个 IP 实例有自己的 address map。生成器按 IP-XACT 里的 memoryMap 层次递归展开。这里的坑是实例数组——同一个 IP 例化了四份(比如四路 UART),生成器会生成一个 block 类加四个实例,地址偏移在 build 时参数化。如果你的 spec 把四路写成了四份独立的 memoryMap,生成的模型就是四个不相干的类,共享测试代码全废。纪律:同构实例在 spec 里就必须表达成数组,不是复制粘贴。
第二是模板定制。所有主流生成器都支持模板覆盖:ralgen 有 -uvm 之外的自定义输出钩子,PeakRDL 直接开放 Jinja 模板,reggen 的模板就在仓库里。真实项目几乎必然要定制,常见的定制点有:给生成的 covergroup 加团队统一的 bin 风格(字段覆盖、读写方向交叉);给字段加团队扩展属性(比如安全等级、时钟域标注,驱动后门访问策略或 CDC 检查脚本);在 block 里插入项目专用的 hook 函数(比如上电后自动调一次的 init sequence 挂载点)。定制的纪律是「只加不改」——模板只插入新内容,绝不删除或改写生成器标准产出的结构,否则升级生成器版本时模板和标准输出的差异会让你无法对齐。
第三是生成参数的版本钉死。生成器本身有版本,同一个 spec 用不同版本生成器跑出来的代码可能不同(默认 reset 值表达、注释格式、甚至类命名)。回归可复现要求生成器版本和 spec 版本一起入库,CI 里跑「重新生成并对 diff 应为空」的一致性检查,diff 非空说明有人手改了产物或工具链漂移,直接拦下。
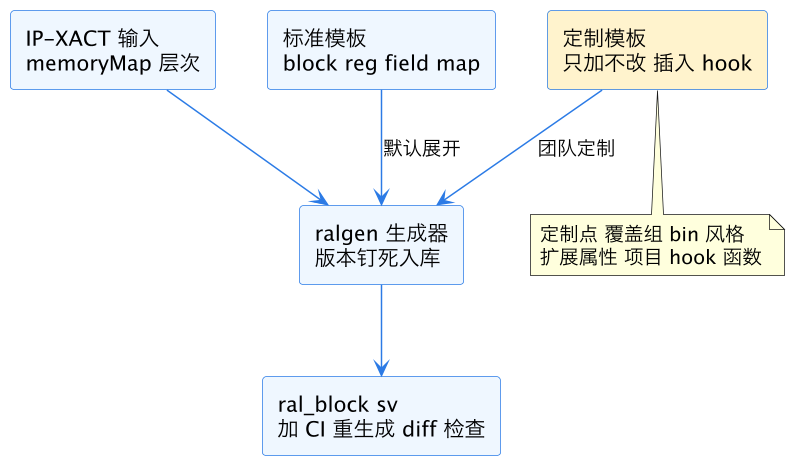
上图把模板定制画成和标准模板并列的输入:两者在生成器里汇合,定制模板负责注入团队基因,标准模板负责结构骨架。CI 里的「重生成 diff 为空」检查是这张图里看不见但最重要的一环——它保证了「生成物确实是生成出来的」这个基本事实。
四、增量更新:寄存器变更日常化之后怎么办
IP 开发期寄存器定义几乎每周都在变:加字段、改地址、删寄存器、改复位值。全量再生成一次只要几分钟,真正的成本不在生成,在「再生成冲掉了什么」和「下游什么需要跟着动」。
增量更新的第一层是范围控制。SoC 级 spec 通常按 IP 拆文件,生成也按 IP 拆输出,改一个 IP 只重新生成它对应的 block 文件。这要求生成产物按 IP 分文件组织(ralgen 默认就是),并且文件之间没有手工建立的交叉引用。如果某个 sequence 直接引用了别的 IP block 的内部路径(top.ral.uart0.ctrl 写死在激励里),那是使用方的问题,不是生成的问题,但再生成会把这种隐性耦合炸出来——所以环境代码访问寄存器一律走句柄传递或 config_db 查找,不硬编码层次路径。
第二层是变更影响评估。spec diff 出来三类变更,影响完全不同:纯新增(加寄存器、加字段)对现有环境零破坏,直接合入;语义变更(改字段宽度、改访问属性 RW 变 RO)可能让现有测试的写操作静默失效,必须把受影响的 sequence 清单拉出来过一遍;结构性变更(改地址、删寄存器、移动 block)是破坏性变更,所有引用旧地址的代码编译即错,反而是最安全的——编译器帮你找全了。最危险的是语义变更里的「复位值改变」:编译不错、运行不报错,只是 mirror 比对开始莫名其妙 fail。uvm_reg desired mirror 语义 讲的镜像比对机制正是这类问题的第一现场。
第三层是再生成节奏。两种流派:随 spec 提交自动再生成(CI 里 spec 一改产物就更新,产物不入库只入构建缓存),或者定期手工再生成走评审(产物入库,diff 走代码评审)。前者保证新鲜度但环境代码可能因为产物突变而编译失败,适合环境代码也高度自动化的团队;后者可控性好,产物 diff 直接出现在评审里,验证 lead 能看到「这次寄存器变了什么」,大多数团队选后者。
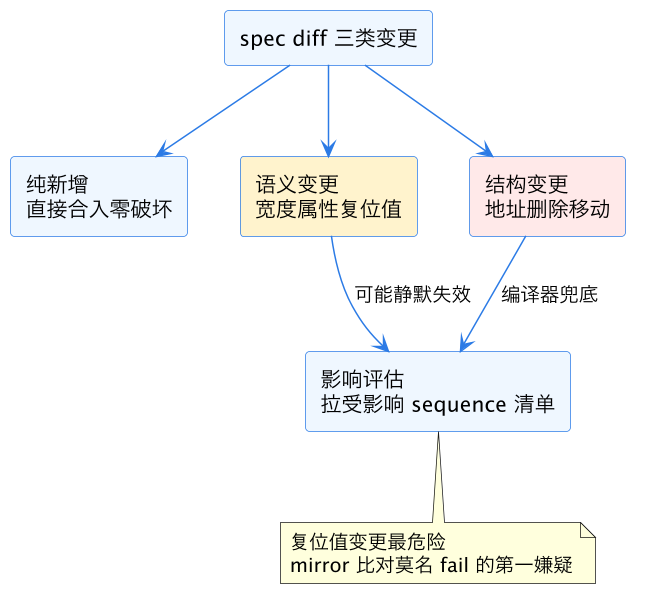
这张图是按危险程度给变更分类的决策图。纯新增走绿色通道,结构变更靠编译器兜底,唯独语义变更需要人工介入——它介于「肯定没事」和「肯定报错」之间的灰色地带,是增量更新流程里唯一必须配 checklist 的分支。
五、手工 patch 的协作:生成物表达不了的语义放哪里
不管生成器多强,总有一部分寄存器语义它表达不了:跨字段联动的写副作用(写 A 字段会清 B 字段)、需要特殊时序的间接寻址(先写索引寄存器再读写数据窗口)、安全寄存器的权限依赖(只有 secure world 能写)、以及覆盖率模型里那些和验证计划挂钩的定制 covergroup。这些东西怎么和自动再生成共存,是这个工程流里最考验纪律的部分。
行业里沉淀下来的做法是分层放置,按「侵入性」从低到高四档。第一档,回调扩展:生成器生成的 block 类里实例化的 reg 对象,在环境侧通过 UVM callback 挂上额外行为(uvm_reg_cbs 的 post_write 里实现联动清除)。一行生成代码不改,全部扩展活在环境文件里,再生成零冲突。这是首选,能走回调的绝不走后面的档。UVM callback 机制 讲了 callback 注册与执行的完整语义。
第二档,派生类替换:用 factory override 把某个特殊寄存器的类型替换成手写派生类,派生类里重写 predict 或 sample。生成物里只是 uvm_reg 变成了 my_special_reg,结构不变。代价是 override 配置必须在环境 build 早期完成,漏了就是静默用了基类。
第三档,生成后补丁脚本:再生成之后自动跑一个 patch 脚本,用 sed 或语法树工具往生成文件里注入片段。这一档已经很危险了——补丁和生成器版本强耦合,生成器输出格式一变补丁就落空,而且落空往往不报错。只在「生成器完全不支持且改动量大」时用,并且补丁脚本必须在 CI 里跑「应用后编译通过」的检查。
第四档,fork 生成物手工维护:把某个 block 的生成文件从自动生成清单里摘除,改由人工维护。这是最坏选项,等于宣布这个 block 退出单一数据源体系,从此靠人肉同步。只有 spec 语义确实超出 IR 表达力(比如高度动态的寄存器布局)时才接受,而且要在文件头上写清楚「本文件已 fork,同步责任人是谁」。
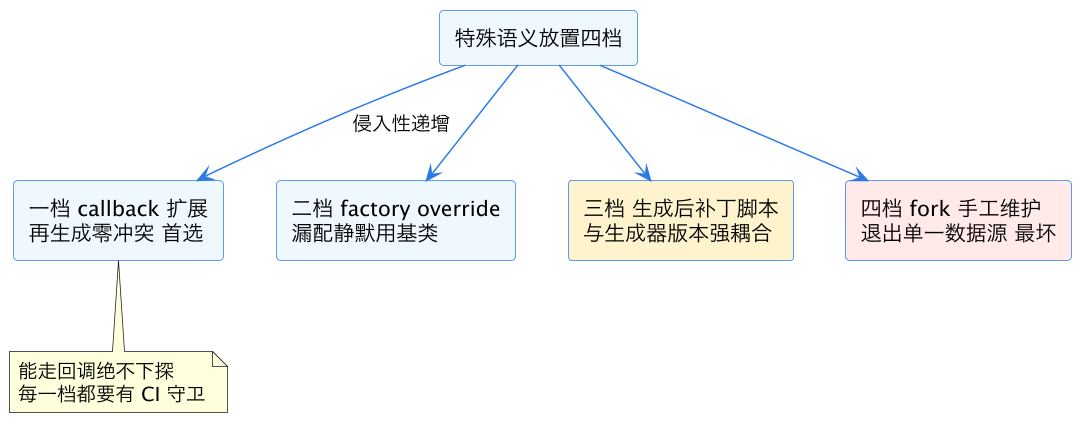
上图的四档从左到右侵入性递增、可维护性递减。选档的原则一句话:能用离生成物最远的方案解决,就绝不动生成物本身。每往下一档,都要问自己「生成器模板定制能不能把这个需求吃回去」——很多时候第三档第四档的需求,其实是第二节讲的模板定制没做到位。
六、落地清单:一条可照抄的流水线
把前五节揉成一份落地动作清单。初始化阶段:选 spec 格式并写 schema 校验脚本;定生成器版本并入库;搭「spec → IR → 生成 → 编译」的 CI 任务,产物按 IP 分文件;模板定制只做加法,把团队 covergroup 风格和扩展属性注入进去。日常运转阶段:寄存器变更一律改 spec 走评审;再生成随 spec 合并触发或按周跑批,spec diff 按纯新增、语义、结构三类出影响报告;语义变更必须有人工 checklist 过一遍受影响 sequence。质量守卫阶段:CI 跑重生成 diff 为空的检查;回归 log 里打印 spec 版本号;镜像比对 fail 的分诊流程里,「复位值是否刚变更」是固定排查项;每年盘点一次第三档第四档的存量,能回收的尽量用模板定制收回去。
这套流水线跑顺之后,寄存器模型的维护成本会从「一个人专职同步」降到「每周评审时顺带看一眼 diff」,而验证环境对寄存器定义的信任度——这才是自动生成真正的产出——会让所有寄存器相关 bug 的分诊时间缩短一个量级。
总结
寄存器模型自动生成的本质是用「单一 spec 数据源 + 单向生成流水线」消灭 RTL 与验证模型之间的漂移:选 IP-XACT、SystemRDL 或自家表格做唯一事实源并配 schema 校验,生成器版本钉死、模板定制只加不改,增量更新按「纯新增、语义变更、结构变更」三级分流(语义变更最危险、必须人工 checklist),生成物表达不了的特殊语义按 callback、factory override、补丁脚本、fork 四档放置、能用离生成物最远的方案绝不动生成物——流水线单向不破,模型就永远可信;任何一环被反向修改,漂移从那一刻开始。