PCIe 链路概念:lane、代际速率、LTSSM 训练与三层协议
显卡、NVMe 固态硬盘、网卡插在主板上,彼此之间最常见的高速通道就是 PCIe(Peripheral Component Interconnect Express,外围组件互连高速标准)。软件工程师日常只看到一组内存映射的寄存器和「x16」「Gen5」之类的规格字样,但这些字样背后是一套会自己训练、自己检错重传、自己协商宽度的串行链路。本篇建立PCIe 链路概念的完整直觉:物理上一条链路由什么构成,代际数字怎样换算成真实带宽,上电后链路怎样「自己接通」,协议为什么要分三层,以及这一切怎样导出软件看到的树形拓扑。芯片外部接口的物理背景可对照 IO 与焊盘,串行编码的一般原理可对照 曼彻斯特与 NRZI 编码。
本文要回答的问题
- 一条 PCIe 链路在物理上由什么组成,为什么说 lane 是收发分开的差分对?
- Gen1 的 2.5 GT/s 到 Gen6 的 64 GT/s 为什么不能直接除以 8 得到字节带宽,编码开销吃掉多少?
- 上电后没有软件参与,链路靠什么机制自动完成位对齐、通道反序纠正和宽度/速率协商?
- TLP、ACK/NAK、重传、信用流控分别处在哪一层,链路为什么对软件表现得像一条可靠管道?
- 既然每条连线都是点对点的,为什么操作系统枚举出来的却是一棵设备树?
一、链路的物理单位:lane 是两对差分线,收发各走各的
理解 PCIe 的第一个要点:它不是一条共享总线,而是一组点对点串行连接。最小单位叫 lane(通道)。一条 lane 在每个方向上各有一对低压差分信号线:发送端 TX 的正负两根线走一个方向,接收端 RX 的正负两根线走反方向。差分信号用两根线的电压差表示 0 和 1,对共模噪声不敏感,这是它能在几十 GHz 的翻转速率下仍保持低误码的物理基础。差分走线与阻抗控制属于信号完整性议题,可进一步阅读 封装与信号完整性。
因为收发各有独立的一对线,一条 lane 是全双工的:两个方向可以同时传数据,互不等待。这和老式并行总线(设备轮流驱动同一组线)有本质区别,也和半双工接口需要切换方向不同。芯片内部把并行数据转成高速串行比特流的电路叫 SerDes(Serializer/Deserializer,并串转换器),PCIe 的物理层本质上就是一组配对的 SerDes 加相应的时钟恢复与均衡电路。
一条「链路」(link)可以由 1、2、4、8、16 甚至 32 条 lane 并排构成,记作 x1、x4、x8、x16。多条 lane 并行传同一条数据流的不同字节,接收端再按训练时确定的 lane 编号重新拼装。注意 lane 数影响的是宽度(并发),代际影响的是每条 lane 的速率,两者相乘才是总带宽——x16 的 Gen3 与 x4 的 Gen5 量级相近,就是这个乘法的结果。
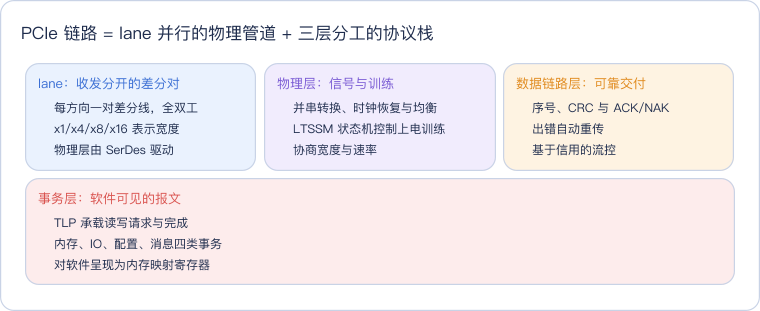
这张概念卡给出全篇的骨架:最底下的 lane 只管把比特流又快又稳地送过去;物理层在它之上完成训练与协商;数据链路层把「可能出错的比特流」包装成「按序、不丢、不重的报文序列」;事务层才产生软件读得懂的读写事务。下面逐层展开。
二、代际与速率:GT/s 是线速,还要先扣编码开销
规格书上的 2.5、8、64 这类数字,单位是 GT/s(Giga Transfers per second,每秒十亿次传输),描述的是物理引脚上每秒翻转出多少个符号,它本身不是字节带宽。第一道折损来自线路编码:为了让接收端从数据流里恢复时钟、保证 0 和 1 的密度、控制直流平衡,原始比特必须按某种编码规则变换后再送上线,多余的字节就是编码开销。
| 代际 | 线速(每 lane) | 编码方式 | 编码效率 | 单 lane 单方向有效带宽 |
|---|---|---|---|---|
| Gen1 | 2.5 GT/s | 8b/10b | 80% | 约 250 MB/s |
| Gen2 | 5.0 GT/s | 8b/10b | 80% | 约 500 MB/s |
| Gen3 | 8.0 GT/s | 128b/130b | 约 98.46% | 约 985 MB/s |
| Gen4 | 16.0 GT/s | 128b/130b | 约 98.46% | 约 1.97 GB/s |
| Gen5 | 32.0 GT/s | 128b/130b | 约 98.46% | 约 3.94 GB/s |
| Gen6 | 64.0 GT/s | FLIT 模式(PAM4) | 约 96.5% | 约 7.56 GB/s |
读这张表抓住三次编码变化。Gen1/Gen2 采用 8b/10b:每 8 位有效数据编成 10 位符号发出去,20% 的吞吐花在时钟恢复和直流平衡上,所以 2.5 GT/s 对应 2.5 × 0.8 ÷ 10 = 0.25 GB/s,而不是 0.3125。Gen3 起速率翻到 8 GT/s,同时换成 128b/130b:每 128 位数据只加 2 位同步头,开销骤降到约 1.54%,单 lane 有效带宽因此接近 1 GB/s——这就是为什么 Gen2 到 Gen3 线速只提升 60%,有效带宽却接近翻倍。Gen6 再次改道:信号改用 PAM4(一个符号携带 2 位,四电平),并引入固定 256 字节的 FLIT(flow control unit,流控单元)成帧,把 CRC、重传粒度等一起规整进固定格式;表中单 lane 约 7.56 GB/s 是扣除 FLIT 开销后的公开常用值。
实际估算链路总带宽时,把表中数字乘以 lane 数,再按需要乘以 2(收发两个方向同时跑)。例如 Gen3 x16 单方向约 985 MB/s × 16 ≈ 15.8 GB/s。这些是物理层理论有效载荷上限,协议包头、流控、重传和应用本身的效率还会再打折,因此不要把它当成应用层的实测吞吐。曼彻斯特与 NRZI 编码讨论的正是「为什么高速串行链路都要在线路上做编码变换」这一共性问题,8b/10b 与 128b/130b 是同一思路在不同速率档位上的选择。
三、上电自动协商:LTSSM 状态机怎样把线「接通」
两台设备用高速串行线连起来,面临一串冷启动问题:对面到底有没有接设备?比特边界在哪里(没有单独的时钟线,时钟要从数据流里恢复)?多条 lane 有没有接反、接反序?双方共同支持的最高速率和实际可用宽度是多少?PCIe 把这些工作交给一个硬件状态机:LTSSM(Link Training and Status State Machine,链路训练与状态状态机)。整个过程不需要软件参与,CPU 上电后链路自己会跑完。
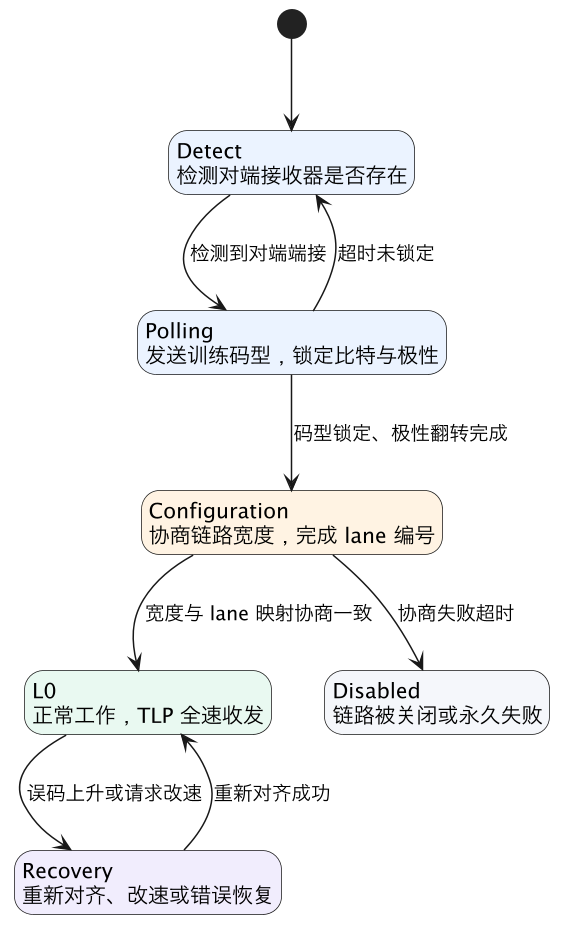
读这张状态机抓住主干和回环。主干是 Detect → Polling → Configuration → L0:Detect 通过检测接收端的端接电阻判断「线的那头有没有人」;Polling 阶段双方反复发送固定训练码型(TS 有序集),接收端借此完成比特锁定、符号锁定,并自动纠正正负线接反的极性翻转;Configuration 阶段为每条 lane 编号、确定链路宽度(比如槽位是 x16 但卡只引出 x8,就在这里收敛成 x8),随后进入 L0 正常工作。回环同样关键:运行中信号质量恶化或软件要求切换速率时,链路退回 Recovery 重新做比特对齐和速率切换,成功后再回 L0;反复失败则可能落入 Disabled。状态机的建模方法本身可参考 有限状态机入门——LTSSM 正是「硬件用状态机管理复杂协商过程」的典型实例。
一个常见疑问是 lane 接反序为什么还能点亮:Configuration 期间训练码型里带 lane 编号,接收端发现物理顺序与逻辑编号不一致时直接做 lane reversal(通道反序)映射,在逻辑上重排即可,不要求走线严格按号入座。速率协商则遵循「双方共同能力取最高」:Gen5 的卡插在 Gen3 的槽上,Polling 总从最低共同速率开始,随后经 Recovery 逐级上调到双方都支持的最高档。这也解释了规格表里「PCIe 向下兼容」在链路层的确切含义。
四、三层协议:TLP、ACK/重传与信用流控各在哪一层
比特可靠送达之后,还需要回答三个问题:数据按什么格式组织成报文,出错了怎么办,接收方来不及收怎么办。PCIe 用三层分工回答,数据在发送端自上而下封装、接收端自下而上解封。
这张分层图里三种颜色对应三类职责:红色事务层生产和消费 TLP(Transaction Layer Packet,事务层报文)。一次内存读在链路上不是一根单独的读信号,而是一个带地址、长度和请求者 ID 的 TLP;对端完成读取后再回一个 Completion TLP 带上数据。写请求通常不需要数据返回,但仍遵循同一套报文格式。配置事务是软件枚举设备的基础,消息事务承载中断(MSI)、电源管理等不带数据的事件。
橙色数据链路层做两件让上层省心的事。第一是可靠交付:每个 TLP 被加上序号和 LCRC 校验后发出,接收端校验通过回 ACK、失败回 NAK;发送方维护重放缓冲区,超时或收到 NAK 就从出错的序号开始重传,上层因此得到一条按序、不丢、不重复的逻辑管道。第二是流控:采用信用(credit)机制,接收方定期通告各类报文还有多少缓冲余量,发送方只在信用足够时发送,从协议上杜绝「发得太快冲爆对端缓冲」。这与数字设计里常见的 FIFO 水位反压解决的是同一类问题,可对照 FIFO 与仲裁器基础理解,只是 PCIe 把信用放进了报文头定期交换。蓝色物理层在最外侧负责成帧(插入帧起始/结束符号)和所有电气层面的工作,前两节的 lane 与 LTSSM 都属于这一层。
| 层次 | 代表性机制 | 对软件是否可见 |
|---|---|---|
| 事务层 | TLP、四类事务、请求与完成配对 | 可见:表现为寄存器读写与中断 |
| 数据链路层 | 序号、LCRC、ACK/NAK、重传、信用 | 不可见:软件只感到链路可靠 |
| 物理层 | 8b/10b 或 FLIT、SerDes、LTSSM | 不可见:只在状态寄存器里留结果 |
分层带来的直接好处是演进独立:Gen3 换编码、Gen6 换 FLIT,几乎只动物理层和数据链路层的成帧细节,软件写设备寄存器的事务层模型从 Gen1 沿用至今。
五、点对点连线为什么长成一棵设备树
PCIe 的每条电气连接严格点对点:一个发送端对一个接收端,没有第三个设备挂在同一对上。那么一颗 CPU 怎样连接十几个设备?答案是两类中间节点。Root Complex(根复合体,通常集成在 CPU 内)是树的根,向下引出若干条链路;Switch(交换器)内部是一条虚拟总线加多个桥,对每个下行口再引出一条独立的点对点链路,形态上就是一个「一进多出」的转发节点。设备(Endpoint,端点)是树叶,比如 NVMe 固态硬盘、显卡、网卡。
读图时把每条边都理解成「独立训练、独立重传」的完整链路:交换器两侧各自是一条独立链路,宽度和速率可以分别协商,某一侧进入 Recovery 不影响另一侧继续工作。Switch 做的事是按 TLP 里的地址和路由 ID 在端口之间存储转发——它在物理拓扑上扩展扇出,在协议上仍然只转发报文,不占用共享介质。这与芯片内部的总线形成对照:片上 AMBA 总线靠主设备仲裁共享一组互连线,可参考 AMBA 总线入门与片上总线;PCIe 则把仲裁换成了交换器里的路由与缓冲,用更多连线换取每个设备独享带宽。
软件看到的树形拓扑正是这一物理事实的投影。上电后软件(BIOS/操作系统)从根复合体出发,对每个可能的总线号、设备号、功能号发送配置读请求;存在设备的位置返回厂商 ID,不存在的位置返回全 1,由此逐端口「走」完整棵树,为每个设备分配总线号空间、设置 BAR(基地址寄存器)把设备寄存器映射进 CPU 物理地址空间。完成枚举后,驱动访问设备就变成普通的内存读写 load/store,由 Root Complex 翻译成 TLP 沿树转发到对应端点。整条链路的 ACK、重传、流控对驱动完全透明——这正是分层设计的目的。
这一篇在知识体系里的位置
本篇属于芯片外部互连与接口概念的入门层:物理介质(差分对、SerDes、信号完整性)向芯片 IO 侧延伸,可读 IO 与焊盘与封装与信号完整性;编码与时钟恢复的共性原理见 曼彻斯特与 NRZI 编码;LTSSM 作为硬件状态机的实例,建模方法见 有限状态机入门;流控信用与片上 FIFO 反压同源,见 FIFO 与仲裁器基础;点对点交换与共享总线的对比可延伸到 AMBA 总线入门与片上总线。后续可在此框架上继续展开 MSI-X 中断、地址转换服务 ATS、电源管理状态 L1/L2 等专题。
总结
PCIe 链路概念可以收成五句话:物理上一条链路由若干 lane 构成,每条 lane 是收发独立的两对差分线,全双工、可并排扩展到 x16;速率规格 GT/s 是线速,真实带宽要先扣编码开销,8b/10b 损耗 20%,128b/130b 仅约 1.5%,Gen6 的 FLIT 配合 PAM4 把单 lane 有效带宽推到约 7.56 GB/s;上电后 LTSSM 状态机自动完成检测、码型锁定、宽度与速率协商,链路异常时经 Recovery 回环恢复;事务层用 TLP 表达读写,数据链路层用序号、CRC、ACK/重传和信用流控把物理比特流变成可靠管道,软件全程无感;每条电气连接都是点对点,靠根复合体和交换器扇出成树,软件枚举得到的设备树就是这张物理拓扑的直接投影。