macro halo 留白:宏单元四周 halo/keepout 宽度怎么定,过宽过窄各付什么代价
更新时间:2026-10-03。floorplan 阶段把 SRAM、PLL、模拟 IP 这些宏单元(macro)摆上 die 之后,紧跟着一个看似不起眼、实则牵一发动全身的决定:每个宏四周留多宽的「禁放带」——也就是 macro halo(也叫 keepout margin)。这条带子里不允许放标准单元,有的工艺口径下连走线都受限。留宽了,面积白烧、绕线变长;留窄了,pin 接不出来、时序被打穿。本篇是 宏单元布局 floorplan 的续篇,那篇讲宏怎么摆,这篇讲摆完之后四周留多少;布线侧的背景见 布线拥塞、DRC 与串扰,pin 侧的背景见 pin 接入与可布线性设计。
本文要回答的问题
- macro halo 到底在防什么,和标准单元之间的普通间距有什么区别?
- halo 宽度由哪三个因素决定:布线资源、时序、pin 密度?
- halo 过宽会付出什么代价,过窄又会引爆哪些问题?
- SRAM、PLL、模拟 IP 的 halo 策略为什么不一样?
- 工程上怎么给出一个可辩护的初始宽度,又靠什么数据迭代收敛?
一、halo 在防什么
宏单元和标准单元不同:它是一个黑盒硬块,边界上密密麻麻伸出成百上千根 pin(一块双口 SRAM 的地址、数据、控制 pin 加起来轻松过百),而且 pin 往往集中在某一两条边上。如果没有 halo,标准单元可以一路摆到宏的边界线上,带来的直接后果是:连接宏 pin 的走线一出 pin 就撞进标准单元区的轨道丛林,局部轨道被宏 pin 的接入线(pin access)和单元自己的信号线双重争抢,拥塞热点几乎必然出现在宏的 pin 密集边。
halo 的作用就是把这片「争抢区」预先腾空:halo 内不放标准单元,轨道资源优先留给宏 pin 的接入和扇出。注意 halo 默认约束的是摆放(placement keepout),走线通常可以穿过——除非显式再叠加 routing blockage。这两个概念经常被混用,但语义不同:placement halo 腾的是「cell 位置」,routing blockage 腾的是「轨道」。大多数情况下前者就够,后者只在模拟宏、PLL 这类对噪声敏感的场合才叠加使用。
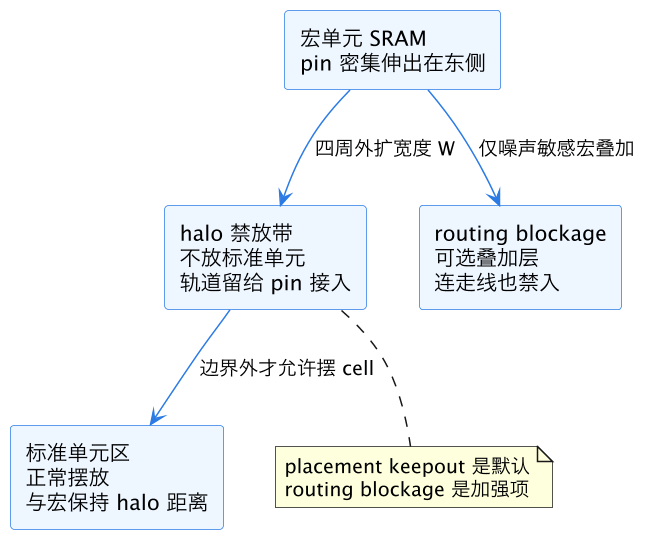
这张图里的关键区分是两条出边:「四周外扩宽度 W」是每个宏都有的默认动作,「仅噪声敏感宏叠加」是少数宏的加强动作。定 halo 宽度 W,本质上就是回答一个问题:这片腾空的区域要多大,才能让布线器舒服地把所有 pin 接出来,又不至于浪费到心疼。
二、三个决定因素:布线资源、时序、pin 密度
第一个因素是 pin 密度,也是最硬的约束。一条边上伸出 N 根 pin,每根 pin 的接入都需要一根垂直于边界的轨道把它「拉」出来,再拐弯进入水平布线层。如果这条边的长度除以 pin 数得到的平均 pin 间距,已经接近甚至小于两层金属的 pitch 之和,那么 pin 接入天然要往外「铺」一段距离才能错开——这段距离就是 halo 宽度的下限。经验做法是先数每条边的 pin 数和 pin 所在层,对最密的那条边做一次纸面演算:pin 数乘以有效 pitch,再打一个接入弯折的系数(1.2 到 1.5),得到的量级往往就是 halo 的起步值。
第二个因素是布线资源。宏本身就是一块巨大的布线障碍(多数宏内部不允许信号线穿越高层以外的层),宏和宏之间、宏和 die 边界之间形成的通道(channel)要承担绕行的全部流量。halo 加宽,等效于把通道也加宽,通道容量上升;但 halo 加宽同时把标准单元区往远处推,全局走线长度整体上升。这两个效应方向相反,拐点在哪里取决于设计的拥塞基线——全局布线拥塞分析 里的密度图是最直接的判据。
第三个因素是时序。宏的接口路径(reg-to-macro、macro-to-reg)天然带有长线延迟,halo 越宽,紧贴宏放置接口寄存器的空间越被挤占,寄存器被迫放得更远,接口路径的第一段和最后一段都在变长。对高频设计,这几十微米的差距就是几十皮秒。反过来,halo 太窄时布线器为了给 pin 接入让路,会在宏边缘制造局部绕线,接口 net 的实际走线反而更长更不可控。
三、过宽与过窄的代价对比
| 维度 | halo 过宽 | halo 过窄 |
|---|---|---|
| 面积 | 直接浪费 die 面积,利用率目标难达成 | 面积省,但可能是假省 |
| 布线 | 通道宽敞,拥塞低,但全局线长变长 | 宏 pin 边局部拥塞,DRC 热点集中 |
| 时序 | 接口寄存器被推远,接口路径变长 | 局部绕线不可控,接口 net 延迟反而恶化 |
| 可修复性 | ECO 阶段空间充裕 | 后期想加宽等于重新 floorplan |
| 功耗 | 线长增加带来动态功耗上升 | 绕线和重驱动 buffer 也在吃功耗 |
这张表里最值得注意的是最后一行的对称性:过宽和过窄都在功耗上收税,只是收税的位置不同——一个收在线长上,一个收在修复上。所以 halo 不是「越保险越宽」的问题,而是有明确最优区间的权衡问题。两条红线值得记住:过窄的代价在流程后期才爆(详细布线阶段 DRC 修不动,见 详细布线 DRC 收敛),返工成本是 floorplan 阶段调参的几十倍;过宽的代价则在面积和时序报表里天天可见,但因为「不报错」,反而容易被忽略。
四、不同宏类型的差异化策略
一刀切的全局 halo 是最常见的偷懒做法。实际上不同类型的宏该区别对待。
SRAM 是 pin 密度最高、但电气上最「皮实」的宏:数字接口、内部自带屏蔽,不怕噪声。策略是 halo 按 pin 密集边的演算值给,通常几微米到十几微米量级,非 pin 边可以收窄甚至贴邻(abut)——多块同型号 SRAM 的非 pin 边对拼,能省出可观的通道面积,这也是 通道式与拼接式层次 floorplan 里 abutted 风格的典型用法。
PLL 和模拟 IP 相反:pin 不多,但对噪声极度敏感。这类宏的 halo 不是为布线腾资源,而是为隔离腾距离——halo 内通常还要叠加 routing blockage,防止高速数字信号从头顶穿过注入衬底噪声,四周还常配 guard ring 和专用的 welltap 与 endcap 规则。宽度取值来自 IP 厂商的集成手册,常见是几十微米,且没有讨价还价的余地。
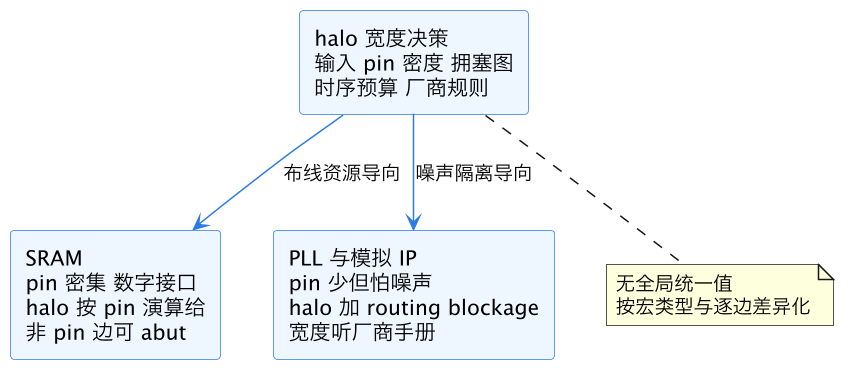
这张图想强调的只有一点:halo 宽度的决策入口是同一个(pin 密度、拥塞、时序、厂商规则四路输入),但出口按宏类型分成两条完全不同的逻辑——SRAM 在跟布线资源讨价还价,PLL 在跟噪声隔离买平安。把 PLL 的宽度套到 SRAM 上是浪费,把 SRAM 的宽度套到 PLL 上是事故。
五、工程上怎么定初值、怎么迭代
一个可辩护的落地流程是四步。第一步,收集硬约束:IP 厂商手册里的最小 keepout、工艺库的 endcap/welltap 规则、宏 pin 所在层与每层 pitch。第二步,对每块宏逐边做 pin 密度演算,取各边最大值作为该宏的初始 halo,非 pin 边直接砍半或清零(允许 abut 的话)。第三步,跑一版带初始 halo 的快速布局和全局布线,看三张图:宏边缘的拥塞密度图、接口路径的时序报告、面积利用率。拥塞热点贴在宏 pin 边上就局部加宽,接口路径时序吃紧且寄存器被 halo 推远就收窄配合 布局 guide/region/fence 把接口逻辑钉在宏旁边。第四步,冻结 halo 进 signoff 流程,后续只通过 ECO 级别微调——这个阶段再动 halo,等于推倒半个 floorplan,代价见 数据流 S3:floorplan 与布局阶段 里对迭代成本的讨论。
还有一个小动作值得养成习惯:halo 参数写进 floorplan 的约束脚本而不是 GUI 里手点,每次调整留版本记录。三个月后问「这块 SRAM 为什么留 8 微米」时,脚本里的注释比记忆可靠得多。
总结
macro halo 留白是在宏单元四周划出禁放标准单元的隔离带,核心作用是把宏 pin 密集边的轨道资源预留给 pin 接入、给噪声敏感宏买隔离距离;宽度由 pin 密度(定下限)、布线资源与通道容量(定平衡点)、接口时序(定上限)三路约束共同决定,过窄的代价在详细布线阶段以 DRC 热点形式爆发、返工极贵,过宽的代价则 silently 烧面积和接口时序;工程上应按宏类型差异化取值——SRAM 按 pin 演算、非 pin 边可 abut,PLL 与模拟 IP 听厂商手册并叠加 routing blockage——再靠拥塞图、接口时序、利用率三张报表迭代收敛,且把参数固化在约束脚本里。