NoC 虚拟通道 QoS:VC 防死锁、路由器分配与 AXI QoS 映射
更新时间:2026-09-28。本篇是「集成电路大类 · 芯片设计 · 片上互连」序列里承接 NoC 基础与 QoS 实战的深文。NoC 拓扑与路由器流水的基础建议先读 NoC 片上网络与路由器,拓扑选型与死锁总论见 NoC 拓扑、QoS 与死锁,AXI 侧 QoS 语义见 AXI4 QoS 服务质量。本篇聚焦一个问题:虚拟通道(Virtual Channel,VC)这一资源怎么同时扛起「防死锁」和「QoS 分级」两副担子,以及 SoC 集成时 AXI 的 QoS 信号在 NoC 边界上怎么翻译。
本文要回答的问题
- 虚拟通道为什么能用一套物理链路同时实现死锁避免和流量隔离?
- 路由器内部 VC 分配器(VA)与开关分配器(SA)各做什么,流水节拍怎么排?
- 消息类依赖链怎么形成死锁环,用 VC 分层怎么破?
- QoS 分级在 NoC 内靠什么落地:严格优先级、加权轮询还是带宽预留?
- AXI 的 4 位 QoS 值进入 NoC 时如何映射到 VC 与仲裁权重,映射表怎么设计?
一、虚拟通道到底是什么
物理链路只有一组线,但不同流量想互不阻塞地走它,办法是在链路两端各放几组独立的缓冲队列,让多个「逻辑通道」分时复用同一条物理线。每一组这样的缓冲加状态就是一个虚拟通道:它有自己的 flit 缓冲、自己的信用计数、自己的分配状态,但出线时和其他 VC 共用物理总线。
v0: "VC0 缓冲\n(请求类)"
v1: "VC1 缓冲\n(响应类)"
v2: "VC2 缓冲\n(低优先级数据)"
va: "VC 分配器 VA"
sa: "开关分配器 SA"
link: "物理链路"
v0 -> va: 请求 VC
v1 -> va: 请求 VC
v2 -> va: 请求 VC
va -> sa: 已分配 VC 的 flit
sa -> link: 逐 flit 轮转出
上图是一个输入端口的最小结构:三个 VC 各自排队,VA 负责给「排在队首的报文」分配下游 VC,SA 负责在已获分配的 VC 之间逐 flit 选择谁占用物理线。这里有一个常被忽视的分工:VA 以报文为单位工作(一个报文从头到尾占用同一个下游 VC),SA 以 flit 为单位工作(每个拍都可能换一个 VC 上线)。VC 数不是越多越好——每多一个 VC,缓冲面积、VA 的组合逻辑规模、信用回传信号都线性增长,主流 NoC 在 2 到 8 个 VC 之间取舍,缓存一致性网格常用 4 个(按消息类划分),流量分级型 NoC 常用 2 到 4 个(按优先级划分)。
VC 的价值有两个方向:其一,解耦等待——被下游堵住的报文只占住自己的 VC 缓冲,不堵住物理线,别的 VC 的 flit 还能穿过去,这是吞吐层面的收益;其二,打破依赖环——不同消息类走不同 VC,资源依赖图上就没有环,这是正确性层面的收益。前者是性能,后者是死活。
和另一个常见方案「多物理网络」对比能看清 VC 的定位:直接铺两套物理链路同样能隔离请求与响应,而且隔离更彻底,但连线资源、布线拥塞和功耗全部翻倍,在先进工艺里布线是比逻辑更稀缺的资源。VC 用少量片上存储换掉大量全局布线,这正是它成为主流的原因。反过来,VC 也有替代不了物理隔离的场景:功能安全要求 ASIL-D 流量与 QM 流量之间无干扰证明时,审计方往往不接受「共享物理线、靠仲裁隔离」的论证,只能上物理隔离或带时间触发的 TSN 式调度。选型时先问「要的是性能隔离还是安全隔离」,两者答案不同。
二、路由器流水线与 VC 分配
经典虚通道路由器一拍干四件事,工程上流水化成四级:路由计算(RC)、VC 分配(VA)、开关分配(SA)、开关穿越(ST),再加链路穿越(LT)。
头 flit 到队首后先算输出端口(RC),然后向 VA 申请该端口上的一个空闲下游 VC;VA 本质是一个两轮仲裁:先在同一输入端口内各 VC 的请求间选一,再在同一输出端口的所有申请者间选一,构成一个输入×输出的分配矩阵。拿到 VC 后,报文的每个 flit 每一拍都参加 SA:各输入端口已就绪的 flit 竞争交叉开关时隙。体 flit 跳过 RC 和 VA,直接走 SA/ST,所以长报文的稳态开销主要在 SA 仲裁上。
性能优化常见的三招值得记住。一是旁路(look-ahead routing):下一跳的路由在上一跳就算好,RC 与 ST 重叠,流水压到三拍甚至两拍。二是推测分配:VA 与 SA 并行做,赌 VA 能赢,输了再回退,低负载时单拍穿路由器。三是VC 选择先行:报文到达前先按消息类预选 VC 子集,缩小 VA 矩阵。这三招都不改协议语义,验证环境应把它们当微架构自由度处理——延迟可以变,flit 顺序与 VC 归属不可变。
三、用 VC 破死锁:消息类分层
死锁的充要条件是资源依赖图上有环。片上网络里最典型的环来自协议级依赖:A 核发出请求占着请求通道资源,等响应;而响应要穿过网络回来,但网络里全是别人的请求,请求又在等它们各自的响应——请求等响应、响应等请求穿过被请求占满的路由器,闭环形成,全网格冻死。
解法是 Dally 的消息类分层:给每个协议消息类分一个独立 VC,并规定报文只能从小编号 VC 流向大编号 VC(或反之),绝不允许反向。上图四条 VC 按请求→监听→响应→应答排成一条单向链,依赖图变成 DAG(有向无环图),数学上不存在环,死锁被结构性排除。ARM 的 CHI 网格、Arteris 与 NetSpeed 系 NoC 都用这个套路,只是消息类的数量与名字不同。CHI 侧的四通道划分可对照 AMBA CHI 通道与网格:REQ/SNP/RSP/DAT 四类天然对应四个 VC。
工程落地时还有两条细则。第一,协议转换点要改 VC:报文在中继节点从请求类「升级」成响应类时,必须在出口队列换到高层 VC 缓冲,不能带着旧 VC 号继续走,否则分层被破坏。第二,转义通道兜底:即使分层设计无误,配置错误(比如软件把某笔流量的 QoS 打到错误的 VC 组)仍可能成环,不少商用 NoC 额外保留一个「转义 VC」,全网周期性排空到它上面作为最后手段,配合超时看门狗报警。这两点在 NoC 拓扑、QoS 与死锁 的逃生通道章节有更深的展开。
四、QoS 分级在 NoC 内怎么落地
防死锁解决「不卡死」,QoS 解决「谁优先」。NoC 里做 QoS 的抓手有三个,常组合使用:
| 机制 | 作用点 | 粒度 | 优点 | 代价 |
|---|---|---|---|---|
| VC 按优先级分组 | VA/SA 仲裁 | 报文类 | 硬隔离,低优先级完全不挡路 | VC 数翻倍,面积贵 |
| 仲裁器加权 | SA 逐 flit | flit | 带宽按比例分,可调 | 只能保证比例,不保证延迟上界 |
| 信用/速率整形 | 源端注入 | 报文 | 限制单个 master 注入速率,防爆冲 | 需要配置寄存器与监管逻辑 |
严格优先级适合「实时流量绝不能等」的场景:显示控制器扫帧、音频 DMA,错过期限就是肉眼可见的花屏或爆音。这类流量独占一个高优先级 VC,SA 仲裁永远先选它。加权轮询(WRR)适合「大家都要带宽但比例不同」的场景:给每个源的仲裁权重按带宽需求配,比如 GPU 权重 4、CPU 权重 2、外设权重 1。带宽预留(guaranteed service)则是源端整形加端到端 VC 预留的组合,常见于需要延迟上界证明的汽车与工业芯片。
rt: "实时流 (显示/音频)\nVC_hi 严格优先"
bw: "带宽流 (GPU/CPU)\nVC_mid 加权轮询"
bg: "后台流 (外设/日志)\nVC_lo 尽力而为"
arb: "SA 仲裁器\n先查 VC_hi\n再按权重选 VC_mid\n最后 VC_lo"
link: "物理链路"
rt -> arb
bw -> arb
bg -> arb
arb -> link上图是三层优先级分层的典型结构。要点在于优先级与防死锁分层是两套独立维度:消息类 VC 分层保证无环,优先级分层决定谁先走,两者可以在同一个 VC 编号空间里编码(高 2 位是消息类、低位是优先级),也可以分别用不同资源池实现。混在一起编码省 VC 但验证状态空间爆炸,分开实现好验证但费缓冲——面积与验证成本之间的经典权衡。
五、AXI QoS 信号到 NoC 的映射
AXI4 给每笔读写事务带一个 4 位 QoS 值(AWQOS/ARQOS),0 最低、15 最高,协议本身不规定语义,只说互联「应当」据此做优先级决策。这个语义真空由 NoC 在边界上填补:每个 AXI 主接口挂的 NoC 入口(NIU,网络接口单元)里有一张 QoS 映射表,把 4 位 QoS 值翻译成内部 VC 号与仲裁权重。
设计映射表时四条经验。第一,映射是可配寄存器而非写死:同一颗芯片在消费场景和车载场景的分级策略不同,流片后还要能调。第二,QoS 值在穿越 NoC 时通常单调不降或不透明传递:入口把 QoS 编码进 flit 侧带(类似 AXI-Stream 的 TUSER 思路),出口再还原给下游 AXI slave,全链路语义一致;NoC 内部仲裁用的是翻译后的 VC/权重,与原始 QoS 值解耦。第三,注意与事务 ID 顺序规则的交互:同 ID 事务必须保序,QoS 只能影响不同 ID 之间的先后,NIU 不能让高 QoS 的同 ID 事务插队到低 QoS 的同 ID 事务前面,否则违反 AXI 协议。ID 与 QoS 仲裁的完整交互见 事务 ID 与 QoS 仲裁。第四,防饿死:严格优先级下低 QoS 流量理论上可以永远等,工程上要加老化机制——等待超过阈值的报文自动升一级优先级,阈值可配。
验证侧的覆盖点围绕映射表展开:每个 QoS 档位 × 每个流量源的组合至少打到一次;高优先级流压满时统计低优先级流的最大等待拍数,确认老化机制生效;随机翻转 QoS 映射表寄存器,确认路由与顺序语义不受影响。完整 SoC 级别的 QoS 联调案例可对照 SoC 互连案例研究。
六、信用流控与端到端延迟分析
VC 缓冲不是无限的,相邻路由器之间用信用(credit)流控:下游每有一个空缓冲槽就持有一个信用,上游发一个 flit 消耗一个信用,下游释放缓冲后回传信用。信用回传本身就是一拍级延迟,高速 NoC 里这段回传延迟决定每个 VC 至少要有多少槽位才能跑满带宽——经典结论是槽位数 ≥ 链路往返拍数 + 1,少了就会在满带宽下空转等信用。
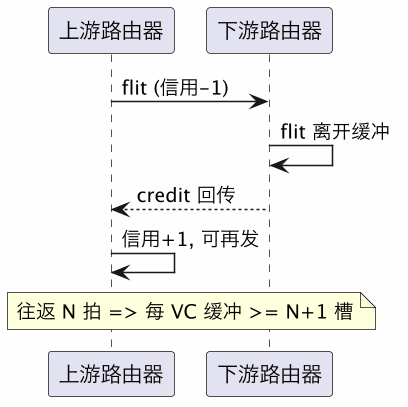
QoS 与流控的交叉点有一个隐蔽的坑:信用是按 VC 独立计的,高优先级 VC 缓冲被占满时,即使物理链路空闲,该 VC 的 flit 也发不出去,这时低优先级 VC 照常走——这正是 VC 隔离的价值,但也意味着「高优先级」不等于「永不阻塞」,只是阻塞时优先被服务。做端到端延迟预算时,要把每跳的 VA 等待、SA 竞争、信用等待三项分开建模,其中 SA 竞争是唯一直接受 QoS 权重影响的项;实时流量的延迟上界证明通常假设最高优先级 VC 永不因低优先级流量增加等待,这个假设成立的前提恰恰是 VC 隔离做得干净。
落地阶段建议给每类 VC 单独配缓冲深度而不是平均分配:高优先级 VC 承载的是延迟敏感的短报文,槽位够覆盖往返即可;带宽型 VC 承载长突发,深缓冲才能扛住下游瞬时拥塞不掉速。实测里常见的错误配置是把所有 VC 深度设成一样,结果带宽型 VC 在重载下因信用断供吞吐腰斩,而高优先级 VC 空着一半槽位浪费面积。配合性能计数器统计各 VC 的信用归零拍占比,能很快定位是哪一类缓冲配浅了——这个计数器也应该写进验证环境的断言里,归零占比异常升高时直接报错。
落地时还有一个配置实例可以参考:某视频 SoC 把显示控制器的实时读流量固定映射到最高优先级 VC,CPU 一致性流量走中档 VC,DMA 后台搬运走低档 VC,QoS 寄存器在上电初始化阶段由启动代码一次性写入,运行期不再动态改。静态映射的好处是行为可预期、验证可以按 VC 分层定向加压;动态改优先级看似灵活,但改的瞬间在途事务的归属会带来新的验证维度,除非有明确的带宽动态调配需求,一般不建议开这个口子。
这一篇在知识体系里的位置
向上承接 NoC 片上网络与路由器 的路由器基础与 NoC 拓扑、QoS 与死锁 的拓扑视角;横向语义来源是 AXI4 QoS 服务质量 与 事务 ID 与 QoS 仲裁;消息类分层的协议对照见 AMBA CHI 通道与网格;系统级落地看 SoC 互连案例研究。
总结
NoC 虚拟通道 QoS 的核心是「一套物理链路、多组独立缓冲」:VC 按消息类分层让依赖图成 DAG、结构性排除协议级死锁;路由器内 VA 以报文为单位分 VC、SA 以 flit 为单位争时隙,旁路与推测分配压缩流水;QoS 分级靠优先级 VC、加权仲裁与源端整形三件套落地,严格优先级须配老化防饿死;AXI 的 4 位 QoS 值在 NIU 边界经可配映射表翻译成内部 VC 与权重,全程保持同 ID 保序语义;信用流控按 VC 独立计数,每 VC 缓冲槽数须覆盖链路往返拍数——VC 数就是面积、死锁免疫力与 QoS 分辨率三方博弈的旋钮。